
AI 爬虫 robots.txt 新标准解读:OpenAI 支持统一训练偏好信号,网站站长如何配置?
2026 年 10 月 30 日,OpenAI 宣布支持通过 robots.txt 表达统一的 AI 模型训练偏好,减少网站分别管理多个 AI 爬虫的复杂度。本文解析 IETF AI Preferences、GPTBot、OAI-SearchBot、SEO 影响及站长配置建议。
目录 · 20 节
- 一、OpenAI 宣布支持统一 AI 训练偏好信号
- 二、为什么 AI 爬虫管理越来越复杂?
- 三、robots.txt 是什么?
- 四、OpenAI 当前有哪些爬虫?
- GPTBot
- OAI-SearchBot
- ChatGPT-User
- 五、如何区分 AI 训练和 AI 搜索?
- 六、IETF AI Preferences 工作组在做什么?
- 七、现在是否应该立即修改 robots.txt?
- 八、网站站长的实用配置示例
- 九、如何检查网站的 robots.txt?
- 十、AI 爬虫规则会影响 SEO 吗?
- 十一、内容网站应该如何制定 AI 爬虫策略?
- 内容可见性
- 内容授权
- 安全与性能
- 十二、AI 内容授权未来会如何发展?
- 十三、常见问题 FAQ
- 十四、总结
一、OpenAI 宣布支持统一 AI 训练偏好信号
2026 年 10 月 30 日,OpenAI 发布公告,宣布支持一种通过 robots.txt 表达 AI 模型训练偏好的共享信号。
这一变化主要面向网站站长、内容发布者和网络服务运营者。
随着生成式 AI 发展,越来越多的 AI 服务需要访问公开网页,用于搜索、信息检索或模型训练。
但不同 AI 公司可能使用不同的爬虫和访问规则。
对于网站运营者来说,如果希望管理这些访问行为,往往需要分别研究不同厂商的爬虫标识和配置方式。
OpenAI 支持的共享信号,旨在让网站能够通过更统一的方式表达其内容是否可用于基础生成式 AI 模型训练。
不过,必须强调:这是一项自愿采用的标准化努力,并不意味着全球所有 AI 公司已经统一执行同一规则。
OpenAI 在公告中表示,计划在未来数月实施这一信号,并将在实施时提供进一步说明。
因此,2026 年 10 月 30 日是支持该方向的公告日期,而不是所有新规则已经正式生效的日期。
二、为什么 AI 爬虫管理越来越复杂?
传统搜索引擎爬虫的主要任务是发现网页、建立索引并支持搜索结果展示。
生成式 AI 的发展使网页访问出现更多用途。
例如:
- 为搜索引擎建立网页索引。
- 为 AI 搜索获取信息。
- 为模型训练收集公开数据。
- 为用户请求进行实时网页检索。
这些用途并不完全相同。
网站运营者可能愿意让搜索引擎索引文章,却不希望相同内容被用于训练基础模型。
也可能允许 AI 搜索访问公开内容,但希望限制特定自动化抓取行为。
因此,仅使用一个笼统的“允许 AI”或“禁止 AI”开关,未必能够表达网站的真实意愿。
更细粒度的用途区分,是 AI 爬虫管理的重要发展方向。
三、robots.txt 是什么?
robots.txt 是网站根目录下用于向自动化爬虫表达访问规则的文本文件。
例如:
https://example.com/robots.txt传统 robots.txt 规则通常包含 User-agent、Allow 和 Disallow 等指令。
例如:
User-agent: *
Disallow: /admin/
这表示网站希望适用的爬虫不要访问 /admin/ 路径。
但 robots.txt 并不是身份认证或网络访问控制系统。
遵守规范的爬虫通常会参考其中的规则,但恶意程序可以忽略这些指令。
因此,robots.txt 不能用于保护真正敏感的数据。
后台管理页面、私有文件和用户资料仍应通过身份认证、访问控制和服务器安全机制保护。
四、OpenAI 当前有哪些爬虫?
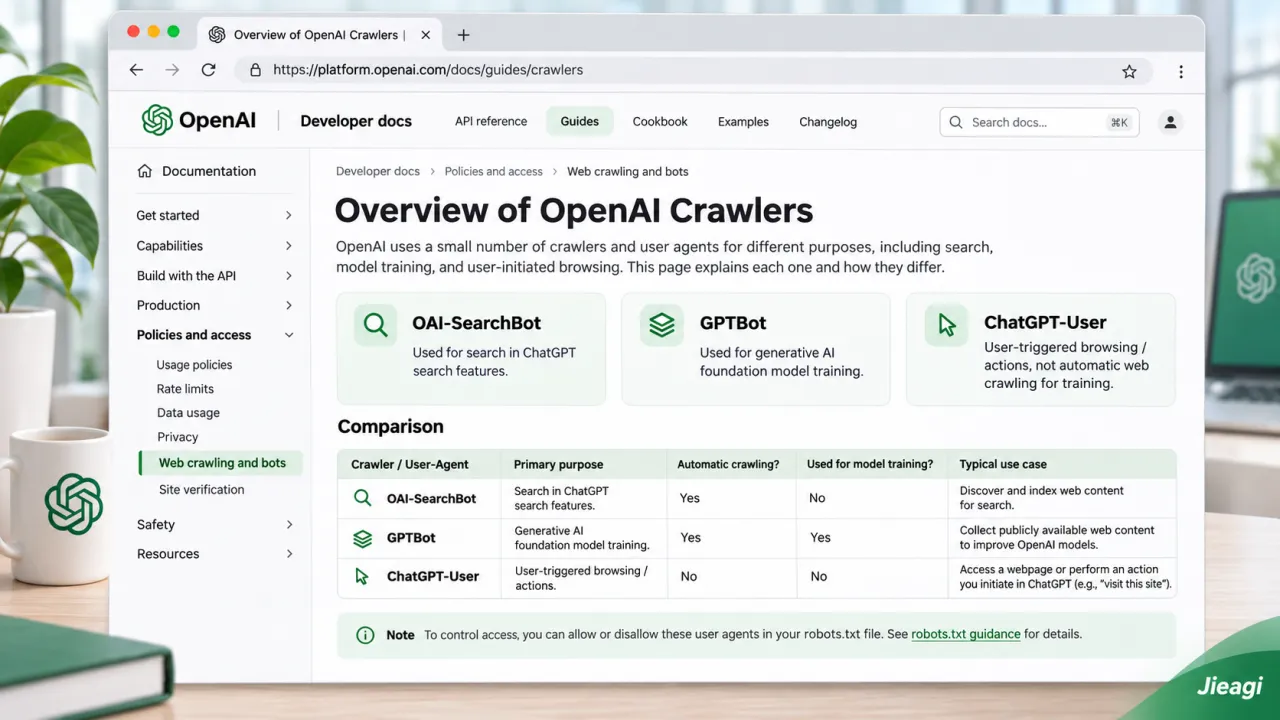
OpenAI 官方文档区分了不同用途的爬虫。
其中值得关注的是 GPTBot、OAI-SearchBot 和 ChatGPT-User。
GPTBot
GPTBot 与 OpenAI 的模型训练相关网页抓取活动有关。
网站可以通过 robots.txt 表达对 GPTBot 抓取行为的偏好。
例如:
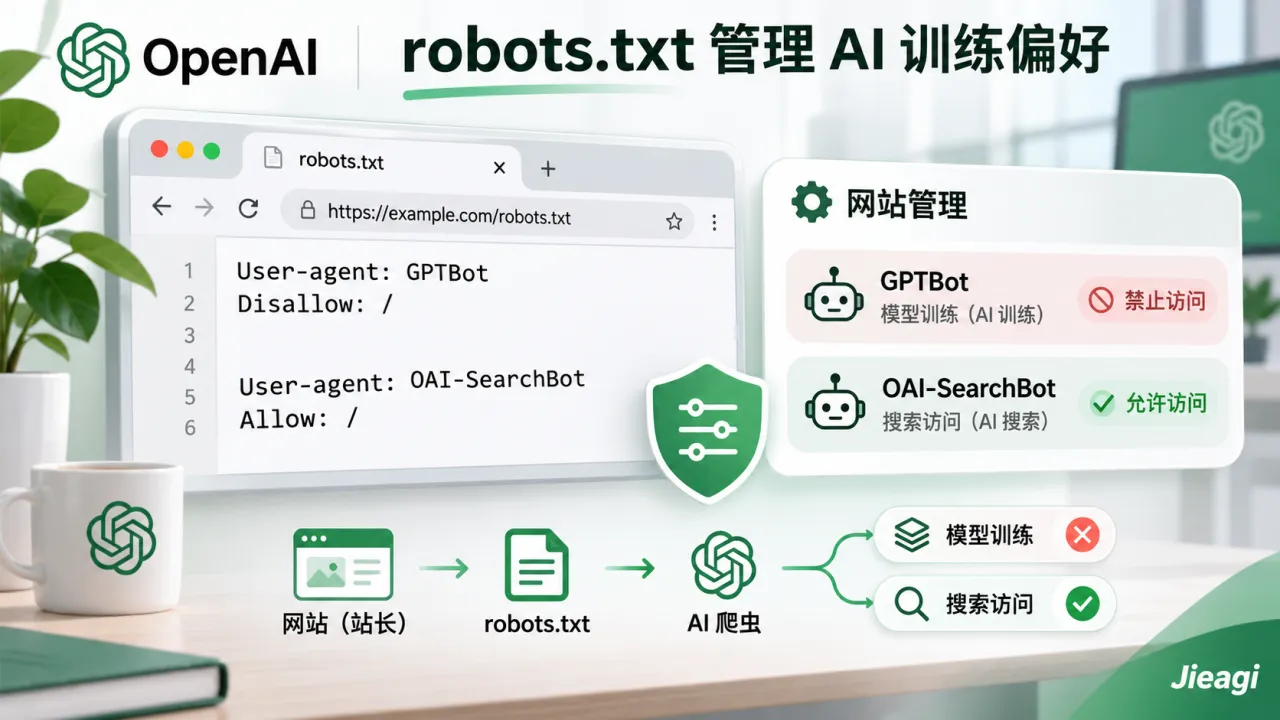
User-agent: GPTBot
Disallow: /
该示例表示不希望 GPTBot 抓取网站页面。
OAI-SearchBot
OAI-SearchBot 用于 OpenAI 搜索相关的网页发现与访问。
网站可以单独管理其访问规则。
例如:
User-agent: OAI-SearchBot
Allow: /
这一规则表达允许该爬虫访问网站的意愿。
ChatGPT-User
ChatGPT-User 与用户主动触发的部分网页访问场景有关。
它与自动化训练爬虫的用途不同。
网站运营者应根据 OpenAI 官方爬虫文档理解不同 User-agent 的具体作用。
不能将所有来自 OpenAI 的网页访问都视为模型训练行为。
五、如何区分 AI 训练和 AI 搜索?
这是此次标准化讨论中最重要的问题之一。
模型训练通常涉及利用数据改进模型能力。
AI 搜索则可能在用户发起查询时访问网页,帮助生成具有来源依据的回答。
两者的目的、技术流程和数据处理方式不同。
因此,网站希望限制模型训练,不一定意味着希望退出 AI 搜索。
例如,一个科技资讯网站可能希望文章继续出现在搜索结果中,同时对训练用途表达不同偏好。
这需要依赖厂商提供的具体控制机制。
但必须注意:允许某个搜索爬虫访问,并不能保证网站一定被搜索结果收录,也不能保证一定被 AI 回答引用。
搜索可见性仍受到内容质量、索引机制、网站技术状态和其他因素影响。
六、IETF AI Preferences 工作组在做什么?
OpenAI 表示,此次共享信号的推进与互联网工程任务组 IETF 的 AI Preferences 工作组有关。
IETF 是制定和讨论互联网技术标准的重要组织。
AI Preferences 的目标之一,是探索如何让内容提供者以更清晰、可互操作的方式表达 AI 使用偏好。
如果不同 AI 服务商能够支持相同的信号,网站运营者就不必为每家服务商维护完全不同的规则。
不过,标准讨论、厂商承诺和正式实施是三个不同阶段。
即使某家公司公开支持某种方案,也不意味着其全部产品和爬虫已经完成技术适配。
因此,站长应以正式发布的规范和厂商实施文档为准。
七、现在是否应该立即修改 robots.txt?
对于普通网站,不建议仅根据一条新标准公告就直接替换现有 robots.txt 文件。
原因有三个。
首先,OpenAI 在 10 月 30 日公告中表示,共享信号仍将在未来数月实施。
其次,不同 AI 厂商可能处于不同的适配阶段。
第三,robots.txt 的错误配置可能影响搜索引擎或其他正常爬虫。
更合理的做法是先检查现有规则,再根据网站运营目标决定是否调整。
尤其不要把尚未确认正式实施的新指令直接加入生产配置,并假定所有 AI 爬虫都会遵守。
八、网站站长的实用配置示例
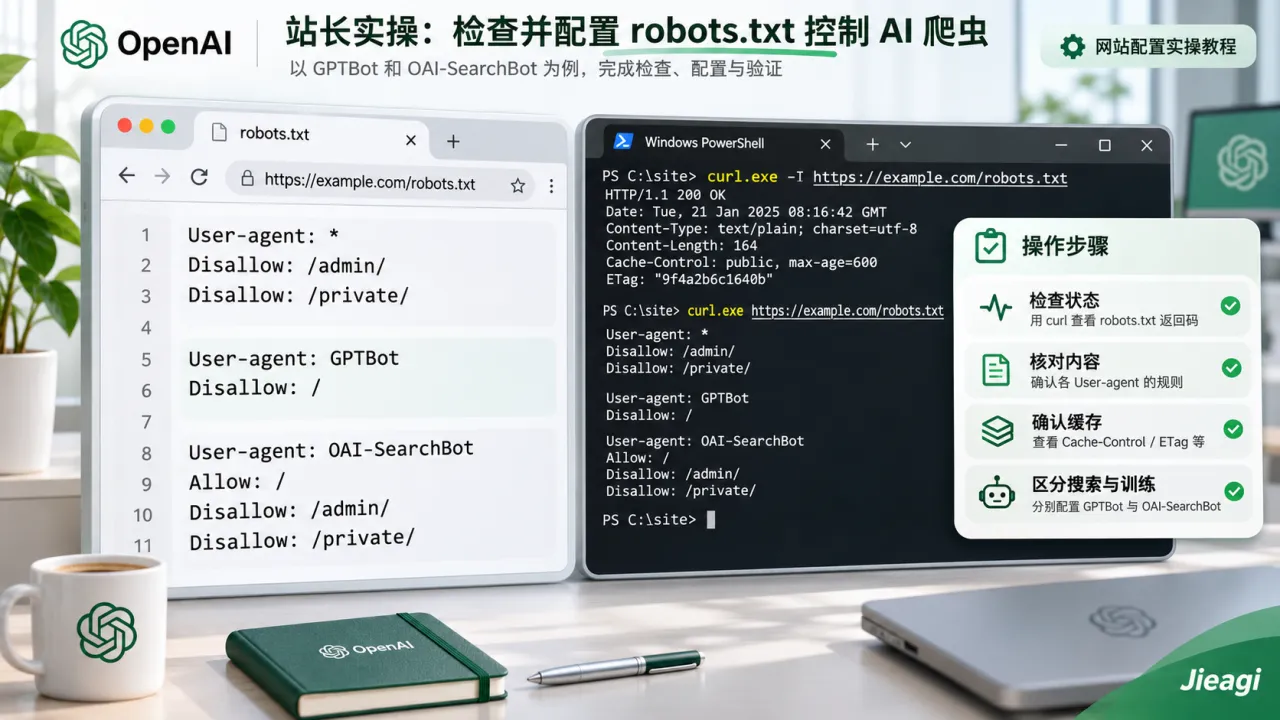
以下示例采用已有的 User-agent 规则,用于说明不同爬虫可以分别管理。
假设一个网站希望允许普通搜索引擎访问公开文章,同时表达不希望 GPTBot 抓取的偏好:
User-agent: *
Disallow: /admin/
Disallow: /private/

User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /
Disallow: /admin/
Disallow: /private/
这个示例并不是所有网站都应该照搬的标准模板。
实际部署时还需要检查:
- 网站是否存在其他敏感路径。
- 是否需要限制特定文件类型。
- 现有搜索引擎规则是否会受到影响。
- 是否存在 CDN 或反向代理缓存。
- 对应爬虫是否支持并遵守这些规则。
此外,示例中的 /admin/ 和 /private/ 只是路径说明。
真正敏感的数据不能只依赖 robots.txt 保护。
九、如何检查网站的 robots.txt?
站长可以直接访问:
https://你的域名/robots.txt如果使用 Windows PowerShell,可以执行:
curl.exe -I https://你的域名/robots.txt这可以检查 HTTP 响应状态。
如果需要查看实际内容:
curl.exe https://你的域名/robots.txt正常情况下,文件应能通过公开 URL 获取。
但 HTTP 200 只说明资源可以访问,不代表其中所有规则都正确。
修改后还应检查实际内容,并确认服务器、CDN 和缓存层没有返回旧版本。
十、AI 爬虫规则会影响 SEO 吗?
可能会,但需要区分影响路径。
如果网站禁止某个搜索爬虫访问,就可能影响该服务发现和使用网站内容的能力。
如果仅限制模型训练用途,是否影响搜索可见性则取决于具体厂商的技术实现和规则区分。
因此,不能简单宣称:
“禁止 AI 训练就会失去全部 AI 搜索流量。”
同样,也不能宣称:
“允许 AI 训练就一定能获得更多搜索排名。”
目前没有充分依据支持这类绝对结论。
对内容网站来说,更重要的是明确自己的运营目标。
例如,希望获取搜索流量的网站,应优先确保正常搜索索引功能不受影响。
希望限制训练用途的网站,则应使用相关厂商正式支持的控制方式表达偏好。
十一、内容网站应该如何制定 AI 爬虫策略?
对于 AI 科技资讯、教程和知识型网站,可以考虑三个方面。
内容可见性
网站是否希望公开文章被传统搜索引擎和 AI 搜索发现?
如果希望获得更多自然流量,就需要保持合理的抓取和索引策略。
内容授权
网站是否希望对模型训练用途进行限制?
如果存在相关要求,应关注不同厂商的正式规则和标准进展。
安全与性能
AI 爬虫可能增加网站访问量。
对于资源有限的网站,应结合服务器日志分析爬虫请求频率、带宽消耗和异常访问行为。
必要时可以使用反向代理限流、缓存和访问控制。
但不要把所有 AI 爬虫一概视为恶意流量。
十二、AI 内容授权未来会如何发展?
OpenAI 支持统一训练偏好信号,反映出内容发布者与 AI 服务商之间正在形成新的技术协调需求。
未来可能出现更加细分的内容使用偏好。
例如,网站希望允许搜索索引,但对基础模型训练表达不同意愿。
不过,这类标准的实际效果仍取决于厂商采用情况、技术实现和法律环境。
robots.txt 本质上是一种机器可读取的偏好表达机制,而不是完整的版权许可合同。
对于商业内容授权、付费数据库或受保护作品,网站仍需要结合合同、版权和其他法律措施管理使用权限。
十三、常见问题 FAQ
OpenAI 在 10 月 30 日宣布了什么?
宣布支持通过 robots.txt 表达统一的 AI 模型训练偏好信号,并计划在未来数月实施。
这个标准已经全面生效了吗?
不能这样理解。公告发布时仍处于厂商实施推进阶段。
GPTBot 和 OAI-SearchBot 是同一个爬虫吗?
不是。两者具有不同用途,应参考官方文档分别管理。
禁止 GPTBot 会导致 Google 搜索无法收录吗?
针对 GPTBot 的规则并不直接等同于禁止 Google 搜索爬虫,但仍应检查完整 robots.txt 配置。
robots.txt 能保护网站后台吗?
不能。后台和敏感文件需要真正的访问控制。
网站应该允许还是禁止 AI 爬虫?
没有适用于所有网站的统一答案,应根据内容授权、搜索流量和服务器资源等目标决定。
十四、总结
OpenAI 支持统一 AI 训练偏好信号,是网站内容治理领域的一项值得关注的进展。
随着 AI 搜索和生成式模型发展,网站运营者需要更加清楚地区分内容索引、实时检索和模型训练等不同用途。
统一信号有望降低多厂商规则管理的复杂度,但实际效果仍取决于标准成熟度和服务商实施情况。
对于站长而言,现阶段最重要的是理解现有爬虫规则、明确内容使用偏好,并在正式技术规范成熟后审慎调整生产配置。
官方参考来源
OpenAI — Making it easier for websites to express AI training preferences https://openai.com/index/helping-websites-express-ai-training-preferences/
OpenAI — Crawlers https://developers.openai.com/api/docs/bots
IETF — AI Preferences Working Group https://datatracker.ietf.org/wg/aipref/about/
本文基于 2026 年 10 月 30 日 OpenAI 官方公告撰写。共享训练偏好信号的最终语法、适用范围及实施情况,应以正式规范和厂商后续文档为准。
关注 AI 前沿动态,分享模型、工具与实战教程。
暂无评论