
2026 AI Agent记忆开源选型与实战:Mem0等10大项目横评
基于2026年11月20日GitHub API实测数据,深度解析Mem0(69,253 Stars)、Cognee、Graphiti、Supermemory等十大开源AI Agent记忆仓库,附带Python接入代码与3个高频踩坑排查方案。
目录 · 12 节
- 2026 AI Agent 记忆开源方案实战与选型:Mem0、Cognee、Graphiti 与 10 大项目指南
- 一、2026 年 11 月 GitHub 开源 Agent 记忆 Top 10 实测榜单
- 二、快速判断:什么时候用 RAG,什么时候必须上 Agent 记忆?
- 选型五问快速决策
- 三、实战上手:以 Mem0 开源版为例构建跨会话记忆
- 1. 环境安装与初始化
- 2. 最小可运行记忆闭环(写入、更新与按作用域检索)
- 四、生产环境 3 个高频踩坑与排查指南
- 坑 1:照搬开源库跑分,上线后发现检索准确率远低于 README 宣称
- 坑 2:照旧教程部署 Letta(原 MemGPT)报 V1 API 废弃或模块找不到
- 坑 3:多 Agent 共享记忆库导致“张冠李戴”甚至越权泄露
- 常见问题(FAQ)
2026 AI Agent 记忆开源方案实战与选型:Mem0、Cognee、Graphiti 与 10 大项目指南
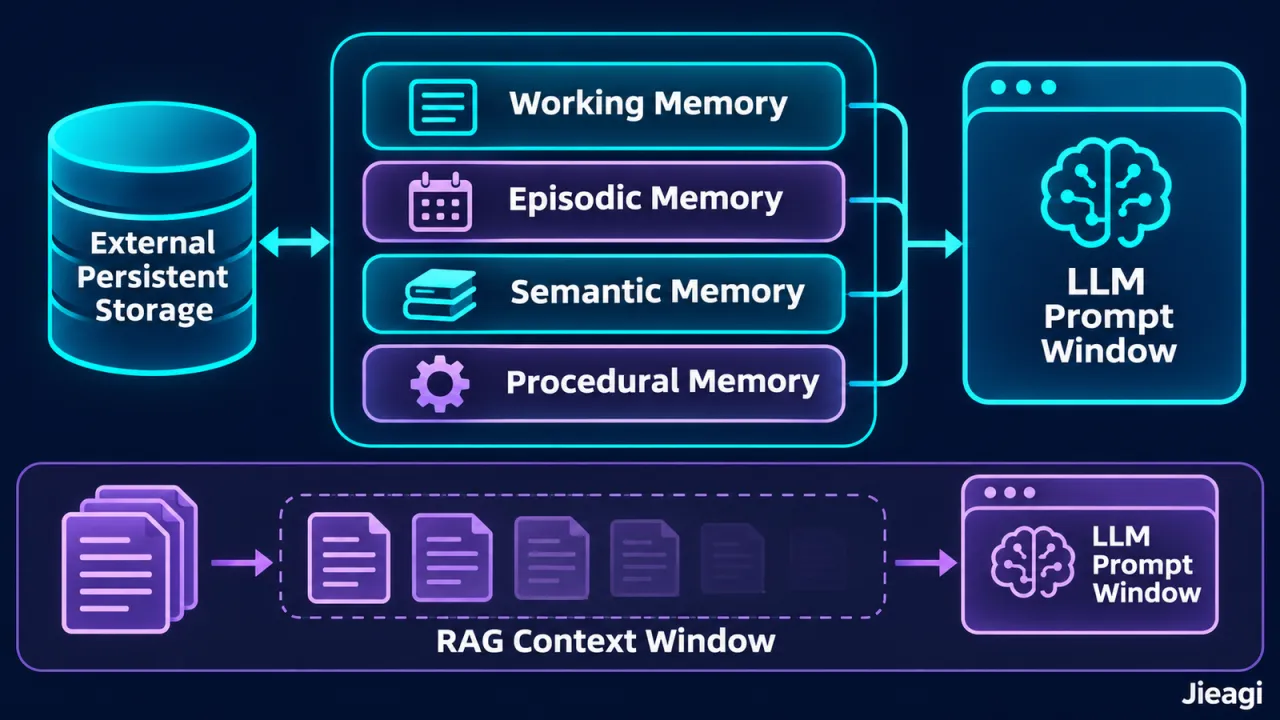
如果一个 AI Agent 记不住你上周二批准过的退款例外,它在生产环境里就会造成实打实的业务损失。正如工程社区在 2026 年达成的共识:大上下文窗口(Long Context)不是记忆,它只是一张每天下班都会被清空的大办公桌。
2026 年 11 月 20 日,AI 工程团队 Incube 通过 GitHub API 实测抓取了当前最活跃的开源 Agent 记忆项目,发布了《2026 AI Agent 记忆开源 Top 10 实测榜单》。本文不仅为你梳理这 10 个核心仓库的 Star 数据、协议风险与适用场景,还将提供基于 Mem0 的 Python 最小可运行接入示例,以及生产落地的 3 个高频踩坑排查方案。
一、2026 年 11 月 GitHub 开源 Agent 记忆 Top 10 实测榜单
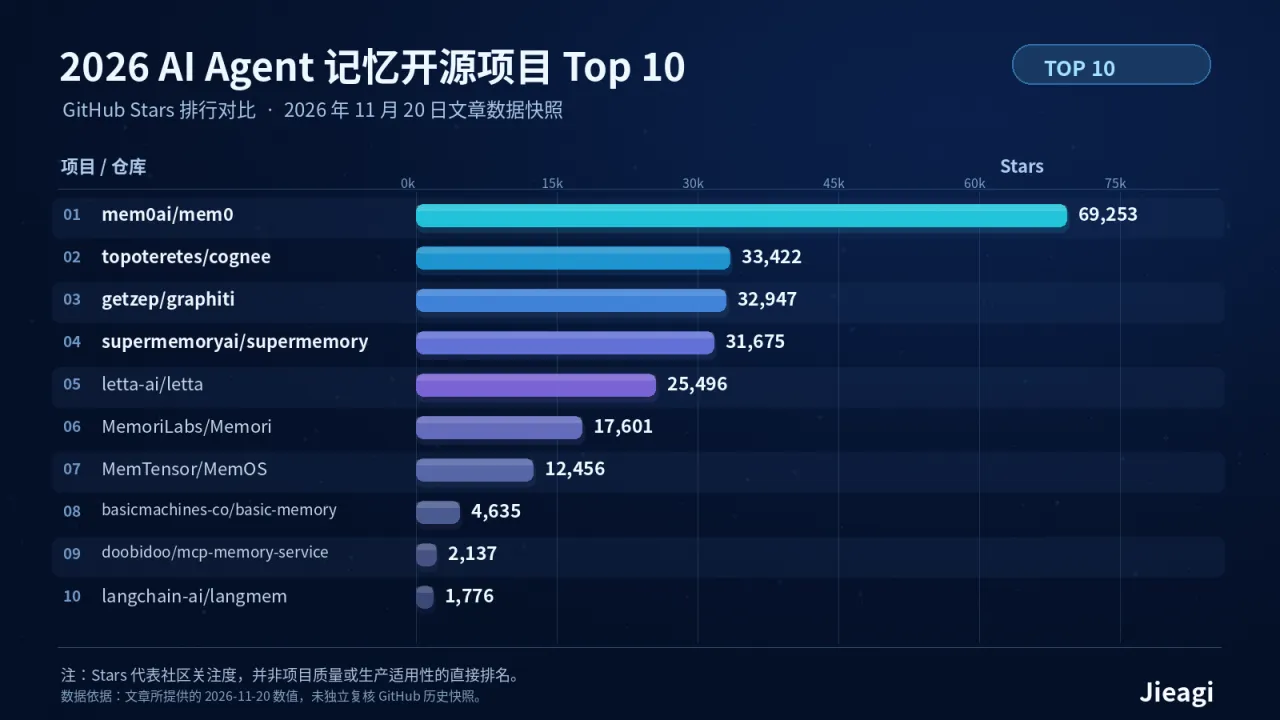
以下数据采集自 2026 年 11 月 20 日 GitHub API(均为非归档且近两个月保持活跃提交的项目,具体协议与功能以各仓库最新 README 为准):
| 排名 | 仓库名称 | Stars(11 月 20 日) | 开源协议 | 核心定位与最佳适用场景 |
|---|---|---|---|---|
| 1 | mem0ai/mem0 |
69,253 | Apache-2.0 | 通用开箱即用记忆层,支持用户/会话/Agent 三级状态 |
| 2 | topoteretes/cognee |
33,422 | Apache-2.0 | 自托管知识图谱记忆,支持本地小模型无 API Key 运行 |
| 3 | getzep/graphiti |
32,947 | Apache-2.0 | 时序感知上下文图谱,每条事实自带有效期窗口 |
| 4 | supermemoryai/supermemory |
31,675 | MIT | 记忆 + RAG + Drive/Gmail/Notion 连接器一体化(支持单二进制本地运行) |
| 5 | letta-ai/letta |
25,496 | Apache-2.0 | MemGPT 正统演进分支,主打有状态 Agent 操作系统架构 |
| 6 | MemoriLabs/Memori |
17,601 | 自定义协议(见仓库) | 直接寄生于企业现有数据库构建结构化持久化状态 |
| 7 | MemTensor/MemOS |
12,456 | Apache-2.0 | 完整的“记忆操作系统”,支持统一生命周期控制与多模态 |
| 8 | basicmachines-co/basic-memory |
4,635 | AGPL-3.0 | 通过 MCP 暴露人类可读的纯 Markdown 记忆文件 |
| 9 | doobidoo/mcp-memory-service |
2,137 | Apache-2.0 | 支持 REST 与 MCP 的多 Agent 共享知识图谱(按 Agent ID 隔离) |
| 10 | langchain-ai/langmem |
1,776 | MIT | LangGraph 生态原生记忆工具与后台知识整合器 |
(注:另有 LightRAG 以 40,778 Stars 常被团队用作图检索方案,但其本质偏向图谱检索而非完整状态记忆层。)
二、快速判断:什么时候用 RAG,什么时候必须上 Agent 记忆?
在动手写代码前,先用一句工程准则区分两者边界:
- 如果“什么是真的”只取决于静态手册(如公司报销制度、API 参考文档),用传统 RAG 就够了,更便宜也更易调试。
- 如果“什么是真的”取决于昨天刚发生的事(如某位客户改成了年付套餐、某笔异常审批被特批通过),你就必须引入支持状态更新与时序覆盖的 Agent 记忆层(相关对比参见 [内链:企业级 RAG 与 Agent 记忆融合架构实战])。
选型五问快速决策
- 事实会随时间过期吗? 会变(价格、状态、负责人)选 Graphiti(带时间窗口)或 Mem0。
- 需要人工审计和纠错吗? 需要选 Basic Memory(纯 Markdown 文件)或可可视化检索的知识图谱,别选黑盒纯向量库。
- 数据必须完全本地驻留? 优先考虑 Cognee(支持本地 CPU 小模型)、
mcp-memory-service或 Supermemory 本地模式。 - 存在多个 Agent 协作? 必须确认框架支持按
agent_id与user_id严格隔离作用域,防止状态串台。 - 准备打包成商业 SaaS 出售? 避开 AGPL-3.0(如
basic-memory)与非标协议仓库,优先选择 MIT / Apache-2.0。
三、实战上手:以 Mem0 开源版为例构建跨会话记忆
下面以目前生态最成熟的 Mem0(Apache-2.0)为例,演示如何在 Python 中为客服/研发助手接入用户级持久化记忆。
1. 环境安装与初始化
pip install mem0ai openai
export OPENAI_API_KEY="your_openai_or_compatible_api_key"
2. 最小可运行记忆闭环(写入、更新与按作用域检索)
from mem0 import Memory

# 初始化本地开源版 Mem0(默认使用本地向量存储与配置的 LLM 提取事实)
config = {
    "version": "v1.1",
}
memory = Memory.from_config(config)

user_id = "dev_zhang_001"

# 1. 写入第一轮交互事实
messages_day1 = [
    {"role": "user", "content": "我的生产环境主数据库是 PostgreSQL 16,请以后代码生成都默认用 psycopg3。"},
    {"role": "assistant", "content": "好的,已记录您的技术栈偏好。"}
]
memory.add(messages_day1, user_id=user_id, metadata={"category": "tech_stack"})

# 2. 几天后技术栈变更,Mem0 会自动提取并更新冲突记忆
messages_day5 = [
    {"role": "user", "content": "项目已迁移到异步架构,现在数据库驱动改用 asyncpg 了。"}
]
memory.add(messages_day5, user_id=user_id, metadata={"category": "tech_stack"})

# 3. 新会话中按语义检索用户最新记忆
results = memory.search("帮我写一段数据库连接代码,用什么驱动?", user_id=user_id, limit=3)
for item in results.get("results", []):
    print(f"[记忆片段] {item['memory']} (Score: {item.get('score', 'N/A')})")
如果你的网关已接入多厂商模型,也可通过 OPENAI_BASE_URL 将 Mem0 后端提取模型指向兼容 OpenAI 格式的推理端点(参考 [内链:使用兼容 OpenAI 接口接入开源 Agent 框架])。
四、生产环境 3 个高频踩坑与排查指南
坑 1:照搬开源库跑分,上线后发现检索准确率远低于 README 宣称
- 原因排查:Incube 在实测中特别指出,包括 Mem0 在内的部分项目,其 README 首页展示的 LongMemEval / LoCoMo 亮眼跑分通常来自自家的托管云平台(Managed Platform),而非纯开源本地默认配置。开源版默认依赖本地嵌入模型与基础提取 Prompt,且各家测试集配置并不统一。
- 解决建议:在开源本地部署时,务必显式开启语义 + 关键词 + 实体匹配的混合检索,并用自己业务的真实工单/对话集跑回归测试,切勿轻信横向榜单第一名宣传。
坑 2:照旧教程部署 Letta(原 MemGPT)报 V1 API 废弃或模块找不到
- 原因排查:根据
letta-ai/letta仓库最新 README 说明,项目活跃开发重心已正式迁移至letta-ai/letta-code,原有的 V1 API Server 已被归档至历史分支(Archive Branch)。 - 解决建议:新项目切勿直接拉取旧版 V1 API 脚手架,请直接从
letta-ai/letta-code起步,或明确锁定历史归档分支版本号以维持旧系统兼容。
坑 3:多 Agent 共享记忆库导致“张冠李戴”甚至越权泄露
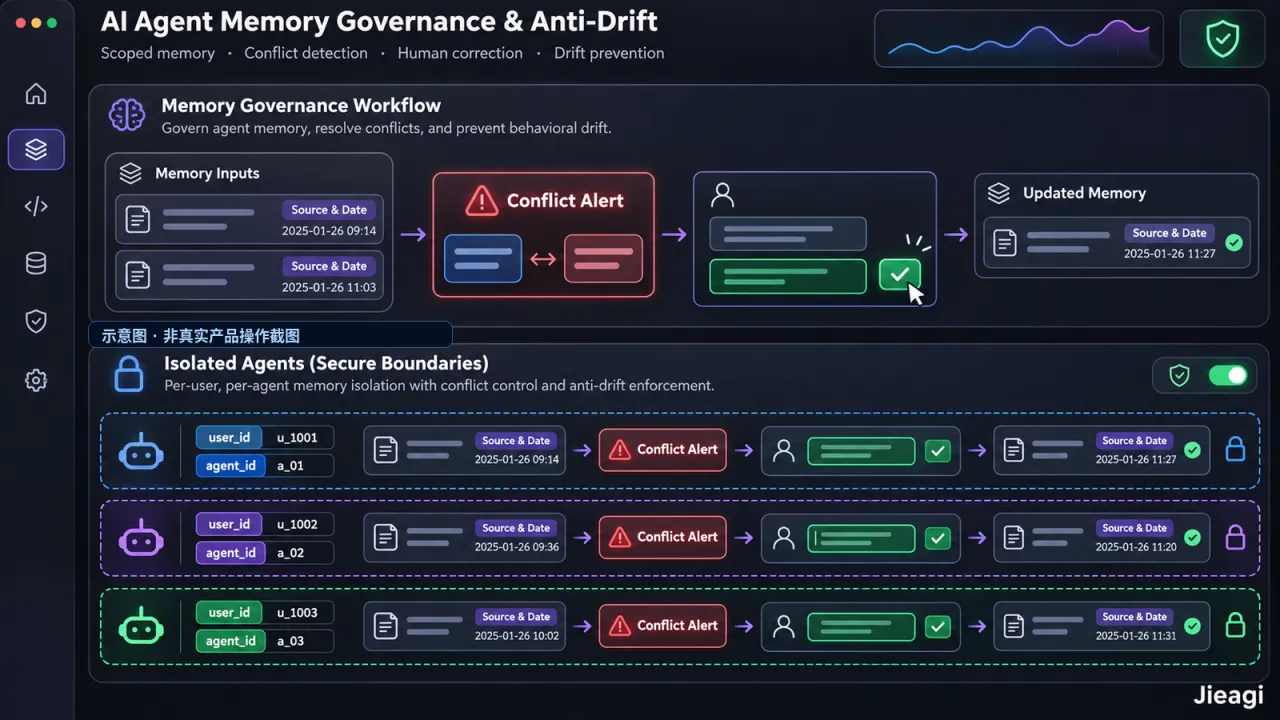
- 原因排查:在多 Agent 流水线中,若只传
agent_id而漏传user_id(或反过来),极易导致客服 Agent 读到内部运维 Agent 的敏感调试记录,或把 A 客户的特批折扣当成全局规则。 - 解决建议:强制在每条记忆写入时同时绑定
user_id、agent_id与来源时间戳(Source & Date),并定期通过人工审计接口或监控脚本巡检相互矛盾的记忆条目。需要原生多 Agent 隔离图谱时,可直接评估doobidoo/mcp-memory-service。
(注:开源项目 Star 数量、API 路径及许可证条款均以各 GitHub 仓库官方最新公布为准。)
常见问题(FAQ)
Q1:AI Agent 记忆和 RAG 有什么本质区别?
A:RAG 主要面向相对静态的文档库(如说明书、政策文件)做只读检索;而 Agent 记忆负责从 Agent 自身的交互历史中持续提取、更新、覆盖会随时间变化的事实与状态。
Q2:2026 年 GitHub 上关注度最高的开源 Agent 记忆项目是哪几个?
A:截至 2026 年 11 月 20 日实测,排名前四的分别是 mem0ai/mem0(69,253 Stars)、topoteretes/cognee(33,422 Stars)、getzep/graphiti(32,947 Stars)和 supermemoryai/supermemory(31,675 Stars)。
Q3:如果我们需要人类能直接用文本编辑器查看和修改 Agent 记住了什么,推荐哪个?
A:推荐 basicmachines-co/basic-memory,它将所有记忆保存为人类可读的纯 Markdown 文件并通过 MCP 协议暴露给 Agent。但请注意其采用 AGPL-3.0 协议,商业化打包发布前需法务评估。
Q4:Letta 和以前的 MemGPT 是同一个项目吗?
A:是的。Letta 原名 MemGPT(源于 2023 年 UC 伯克利论文),目前其活跃开发仓库已转向 letta-ai/letta-code。

关注 AI 前沿动态,分享模型、工具与实战教程。
暂无评论