
 界智通
Tavus Griffin 视频 AI 深度解析:48% 用户误认真人、全双工视频对话及 Griffin-Lite 开放情况
 jieagi_Pan
一、AI 视频模型正在从生成视频走向实时交流
如果你曾经使用过 AI 视频生成工具,应该熟悉这种流程:
输入一段文字,上传图片,等待模型生成视频,最后获得一个可以播放的视频文件。
这类工具已经能够用于广告、短视频、影视创作和商品展示。
但它们通常并不擅长实时与用户交流。
例如,你无法自然地打断已经生成的视频角色,让它立即听懂你的新问题,并根据你的表情改变下一句话。
这正是 Tavus 希望通过 Griffin 解决的问题。
2026 年 10 月 1 日,Tavus 正式公布了 Griffin。
官方将它称为 Human Interaction Model,简称 HIM。
与传统 AI 视频生成模型不同,Griffin 重点研究的是实时面对面交互。
它不仅需要生成声音和视频,还需要理解人类什么时候讲话、什么时候停顿、什么时候应该回应,以及表情、视线和动作所传递的信息。
更引人关注的是,Tavus 披露的一项测试显示:
约 48% 的参与者在一分钟视频交流后,认为与自己交谈的对象是真人。
这让 Griffin 成为 2026 年值得关注的实时交互 AI 研究之一。
不过需要提前说明:Griffin 于 10 月 1 日公布,并非 10 月 12 日首发;目前 Griffin-Lite 仍是面向少量可信测试者的研究预览,不是已经对所有开发者开放的通用视频 API。
二、Tavus Griffin 是什么?
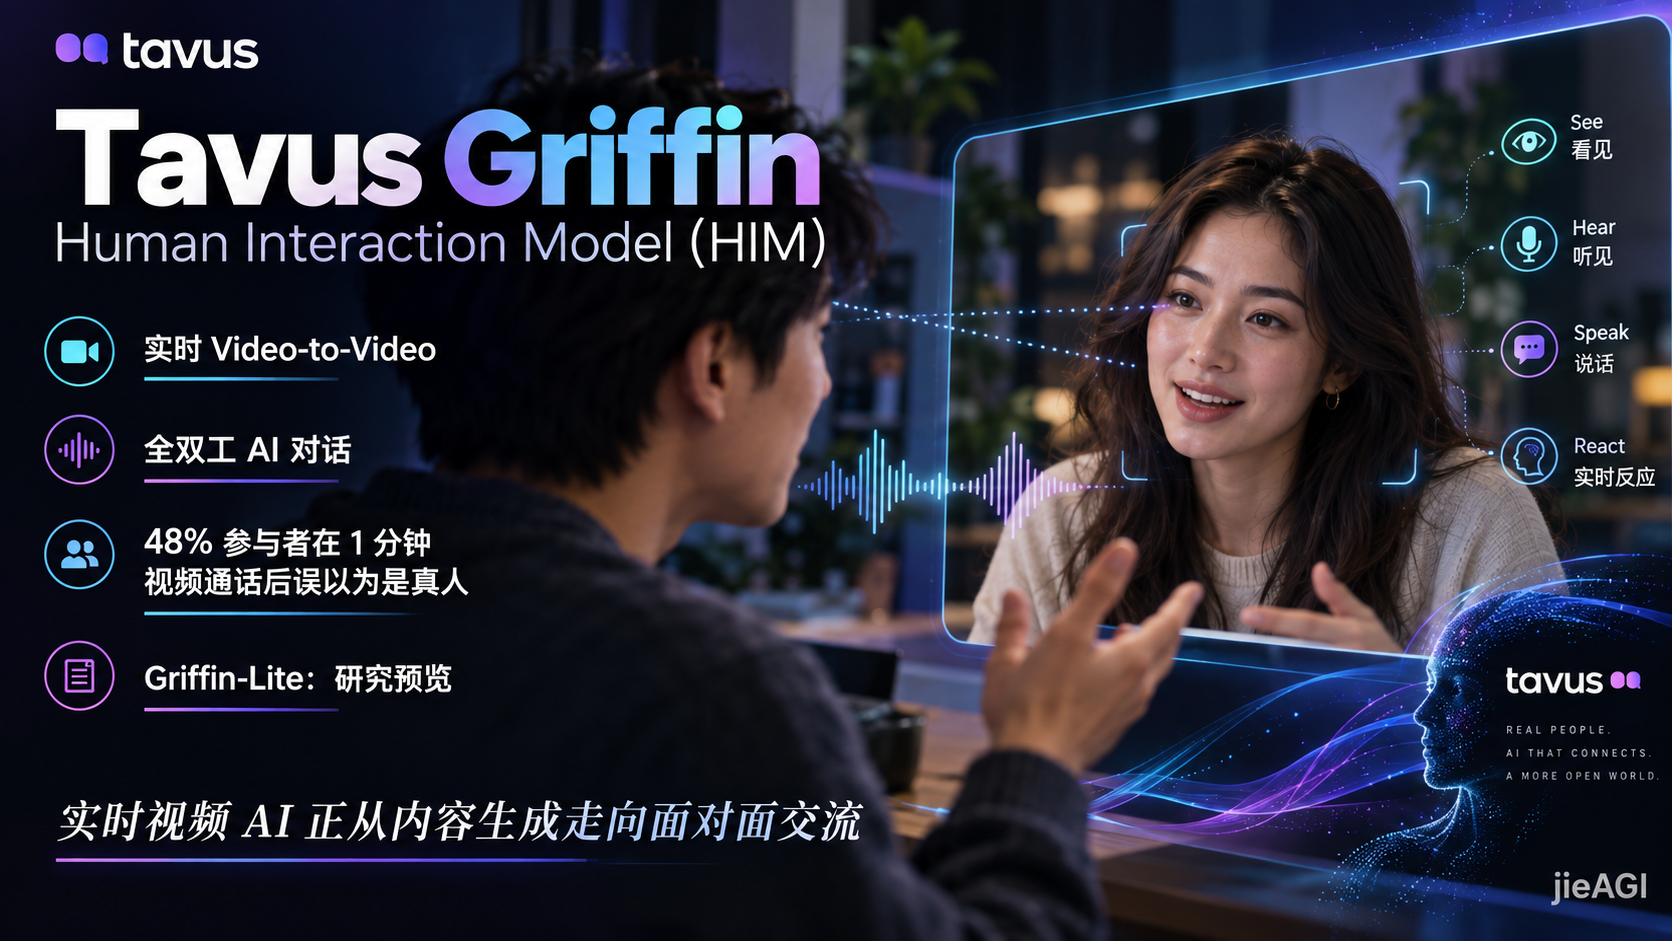
Griffin 是 Tavus 开发的一种实时人机交互模型。
它尝试将多个原本独立的 AI 功能整合为连续的视频交流系统。
主要包括:
视觉感知: 理解用户的表情、动作和周围环境。
语音理解: 持续接收并分析用户讲话的内容。
对话控制: 判断什么时候回应、等待或被打断。
语音生成: 根据当前交流状态生成声音。
视频生成: 实时生成数字角色的表情、动作和画面。
Tavus 将这些能力组合成 Video-to-Video 架构。
也就是说,系统不仅处理文字,还持续处理音视频信息,并产生实时音视频输出。
从产品方向来看,Griffin 希望让用户不再需要刻意适应机器的交流节奏,而是让 AI 学会更加自然地参与面对面沟通。
三、Griffin 与传统 AI 数字人有什么区别?
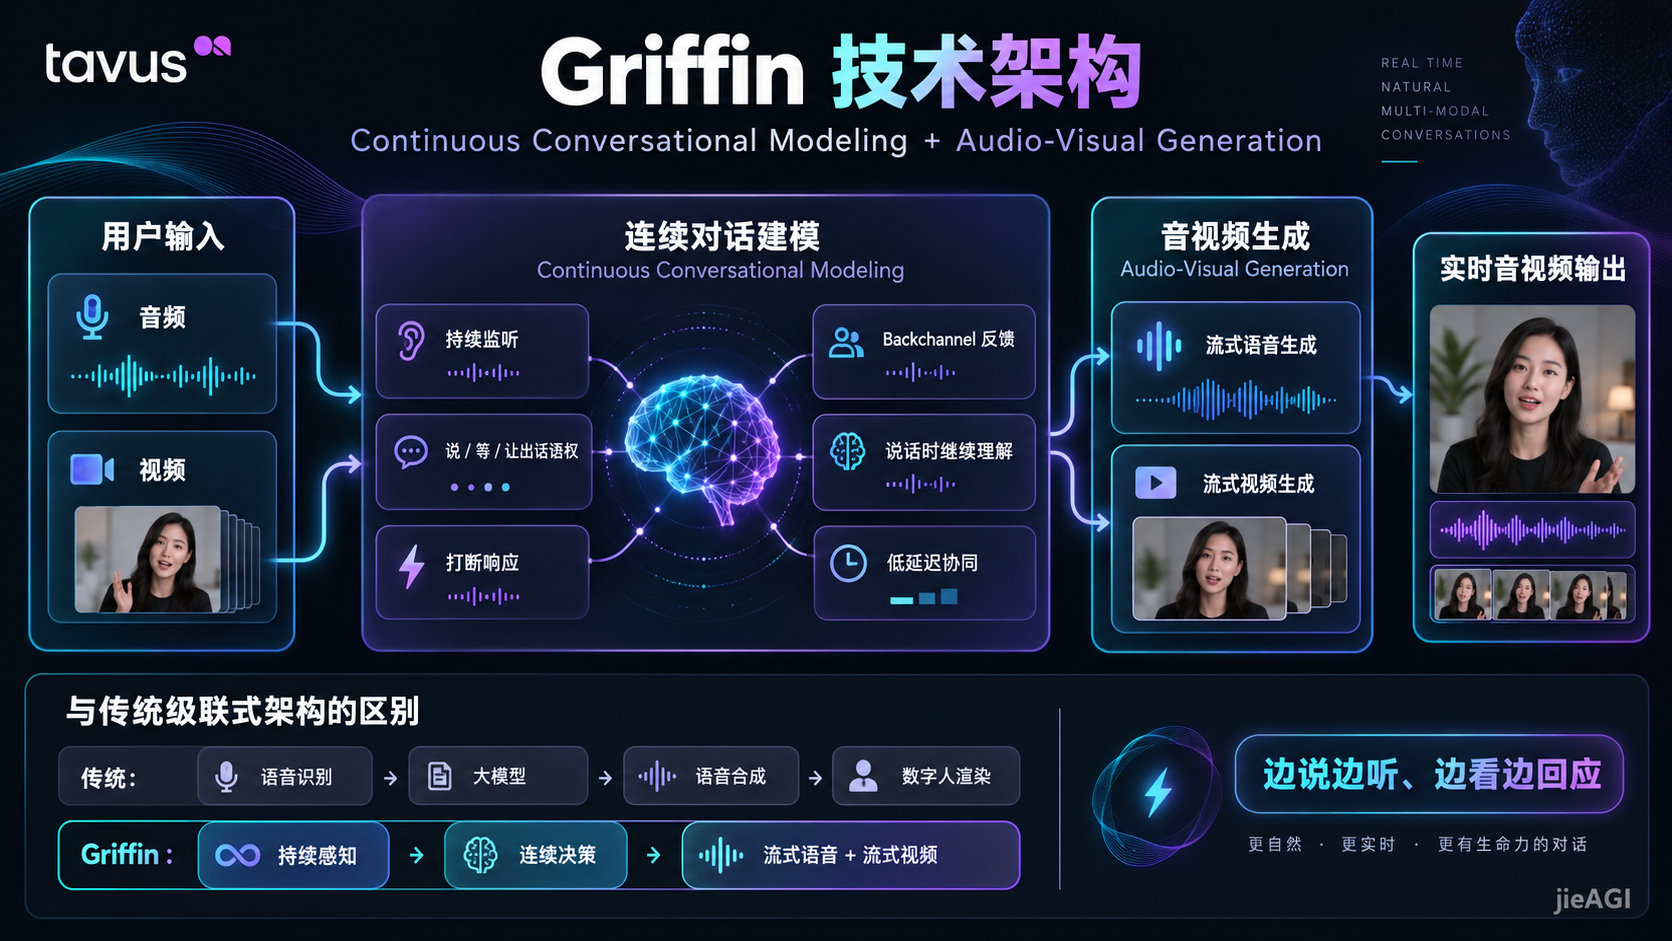
传统 AI 数字人通常采用级联式架构。
例如:
用户讲话 → 语音识别 → 大语言模型 → 文本回复 → 语音合成 → 数字人渲染。
这种架构能够生成看起来比较真实的数字人,但依然面临一些问题。
比如用户还没有讲完,系统已经开始回答。
或者模型正在输出长段文字,用户打断以后,系统需要等待较长时间才能调整。
再比如数字人的表情只是根据生成语音做简单匹配,没有真正理解当前对话中发生的事情。
Griffin 的设计思路则有所不同。
它采用连续对话建模机制,在交流过程中反复判断:
用户是否仍在讲话、是否开始停顿、是否希望插话,以及 AI 当前应该继续说话还是让出话语权。
| 对比维度 | 传统级联式视频 Agent | Griffin 研究架构 |
|---|---|---|
| 用户输入 | 常以音频、文本处理为主 | 持续感知音频和视频 |
| 语音输出 | 常按文本结果生成 | 流式语音生成 |
| 视频表现 | 数字角色渲染或驱动 | 流式完整视频生成 |
| 交互节奏 | 依赖轮次检测和系统协调 | 连续建模讲话与停顿 |
| 被用户打断 | 依赖中断处理模块 | 设计为持续感知并响应 |
| 非语言反馈 | 部分系统通过规则实现 | 纳入连续对话控制 |
这不代表所有旧式数字人都无法中断或感知表情,而是 Griffin 将这些能力更加紧密地结合到同一套模型系统中。
四、什么是 Full-Duplex 全双工 AI 对话?
Full-Duplex,中文通常称为全双工。
在传统通信中,它意味着双方能够同时发送和接收信息。
放到实时 AI 对话中,其意义更加直观:
AI 在讲话的时候,仍然可以继续听用户讲话。
例如,AI 正在向用户解释某个产品的使用方法。
用户突然说:
“先不用讲这个,帮我看看屏幕上的错误。”
理想的实时 Agent 应当迅速识别用户改变了需求,并停止或者调整原先的回答。
它不应该等待整段输出结束后才发现用户已经提出新的问题。
Griffin 还希望实现一种更细腻的互动。
当用户正在表达想法时,AI 可以适时点头、作出简短回应,或者用表情表达正在理解。
这种行为在日常人类沟通中非常常见。
Tavus 称之为 Backchannel,即交流过程中的简短反馈。
相比只在用户说完之后才开始工作的系统,这类能力有助于提升实时交互的自然程度。
五、Griffin 的核心技术架构
根据 Tavus 官方研究,Griffin 包含两个关键部分。
1. Continuous Conversational Modeling
即连续对话建模引擎。
它持续接收用户的音频和视频信息。
然后以亚秒级的时间间隔更新对话判断。
例如:
用户有没有结束讲话?
是否应该立即回应?
用户是否只是短暂停顿?
AI 当前应该继续讲话,还是让用户插话?
除了语言内容,模型还会结合表情、语调和动作作出判断。
2. Audio-Visual Generation
即音视频生成引擎。
它根据对话模型输出的控制信号,持续生成声音和视频。
这部分又包含流式语音生成和流式视频生成技术。
它们不需要等整段对话完全结束以后再开始工作,而是持续接收更新的控制信息。
整个模型的工作流程可以概括为:
用户音频与视频 → 连续对话建模 → 语言和动作控制信号 → 流式语音与视频生成 → 实时返回给用户。
这也是 Tavus 所说的统一 Video-to-Video 系统。
六、为什么 Griffin 能从一张参考图片生成动态场景?
这是 Griffin 研究中另一个值得关注的能力。
传统数字人渲染通常重点处理面部、嘴型和部分上半身动作。
而 Tavus 表示,Griffin 可以根据一张参考图片,实时生成整个视频场景的画面。
这意味着模型不仅处理人物的面部表情,还可以同时处理:
手部动作、身体姿势、椅子移动、背景变化和场景阴影等元素。
在传统数字人系统中,这类复杂动态行为可能需要多套独立的控制和渲染模块。
Griffin 则希望通过统一的生成系统,让画面动作与对话内容保持一致。
例如,一个数字人正在解释某个物品的使用方法时,可以根据对话内容产生对应的姿势和动作。
当然,实时视频生成依然面临一致性、画面稳定性和延迟问题。
这些仍然需要通过实际演示和长期测试评估,而不能只根据宣传视频判断。
七、48% 用户认为 Griffin 是真人,这项实验究竟说明什么?
这是 Griffin 最受关注的一项研究数据。
但这项数据也最容易被误解。
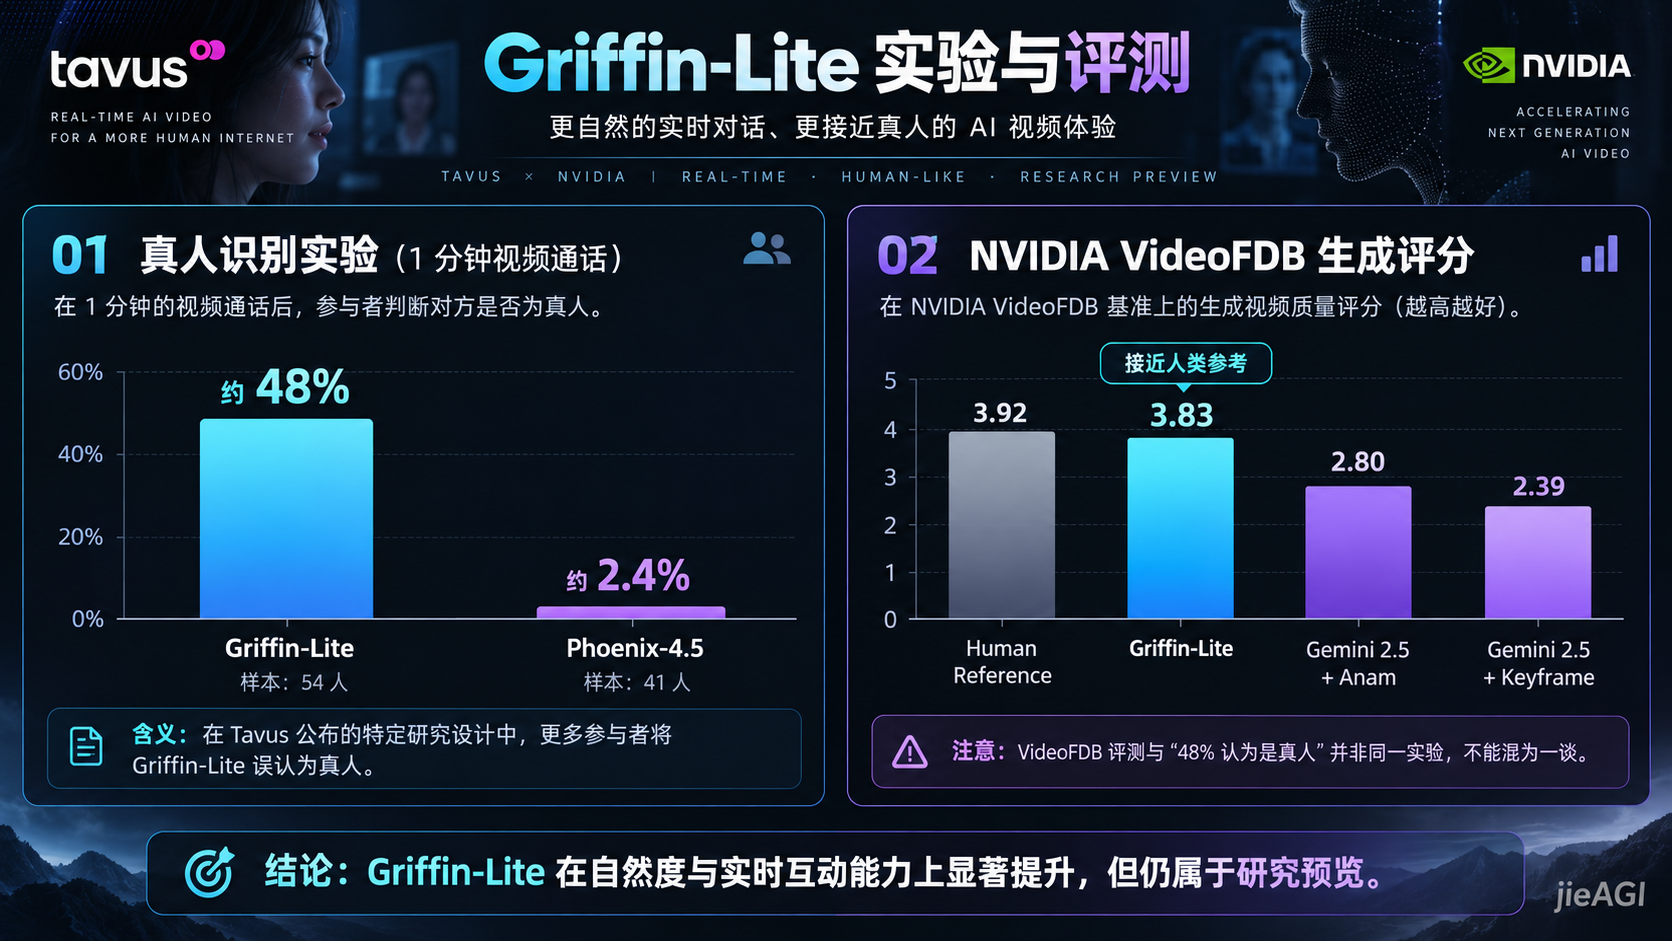
Tavus 官方披露,Griffin-Lite 的面对面研究共有 54 名参与者。
参与者被告知,他们将通过一分钟视频通话与另一位参与者交谈。
实际上,对面的角色是 Griffin-Lite 驱动的 AI。
在通话结束后,研究者调查参与者对交流自然程度、可信度及对方身份的判断。
结果显示:
约 48% 的参与者认为对方是真人。
Tavus 还披露了其上一代 Phoenix-4.5 系统的比较数据。
| 研究系统 | 样本数量 | 认为对方是真人的比例 |
|---|---|---|
| Griffin-Lite | 54 | 约 48% |
| Phoenix-4.5 | 41 | 约 2.4% |
这组数据说明,在 Tavus 采用的研究设计中,Griffin-Lite 显著提高了参与者对数字角色真实性的判断。
但它不能被简单解读成:
“Griffin 已经在所有情况下有 48% 的概率骗过人类。”
原因包括:
- 测试通话只有一分钟;
- 参与者事先没有被明确告知对方可能是 AI;
- 研究样本规模有限;
- 不同问题、语言和交流环境可能影响结果;
- 研究结果由 Tavus 公布,并非全球统一的模型测评标准。
Tavus 将其描述为通过了实时视频图灵测试,但这一表述应放在其指定的研究方法与评判标准中理解。
八、NVIDIA VideoFDB 评测结果怎么看?
除面对面实验外,Tavus 还介绍了 NVIDIA VideoFDB 评测。
这是针对全双工音视频对话系统的研究基准。
它关注的不只是模型能否回答正确问题,还包括表情、视线、动作和对话时机是否自然。
Tavus 官方披露,Griffin-Lite 在相关生成与感知评测中取得了较高成绩。
例如,在生成轨道的综合评分中:
| 对象 | 官方列示评分 |
|---|---|
| 人类参考 | 3.92 |
| Griffin-Lite | 3.83 |
| Gemini 2.5 + Anam | 2.80 |
| Gemini 2.5 + Keyframe | 2.39 |
Tavus 表示,VideoFDB 的评测由 NVIDIA 根据公开指标和自身评判系统独立执行。
需要注意,这项基准与前面 54 人参与的面对面实验是两套不同评估。
不能将 VideoFDB 的结果与“48% 认为真人”的研究混为一谈。
同时,评测只覆盖基准定义的任务与系统配置,并不能直接代表模型在所有产品环境中的表现。
九、Griffin 与 Phoenix、Raven、Sparrow 有什么关系?
如果你以前了解过 Tavus,可能见过这些名称:
Phoenix、Raven、Sparrow。
它们分别对应 Tavus 实时视频交互研究中的不同能力。
Phoenix: 主要关注实时人物渲染和视觉表现。
Raven: 主要关注视觉与环境感知。
Sparrow: 主要关注对话轮次控制和讲话时机。
Griffin 则尝试将这些研究方向融合到统一的交互模型之中。
因此,Griffin 并不只是 Phoenix 的一次普通升级,也不只是一个会自动生成视频的聊天机器人。
它希望在同一套系统中持续理解交流状态,并同步控制语言、声音和画面表现。
十、Griffin 在哪些场景下最有价值?
AI 教育与培训
学生可以通过视频与 AI 教师交流。
AI 能够根据学生的表情、停顿和对话内容,调整解释方式。
例如,当学生长时间没有回应时,系统可以尝试判断是否需要重新解释某个概念。
企业客户服务
用户可以通过视频展示发生故障的设备。
AI 客服结合语音和摄像头内容,提供初步排查建议。
这有机会减少用户必须用文字描述复杂物体和操作步骤的负担。
销售与客户沟通
企业可以构建互动式数字销售顾问,辅助介绍产品、回答问题和演示功能。
但产品应明确告知用户正在与 AI 交流,避免产生身份误导。
面试和沟通训练
用户可以与模拟角色进行面对面练习。
例如模拟英语面试、客户沟通和演讲训练。
AI 数字人产品
开发者可以关注实时交互数字人如何融入网站、教育应用、服务系统和移动端产品。
不过,这些是技术可能适用的方向,并不代表 Griffin-Lite 当前已经面向所有商业客户提供相应能力。
十一、Griffin-Lite 现在可以使用吗?
这是文章必须说明清楚的问题。
截至 Tavus 2026 年 10 月 1 日的正式研究公告:
Griffin-Lite 尚未向普通客户全面开放。
Tavus 明确表示,该版本作为研究预览,仅向一部分受信任的早期测试者提供访问资格。
用户可以通过 Griffin 官方页面申请加入测试。
官方研究页面:
因此,不应该根据 Tavus 已经提供普通 Conversational Video Interface API,就认定普通 API Key 已经能够调用 Griffin-Lite。
现有 Tavus API 产品与 Griffin-Lite 研究预览需要区分。
前者可以为开发者提供已有的实时数字人交互能力。
后者仍需要额外的研究测试资格。
十二、普通开发者怎样开始学习 Tavus API?
如果你希望先研究实时数字人开发,可以从 Tavus 现有 Conversational Video Interface(CVI)入手。
常见流程是:
开发者创建 Persona,配置数字角色的对话行为。
然后使用 API 创建 Conversation,获取对应的视频通话地址。
最后在网站或应用中打开通话界面。
例如现有 Tavus API 的基础创建会话请求结构如下:
curl --request POST \
  --url https://tavusapi.com/v2/conversations \
  --header "Content-Type: application/json" \
  --header "x-api-key: $TAVUS_API_KEY" \
  --data '{
    "persona_id": "YOUR_PERSONA_ID"
  }'
成功响应中可以包含 conversation_url,用于进入相应视频会话。
需要再次强调:
这是 Tavus 现有 CVI API 的通用调用方式,不是 Griffin-Lite 的正式调用教程。
要使用 Griffin-Lite,仍需等待并获得相应的研究预览资格。
十三、实时视频 AI 还有哪些关键挑战?
Griffin 展示了一种令人关注的技术方向,但距离大规模商业应用仍有不少问题需要解决。
延迟
模型需要同时处理音频、视频、对话状态和生成画面。
如果系统延迟过高,交流就会失去自然感。
视觉一致性
视频角色需要在长时间交流中维持稳定身份、场景和动作连续性。
对话理解
模型必须理解停顿、打断、背景噪声和多人同时讲话等情况。
成本
实时流式视频生成通常需要持续消耗计算资源。
商业化时需要关注每分钟推理成本、并发能力和服务稳定性。
隐私与安全
视频可能包含用户面部、声音、环境信息和其他敏感内容。
产品需要明确告知数据用途,并建立合理的存储、删除及访问规则。
十四、Griffin 为什么存在更高的身份欺骗风险?
相比普通文字聊天,实时视频 AI 可能更容易使用户误以为正在与真人交流。
这会给客户服务、营销、社交互动和身份认证带来新的风险。
例如,恶意行为者可能尝试通过逼真的音视频角色进行冒充。
因此,Tavus 官方明确表示,需要继续完善安全保护和 AI 身份披露措施。
Griffin-Lite 暂时不向普通客户开放,也与这些安全问题有关。
对于准备开发视频 AI 产品的团队,至少应该考虑:
- 明确标注 AI 身份;
- 未经授权不复制真人形象与声音;
- 对实时会话建立适当的安全记录和用户控制;
- 合理处理摄像头与麦克风数据;
- 高风险身份验证和支付环节不单独依赖视频外观判断。
技术越接近真实人类交流,透明度和身份保护就越重要。
十五、Tavus Griffin 常见问题
Tavus Griffin 是视频生成模型吗?
它属于实时视频交互模型,不只是生成离线视频片段。
Griffin 与普通 AI 数字人有什么区别?
Griffin 更强调持续感知、全双工对话,以及实时生成包含动作和场景的视频。
48% 的数据是什么意思?
在 Tavus 公布的特定一分钟面对面研究中,约 48% 的 54 名参与者认为对面是真人。
Griffin-Lite 已经全面开放 API 吗?
没有。官方公告明确指出,该版本目前只面向选择性的研究测试者。
Tavus 现有 API 能直接调用 Griffin-Lite 吗?
不能直接这样认定。普通 CVI API 与 Griffin-Lite 研究预览属于不同的访问范围。
Griffin 能完全替代真人客服吗?
不能保证。真实业务还需要评估准确性、服务可靠性、身份披露、隐私和异常情况下的人类接管能力。
十六、总结:实时 AI 正在从生成内容走向参与交流
Tavus Griffin 的意义,不只是 AI 数字人看起来越来越真实。
更重要的是,模型正在尝试理解面对面交流中的时间、动作、声音和语境。
过去,很多 AI 产品的主要任务是生成文字、图片或视频。
而 Griffin 展示的方向是:
AI 不只是生成内容,还要实时参与人类交流。
不过,令人印象深刻的研究结果并不等于成熟的商业产品。
Griffin-Lite 目前仍然处于有限研究预览阶段,安全防护、身份披露和产品化能力都需要继续验证。
对于 AI 视频开发者来说,Griffin 值得持续关注的不是单一的 48% 数字,而是它代表的下一代实时多模态交互架构。
未来 AI 视频产品的竞争,可能逐渐从“生成一段更真实的视频”,转向“能否让人机交流变得更加自然、可靠和安全”。
官方参考资料
1. Tavus — Introducing Griffin: The First Human Interaction Model https://www.tavus.io/griffin
2. Tavus — Research https://www.tavus.io/research
3. Tavus — Conversational Video Interface 文档 https://docs.tavus.io/
4. Tavus — Developer API https://docs.tavus.io/api-reference/
转载请注明出处: 界智通
本文的链接地址: https://www.jieagi.com/aizixun/145.html
-

GPT-5-Codex保姆级教程:获取OpenAI APIKey与安装 Codex CLI使用教程全面指南
2025/09/17
-
2025最新:Claude Pro 与 Max 区别详解与订阅指南
2025/08/26
-
Gemini 报错 "Something went wrong" 终极解决指南
2025/11/27
-
Cursor权威指南:从注册入门到精通AI驱动编程工作流(含国内注册与验证说明)
2025/08/27
-
2025最新保姆级教程:如何获取Claude API Key?从注册到Python调用,一篇搞定!
还在为如何申请 Claude API Key 而头秃吗?随着 Claude 4.5 Sonnet 在编程能力上的强势崛起,越来越多的开发者开始转向 Anthropic 的阵营。本文将通过“保姆级”的图文实操,带你一步步解决账号注册、手机号验证、API Key 获取及额度充值等难题,并附带 Python 极简调用示例。无论你是想接入 LangChain 还是自己在这个强大的模型上跑 Demo,这篇文章都能帮你避开 99% 的坑!
2025/11/15
-
【实测有效】Gemini 3 / Google Antigravity 授权登录无反应、无权限?全平台解决办法汇总指南
2025/11/22
-
WorkBuddy 高阶进阶全解:获取OpenAI Key自定义 API + SKILL.md 封装,效率直接翻倍
2026/04/19
-
[2025最新] ChatGPT Plus 订阅终极指南:四种充值方案与深度解析:为什么它值$20?
2025/11/13
-
Google AI Pro 有什么功能?Google AI Pro 生态系统深度报告以及订阅会员权益功能全面分析
2025/11/29
-
Grok-4.1 深度拆解:马斯克的“叛逆”AI怎么接入?xAI Grok API Key 获取及开发攻略
想要体验马斯克旗下xAI的Grok大模型?本文详细拆解 Grok API Key 获取的全流程,从账号登录、控制台设置到API Key生成,并附带完整的Python调用代码示例。解决开发者在申请过程中遇到的支付、权限等常见问题,助你快速将“叛逆”的Grok集成到自己的应用中。
2025/11/18


暂无评论
太好看了,快点更新!
国内开发者玩转Claude:最新Claude 4模型解析与API Key获取攻略
这是系统生成的演示评论
国内开发者玩转Claude:最新Claude 4模型解析与API Key获取攻略