
 界智通
HydraFusion Max 使用教程 2026:GitHub Copilot 多模型协同、Cascade、Critique 与 AI 编程成本解析
 jieagi_Pan
一、GitHub HydraFusion Max 发布,AI 编程进入多模型协同时代
过去,开发者使用 AI 编程工具时,经常面临一个选择:
究竟应该使用 GPT、Claude,还是其他模型?
如果任务是简单的代码解释,使用速度快、成本低的模型就可以满足需求。
但如果需要修改大型项目、修复复杂 Bug 或分析多个模块之间的关系,开发者可能更愿意选择推理能力更强的旗舰模型。
问题在于:
同一个开发任务,并不一定需要从头到尾都使用同一款高成本模型。
例如,创建初始代码草稿时,可以使用相对高效的模型。
而涉及复杂问题检查、边界条件和质量审查时,再使用更强的模型。
这正是 GitHub HydraFusion 希望解决的问题。
2026 年 10 月 14 日,GitHub 正式公布 HydraFusion 新一轮升级,并推出 HydraFusion Max。
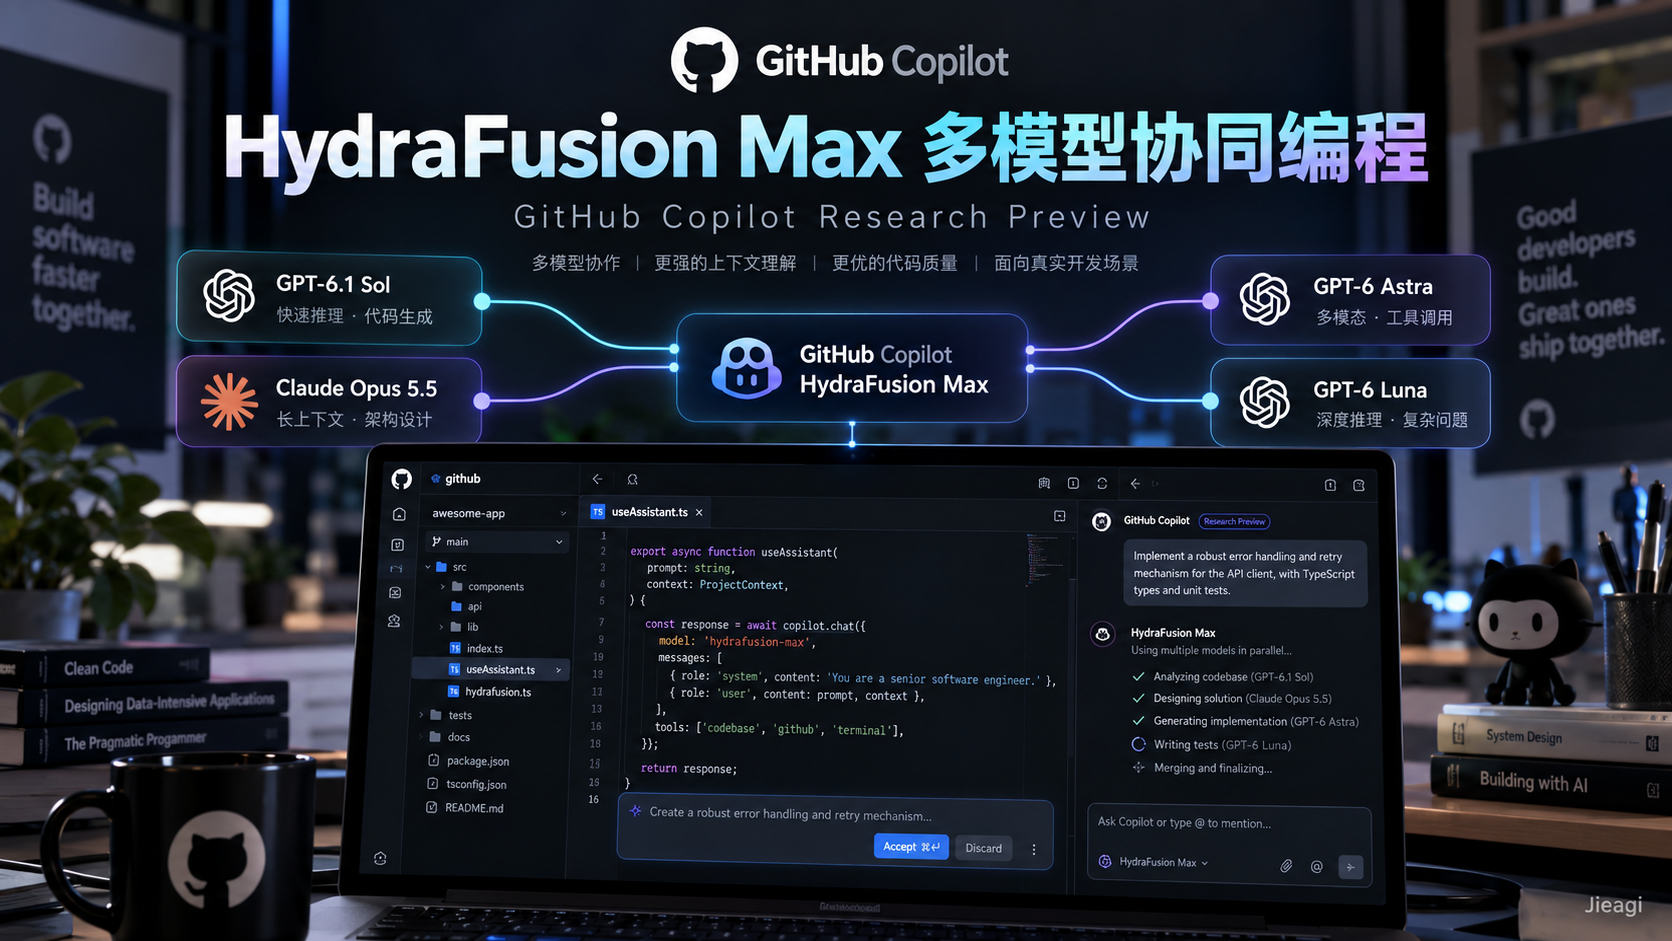
这次更新将 Claude Opus 5.5、GPT-6 Astra、GPT-6.1 Sol 和 GPT-6 Luna 纳入可用模型池,同时改进多模型编排工作流。
开发者不再需要为任务中的每一步手动切换模型。
HydraFusion 会根据任务需求选择合适的模型、执行方式和推理强度。
不过,首先需要明确:
HydraFusion Max 不是 GitHub 自己训练的一款新大模型,而是一套多模型运行时编排系统。
它目前仍处于 Research Preview(研究预览)阶段,尚不适合作为拥有正式 SLA 的生产系统能力。
二、HydraFusion 到底是什么?
HydraFusion 是 GitHub Copilot 中的运行时模型编排功能。
与普通模型选择器不同,HydraFusion 可以为一次任务安排不同模型参与处理。
例如:
开发者提出一个复杂代码修复需求。
系统先判断任务难度。
如果任务比较简单,可能只调用一个模型完成。
如果任务较复杂,系统可能先让一个模型编写解决方案,再由另一个模型检查结果。
当发现问题时,再进行修复或升级处理。
因此,HydraFusion 不只考虑“应该用哪个模型”。
它还会考虑:
应该采取什么执行流程,是否需要额外审查,以及每一步应该投入多少推理资源。
GitHub 将这一过程定义为模型编排优化问题。
三、HydraFusion 主要支持三种工作流
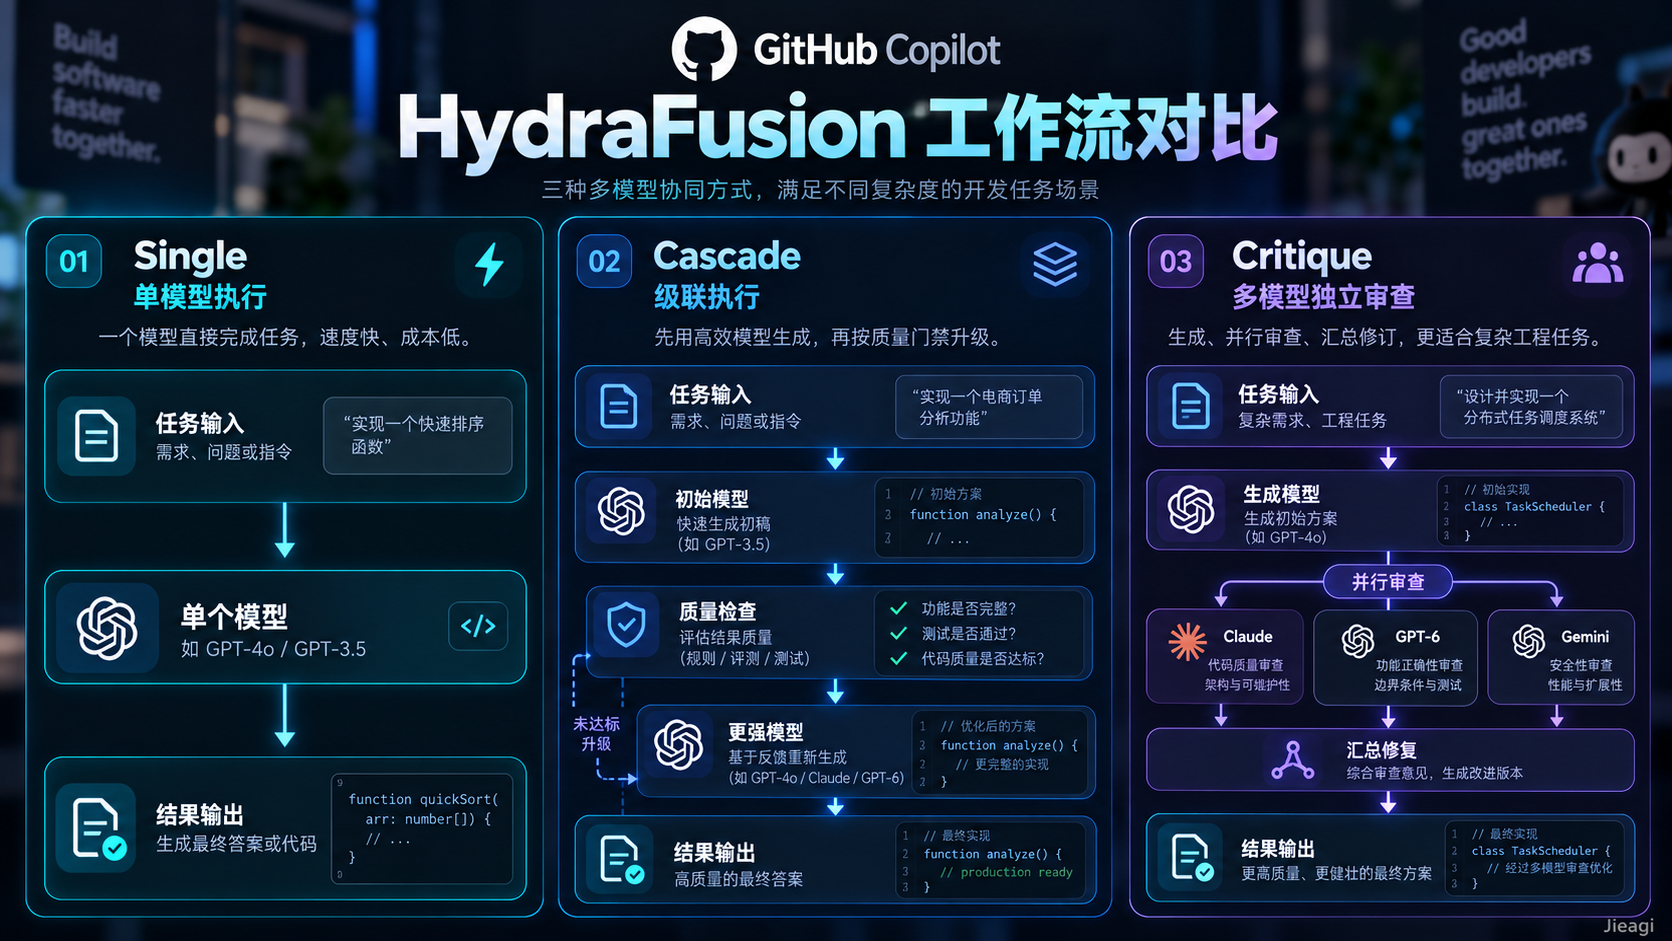
1. Single:单模型执行
这是最简单的模式。
系统选择一个适合任务的模型,直接完成工作。
例如:
“解释这个 Python 函数的作用。”
这种任务可能不需要额外的审查模型。
Single 的优势是执行流程简单,通常具有较好的速度和成本表现。
2. Cascade:级联执行
Cascade 的目标是让任务先由较高效的模型处理。
如果结果满足质量要求,就直接采用。
如果系统判断结果需要进一步检查或改进,就升级到更强的执行流程。
例如:
开发者要求修复某个 API 的分页错误。
第一轮模型提出补丁。
系统检查结果后发现边界条件仍然存在问题。
随后调用更强的模型或额外的修复步骤。
2026 年 10 月 14 日的升级进一步加入了判断阶段。
这样可以在初始结果合格时减少不必要的额外处理。
3. Critique:多模型独立审查
Critique 重点解决代码审查质量问题。
它可以先由一个模型生成结果,再安排其他模型进行独立审查。
新版 Critique 增强了对实际工作区的检查能力。
审查模型不只是阅读初始模型生成的文字说明,而是可以在其授权工具范围内检查实际代码和工作区内容。
GitHub 还引入了多个审查模型并行检查的方式。
最后,系统汇总审查意见,由原始模型完成一次针对性的修改。
这种方式特别适合:
复杂代码修复、跨模块变更、接口兼容性检查和边界条件分析。
不过,更多模型参与意味着潜在的额外延迟和费用,并不能保证在每个任务中都更经济。
四、HydraFusion Max 和普通 HydraFusion 有什么区别?
这次发布的 Max 版本,并不是另一套完全不同的架构。
GitHub 明确说明,两者使用相同的多模型编排基础。
主要区别在于任务能力目标和推理资源分配策略。
| 对比项目 | HydraFusion | HydraFusion Max |
|---|---|---|
| 主要定位 | 平衡质量、速度与成本 | 更复杂的前沿任务 |
| 多模型编排 | 支持 | 支持 |
| Single / Cascade / Critique | 支持 | 支持 |
| 推理资源 | 根据阶段动态分配 | 更偏重深度推理 |
| 适合任务 | 常规到复杂编程任务 | 高难度问题、深度审查 |
| 计费方式 | 根据实际模型调用 | 根据实际模型调用 |
| 当前状态 | 研究预览 | 研究预览 |
在新版中,HydraFusion 可以对初始草稿使用 medium 推理强度,对审查阶段使用 high。
而 HydraFusion Max 还可以在适当步骤使用 extra high 等更高推理强度。
因此,Max 更适合需要深入分析的问题。
但是,对于简单函数解释和短代码补全,并不需要默认使用 Max。
五、支持哪些大模型?
GitHub 10 月 14 日公告列出的模型池包括:
- Claude Opus 5.5;
- GPT-6 Astra;
- GPT-6.1 Sol;
- GPT-6 Luna。
需要注意,这些模型不会在每次请求中全部被调用。
HydraFusion 会根据任务和具体工作流选择模型。
而且模型池并不是永久固定的。
随着模型更新、可用性变化和 GitHub 后续优化,实际参与模型可能调整。
开发者也不能在 HydraFusion 内直接指定每个阶段必须由哪一款模型执行。
如果需要精确控制某个任务必须使用特定模型,更适合直接选择该模型或使用自建编排系统。
六、HydraFusion 与 Copilot Auto 有什么区别?
这是非常容易混淆的两个功能。
Copilot Auto 主要解决:
为当前请求选择一个合适的模型。
HydraFusion 则进一步解决:
为当前请求选择执行流程,并在需要时协调多个模型。
例如:
Auto 可能选择 GPT-6.1 Sol 完成一个任务。
HydraFusion 则可能选择一个模型生成草稿,再使用另一个模型审查,最后完成修改。
因此:
Auto 更适合日常开发和低复杂度任务。
HydraFusion 更适合任务边界明确、需要额外质量检查的开发工作。
HydraFusion Max 则更适合高难度的工程分析。
七、HydraFusion Max 怎么开启?
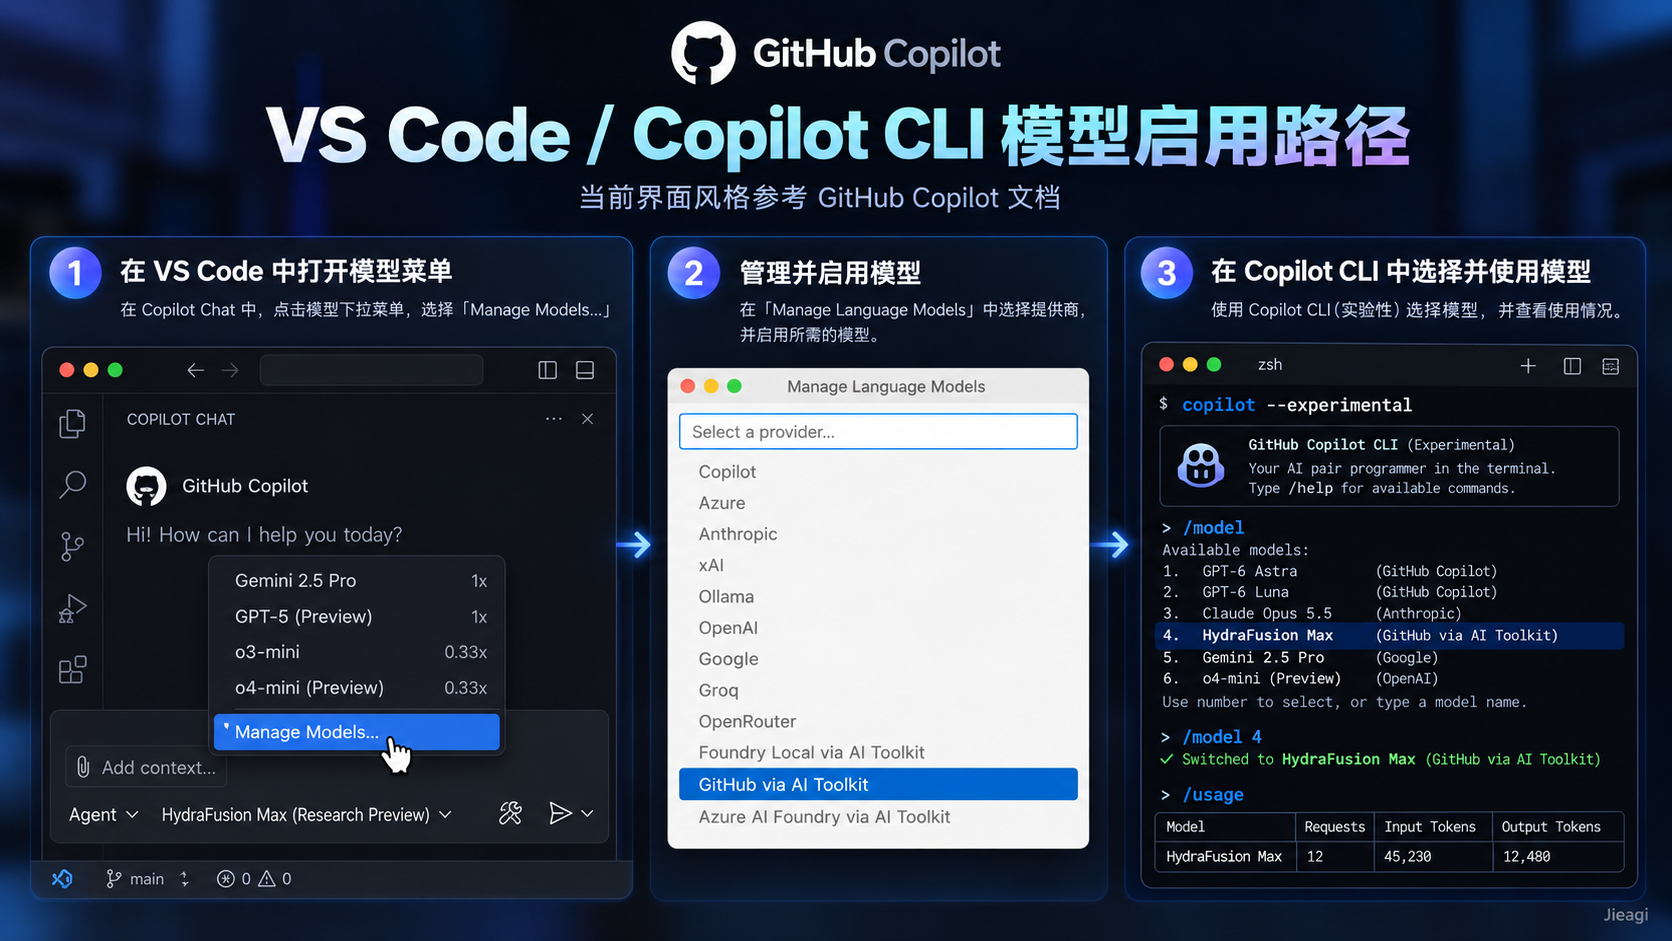
目前 GitHub 官方确认支持三个入口:
GitHub Copilot CLI、Visual Studio Code,以及 GitHub Copilot App。
开放套餐包括 Copilot Pro、Pro+、Business 和 Enterprise。
但用户还需要启用预览功能,并符合组织模型策略。
方法一:VS Code 启用
第一步,确保 VS Code 版本为 1.140 或更高,或者使用 VS Code Insiders。
第二步,打开设置:
Windows / Linux:
Ctrl + ,
macOS:
Command + ,
第三步,搜索:
chat.copilot.hydraFusion.enabled启用对应选项。
第四步,打开 Copilot Chat。
第五步,在模型选择器中选择:
HydraFusion
或者:
HydraFusion Max
第六步,输入具体编程任务。
例如:
请检查当前项目的登录模块,重点分析身份验证、Session 处理和异常分支。先给出修复计划,然后进行最小必要修改并运行相关测试。不要修改数据库结构。
执行过程中,Copilot 会展示所选择的工作流及处理阶段。
方法二:Copilot CLI 启用
先更新 Copilot CLI:
copilot update然后以实验功能模式启动:
copilot --experimental在 CLI 中输入:
/model选择 HydraFusion 或 HydraFusion Max。
也可以在支持的环境中使用单次调用:
copilot --experimental --model hydrafusion \
  -p "检查当前项目的错误处理,并提出最小修复方案"
如果已经进入 CLI 会话,也可以尝试开启实验功能,然后重新启动 CLI:
/experimental on方法三:GitHub Copilot App
更新到当前版本。
进入:
Settings → Experimental
启用 HydraFusion。
然后在模型选择器中选择普通版或 Max。
如果没有看到对应选项,应首先检查套餐、实验功能开关和组织策略。
八、HydraFusion Max 怎么收费?
GitHub 官方文档明确说明:
HydraFusion 本身没有独立附加收费,但会根据实际使用的各个模型按标准价格计费。
并且不能使用普通 Auto 模型选择功能的对应折扣。
因此,如果某个任务实际使用三个模型阶段,费用可能高于只调用一个模型的情况。
可以用一个简化公式理解:
总成本 = 草稿模型调用费用 + 审查模型调用费用 + 修复模型调用费用。
是否划算,需要结合整个任务的完成质量和重复工作量判断。
例如某个任务使用单模型虽然便宜,但经常失败,需要开发者不断重试。
那么增加审查步骤以后,整体成功任务成本可能反而降低。
但对于普通小任务,多模型审查也可能只是增加费用。
Copilot CLI 用户可以通过以下命令查看本次使用情况:
/usage因此,建议在实际开发中比较:
任务成功率、执行时间、AI Credits 消耗,以及人工返工次数。
九、GitHub 的测试结果能证明什么?
GitHub 早期 HydraFusion 研究曾使用 TerminalBench 2.1、DeepSWE 和 CheckpointBench 等编程评测。
在 2026 年 9 月公布的研究配置中:
| 基准 | 相比 Claude Opus 5 的质量变化 | 估算工作流成本变化 |
|---|---|---|
| TerminalBench 2.1 | +4.9 个百分点 | 降低 67% |
| DeepSWE | -1.5 个百分点 | 降低 36% |
| CheckpointBench | -0.1 个百分点 | 降低 65% |
但需要注意:
这些结果来自 9 月公布的特定离线实验,并非对 10 月 14 日 HydraFusion Max 新模型池的重新评测。
不能据此直接宣称新版 Max 已经在所有代码任务中降低了 67% 的成本。
真实生产表现仍需要持续验证。
十、使用 HydraFusion Max 有哪些限制?
目前有几个限制尤其值得开发者注意。
第一,仍处于研究预览。
GitHub 尚不为该研究预览提供正式 SLA,也不建议用于依赖服务承诺的生产工作负载。
第二,不等于自动生成子 Agent。
HydraFusion 的多模型编排,与 Copilot 的独立子 Agent 功能不同。
第三,丢弃的草稿不会自动撤销所有工作区修改。
这是一个容易被忽视的问题。
即使某个模型生成的草稿最终没有被采用,它之前已经执行的文件修改,也不一定自动回滚。
因此,开发者在提交代码之前仍需检查:
git status
git diff
并运行相应测试。
第四,上下文窗口并不是所有模型上下文的总和。
HydraFusion 每一步仍然受到具体模型的上下文限制。
不能因为使用多个模型,就认为上下文容量可以简单相加。
十一、什么时候值得选择 HydraFusion Max?
更适合 Max 的任务包括:
复杂 Bug 修复、跨模块架构修改、安全敏感代码审查,以及需要深入推理的软件工程问题。
不太适合默认使用 Max 的任务包括:
简单代码解释、短函数生成、文案调整和普通格式转换。
对于企业团队,还应该关注模型使用策略和敏感代码处理边界。
如果项目有明确的模型供应商限制,HydraFusion 使用的模型也必须符合组织策略。
十二、常见问题
HydraFusion Max 是新的 GPT 或 Claude 模型吗?
不是。它是 GitHub 的多模型编排功能。
HydraFusion Max 可以免费使用吗?
需要符合条件的 Copilot 套餐与预览资格,模型调用会消耗相应 AI Credits。
支持 JetBrains 吗?
截至 10 月 14 日,HydraFusion 官方列出的三个入口是 VS Code、Copilot App 和 Copilot CLI,不能据此认定 JetBrains 插件已经直接支持。
可以手动指定 Claude 和 GPT 各负责什么吗?
HydraFusion 本身会动态选择执行模式和模型,当前不提供逐阶段自由指定模型的完整控制能力。
会自动回滚失败代码吗?
不能保证。开发者必须检查工作区修改。
十三、总结
HydraFusion Max 的推出,代表 AI 编程工具正在探索新的能力组织方式。
过去我们重点关注单个模型的编程能力。
现在,GitHub 开始把模型选择、执行流程和推理资源分配整合在一起。
对于复杂软件工程任务,未来的重要竞争力可能不只是拥有最强模型,而是如何让不同模型在合适的阶段发挥作用。
不过,HydraFusion Max 目前仍是研究预览。
建议开发者先在非生产项目中测试,并综合评估质量、延迟、安全和费用,再决定是否纳入长期工作流。
官方参考资料
GitHub 10 月 14 日更新:https://github.blog/changelog/2026-10-14-hydrafusion-updates-and-new-max-option/
HydraFusion 官方使用文档:https://docs.github.com/en/early-access/copilot/hydrafusion
Project HydraFusion 原始研究:https://github.blog/ai-and-ml/project-hydrafusion-frontier-quality-via-multi-model-orchestration/
转载请注明出处: 界智通
本文的链接地址: https://www.jieagi.com/aizixun/158.html
-

GPT-5-Codex保姆级教程:获取OpenAI APIKey与安装 Codex CLI使用教程全面指南
2025/09/17
-
2025最新:Claude Pro 与 Max 区别详解与订阅指南
2025/08/26
-
Gemini 报错 "Something went wrong" 终极解决指南
2025/11/27
-
Cursor权威指南:从注册入门到精通AI驱动编程工作流(含国内注册与验证说明)
2025/08/27
-
2025最新保姆级教程:如何获取Claude API Key?从注册到Python调用,一篇搞定!
还在为如何申请 Claude API Key 而头秃吗?随着 Claude 4.5 Sonnet 在编程能力上的强势崛起,越来越多的开发者开始转向 Anthropic 的阵营。本文将通过“保姆级”的图文实操,带你一步步解决账号注册、手机号验证、API Key 获取及额度充值等难题,并附带 Python 极简调用示例。无论你是想接入 LangChain 还是自己在这个强大的模型上跑 Demo,这篇文章都能帮你避开 99% 的坑!
2025/11/15
-
【实测有效】Gemini 3 / Google Antigravity 授权登录无反应、无权限?全平台解决办法汇总指南
2025/11/22
-
WorkBuddy 高阶进阶全解:获取OpenAI Key自定义 API + SKILL.md 封装,效率直接翻倍
2026/04/19
-
[2025最新] ChatGPT Plus 订阅终极指南:四种充值方案与深度解析:为什么它值$20?
2025/11/13
-
Google AI Pro 有什么功能?Google AI Pro 生态系统深度报告以及订阅会员权益功能全面分析
2025/11/29
-
Grok-4.1 深度拆解:马斯克的“叛逆”AI怎么接入?xAI Grok API Key 获取及开发攻略
想要体验马斯克旗下xAI的Grok大模型?本文详细拆解 Grok API Key 获取的全流程,从账号登录、控制台设置到API Key生成,并附带完整的Python调用代码示例。解决开发者在申请过程中遇到的支付、权限等常见问题,助你快速将“叛逆”的Grok集成到自己的应用中。
2025/11/18


暂无评论
太好看了,快点更新!
国内开发者玩转Claude:最新Claude 4模型解析与API Key获取攻略
这是系统生成的演示评论
国内开发者玩转Claude:最新Claude 4模型解析与API Key获取攻略