
Genie 4 深度解析:Google 新一代世界模型如何实现实时交互、原生音频与物理模拟?
2026 年 10 月 27 日,Google DeepMind 发布 Genie 4 世界模型研究预览。本文解析实时世界生成、自然语言控制、物理模拟、原生音频、Gemini 协同推理及游戏和机器人领域的应用前景。
目录 · 17 节
一、从生成视频到生成世界:Genie 4 正式亮相
2026 年 10 月 27 日,Google DeepMind 发布新一代世界模型 Genie 4。
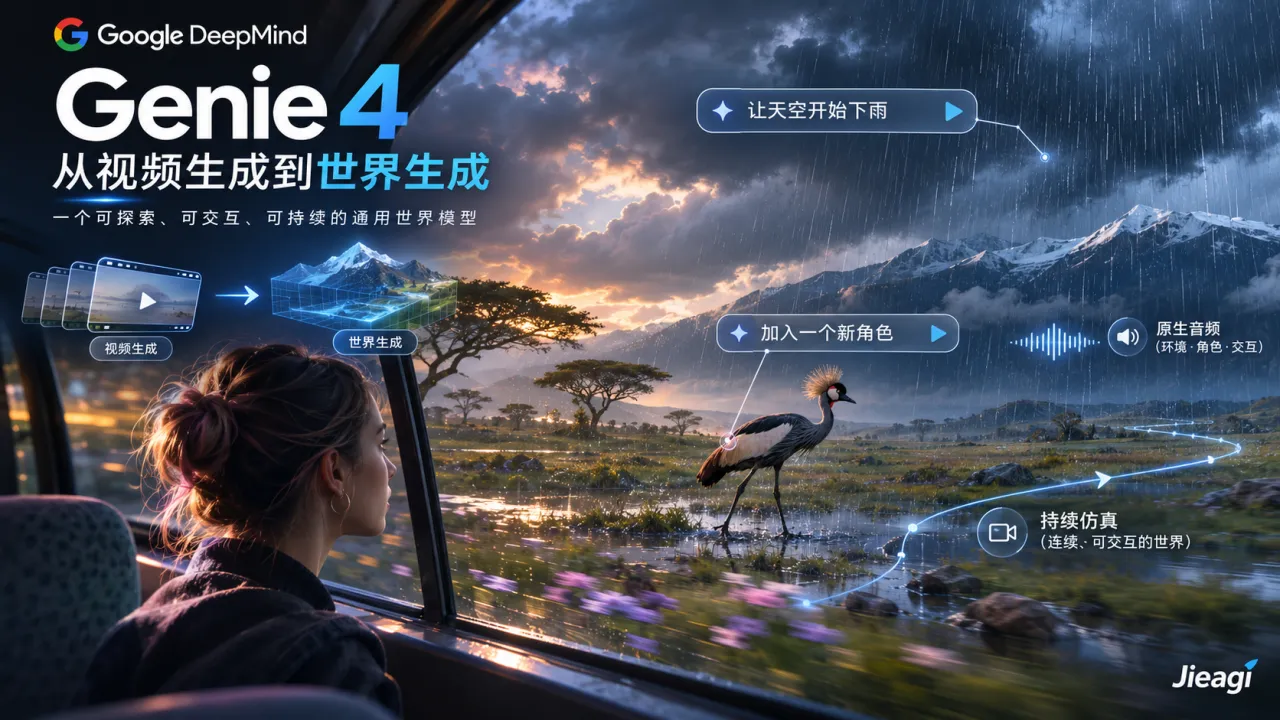
与传统 AI 视频生成模型不同,Genie 4 不仅能够生成连续画面,还能够根据用户操作实时改变虚拟环境。
例如,用户可以进入 AI 生成的场景,通过键盘控制视角移动,或者使用自然语言要求系统改变天气、加入角色、调整环境中的事件。
模型会尝试让场景中的视觉、声音和行为随着这些变化持续演化。
这意味着 AI 生成内容正在从被动观看的视频,向可以探索、操作和影响的交互式环境发展。
Genie 4 的意义不只是视觉质量提高,更在于尝试建立一种能够模拟环境变化及行为结果的生成系统。
二、Genie 4 的四项核心能力
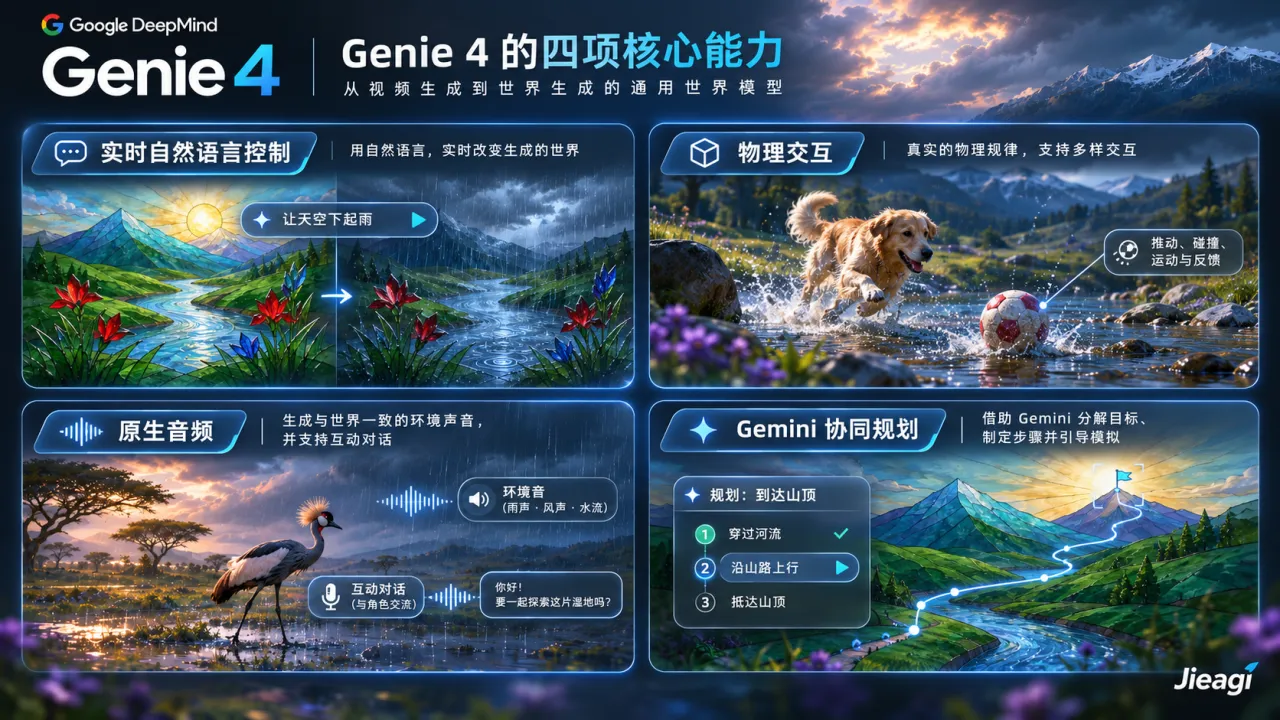
1. 实时自然语言控制
用户不需要重新生成整个视频,就可以在运行中的环境里提出修改要求。
例如:
“让天空开始下雨,并让人物跑进附近的建筑物。”
Genie 4 可以尝试将新指令融入正在发展的场景。
这种能力有利于创意设计、游戏原型和交互式内容制作。
2. 更真实的物理交互
传统视频生成模型主要关注画面连续性,但世界模型还需要考虑物体之间的相互作用。
Genie 4 尝试模拟碰撞、空气动力学、水流以及人物动作等现象。
不过,这不意味着它已经成为高精度物理引擎。对于需要严格物理正确性的工程模拟,仍然需要独立验证。
3. 原生音频生成
Genie 4 能够在生成场景的同时生成环境声音,包括风声、海浪声以及人物对话。
相比先生成视频、再额外添加音频的流程,原生音频有望提高场景的整体一致性。
尤其值得关注的是交互式对话:虚拟人物可以尝试根据用户行为和环境事件调整回应。
4. Gemini 辅助复杂事件规划
Genie 4 并非孤立工作。
Google 介绍,Gemini 模型能够参与场景理解、任务规划和执行结果检查。
其中,Gemini 3.8 Flash 可以在循环中观察场景、分解任务并检查进度;Google 也展示了 Gemini 4 Argon 与 Genie 4 协同模拟机器人任务的研究案例。
这种组合体现出两类模型的分工:
语言与推理模型负责理解目标、规划步骤;世界模型负责生成环境及其动态变化。
三、Genie 4 和普通 AI 视频模型有什么区别?
| 维度 | 传统 AI 视频生成 | Genie 4 世界模型 |
|---|---|---|
| 主要目标 | 生成可观看的视频 | 生成可交互的环境 |
| 用户交互 | 通常以提示词和编辑为主 | 支持实时操作与引导 |
| 场景变化 | 常需重新生成或编辑 | 尝试持续响应用户操作 |
| 物理行为 | 主要体现为画面表现 | 更强调环境行为和因果连续性 |
| 应用方向 | 影视、广告、短视频 | 游戏原型、仿真、Agent 训练、创意制作 |
这不是说世界模型一定会取代视频生成模型。
二者可能长期并存:视频模型适合高质量内容制作,世界模型则更适合需要互动和环境反馈的任务。
四、Genie 4 在哪些行业最有价值?
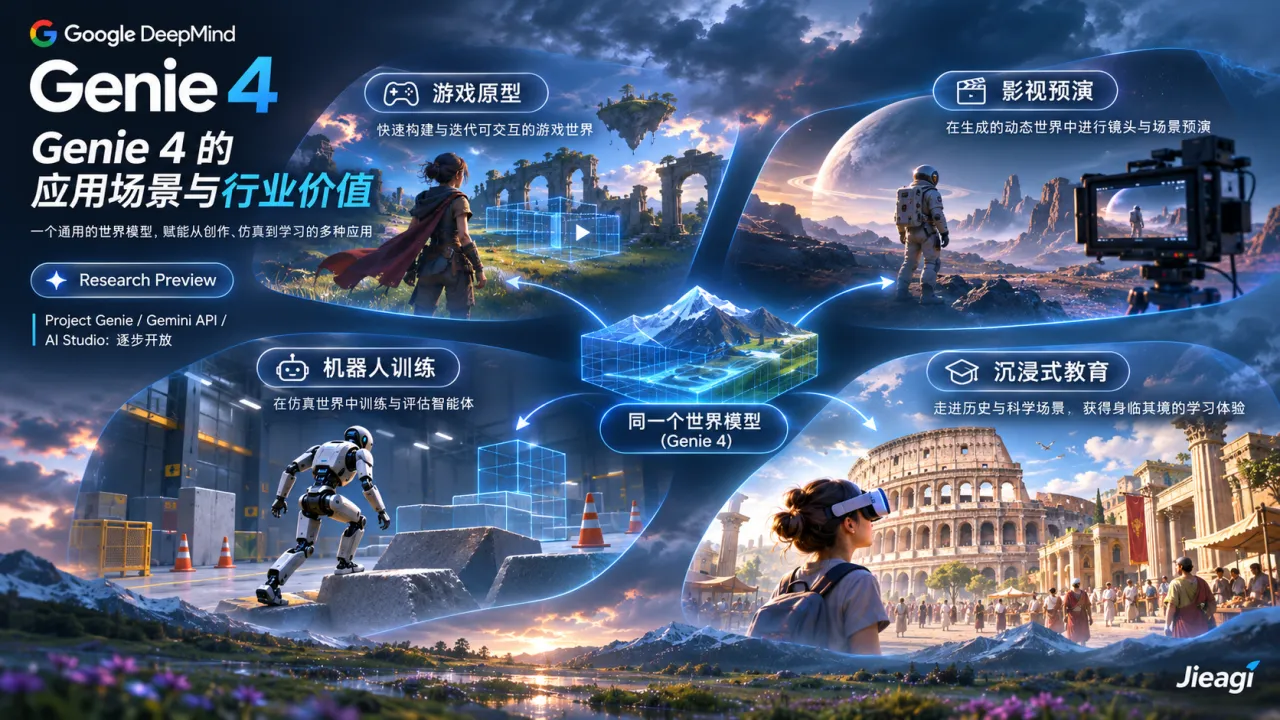
游戏开发
游戏开发者可以使用自然语言快速构建可探索的场景原型。
过去,一个初步的交互环境可能需要美术、程序和关卡设计协作完成。
世界模型有望缩短早期创意验证周期,让团队更快判断一个游戏概念是否值得继续开发。
但在角色控制、碰撞精度、长期一致性等方面,现阶段仍不能简单替代成熟游戏引擎。
影视预演
导演可以尝试在实时环境中调整摄影机位置、光线和人物行为。
相比静态分镜,交互式场景更容易帮助团队讨论镜头设计。
这种用途尤其适合早期预演,而不是直接保证生成最终可交付的影视素材。
机器人训练
机器人需要理解真实世界中的物体、空间和动作结果。
如果世界模型能够生成丰富、可控的环境,就有机会为机器人和 AI Agent 提供更多训练与测试场景。
例如,研究人员可以模拟不同障碍物布局、人物活动和环境变化,观察 Agent 的行为策略。
然而,虚拟环境中的成功不等于现实世界中的成功。仿真与现实之间的差异仍然是机器人研究的重要挑战。
教育与历史展示
Genie 4 也可能用于交互式历史场景、教学模拟和沉浸式学习。
用户不再只能观看预先制作好的视频,而是能够主动探索环境。
对于历史内容,必须区分基于资料的事实重建与 AI 补全的想象内容,避免把生成场景误认为真实历史记录。
五、Genie 4 已经开放 API 吗?
截至 2026 年 10 月 27 日的官方公告,Genie 4 首先作为研究预览向受信任测试者开放。
Google 表示,后续计划逐步向 Project Genie 中的 Google AI Ultra 订阅用户,以及 Gemini API、Google AI Studio 的早期合作伙伴扩展。
因此,不能把 Genie 4 描述为已经面向所有开发者正式开放的通用 API。
开发者也不应根据研究演示自行假定模型 ID、价格或调用接口已经公开。
六、目前仍然存在哪些限制?
Google 明确承认 Genie 4 仍处于早期研究阶段。
首先,长时间运行时,场景细节和物体持续存在的一致性可能发生漂移。
其次,多次复杂提示词修改可能使环境出现不符合预期的变化。
此外,复杂物理交互、实时音频准确性、文字渲染、空间精度和长期一致性仍是研究重点。
因此,Genie 4 展示的是技术方向和研究能力,而不是已经成熟的商业级虚拟世界平台。
七、AI 世界模型未来会走向哪里?
Genie 4 展示了一种值得关注的技术路线:将语言模型的规划推理能力,与生成模型的感知和环境模拟能力结合。
未来的 AI Agent 可能不再只能通过文本或固定工具接口执行任务,而是可以在动态环境中观察、尝试、反馈和调整。
这对于机器人、自动化测试、数字孪生和交互式娱乐都具有研究价值。
不过,世界模型要真正进入工业级应用,还需要解决可重复性、物理准确性、环境稳定性、安全性以及成本问题。
八、常见问题 FAQ
Genie 4 是视频生成模型吗?
它属于世界模型,能够生成视觉和音频内容,但更强调环境的实时交互与动态变化。
普通用户可以直接使用吗?
发布时主要面向受信任测试者,其他用户需要关注后续开放安排。
Genie 4 能替代 Unity 或 Unreal Engine 吗?
目前不能。它可以用于原型和仿真探索,但成熟游戏引擎在精确控制、稳定性和工程交付方面仍具有重要优势。
Genie 4 可以用于机器人吗?
Google 已展示相关研究方向,但实际机器人部署仍需要现实环境验证。
九、总结
Genie 4 的发布说明,生成式 AI 正在尝试跨越传统视频生成的边界。
从静态画面到动态视频,再到可以实时控制的环境,AI 内容生成正在逐步获得更强的交互性。
对于开发者而言,值得关注的不只是画面是否逼真,更是模型能否保持环境一致性、理解行为结果,并与推理型 Agent 协同完成复杂任务。
官方来源:
Google DeepMind — Genie 4: A new generation of world simulation https://deepmind.google/blog/genie-4-a-new-generation-of-world-simulation/
Google DeepMind — Genie 4 模型介绍 https://deepmind.google/models/genie/
转载请注明出处:界智通 · https://www.jieagi.com/aizixun/229.html
关注 AI 前沿动态,分享模型、工具与实战教程。
暂无评论