
32GB内存跑180B MoE:HF流式推理与Strata/vLLM评测
Hugging Face 开源 Transformers MoE 专家流式推理(PR #50717),在 32GB 内存 MacBook 上以 13.9 tok/s 跑起 180B 参数 Qwen3.8-Flash-Next。本文深度对比 Strata、llama.cpp 与 vLLM 实测性能。
目录 · 7 节
32GB 内存跑 180B MoE:Hugging Face experts_offload 与 Strata/vLLM 实测对比
2026 年 11 月 18 日,Hugging Face 工程师 Tarek Ziadé 发布技术实测博客 180B Parameters, 32GB of RAM: Pushing MoE Inference to the Limit with Transformers,并提交了核心 PR huggingface/transformers#50717:仅用一台 32GB 统一内存的 MacBook M5,在标准 Python + Transformers 框架下,以 13.9 tok/s 的生成速度与 228 tok/s 的首字预填充速度跑起了 180B 参数的 Qwen3.8-Flash-Next,距离专用原生 C++/Metal 引擎 Strata 仅差 6%!
对于想在消费级笔记本或单卡 24GB 显卡上本地运行百亿/千亿级稀疏 MoE 模型的开发者而言,这次更新彻底改变了“Transformers + Accelerate 离线卸载只能跑 0.16 tok/s”的刻板印象。下面结合官方实测数据,对五大主流推理后端做一次硬核对比。
一、五大推理引擎横向对比:Qwen3.6-35B-A3B 基准测试
当 MoE 模型权重超出显存时,决定速度的核心有三个问题:专家权重放哪里、专家矩阵乘法在哪算、每个 Token 搬运多少数据。Hugging Face 在单张 NVIDIA A10G(24GB 显存,充足主机内存) 上对 Qwen3.6-35B-A3B 进行了统一对比 Hugging Face Blog:
| 推理引擎与配置 | 量化/精度 | Decode 吞吐(tok/s) | 核心瓶颈与工程特点 |
|---|---|---|---|
| Strata | Q8_0 |
82 – 88 | 仅热点专家驻留显存,原生事件同步开销极低 |
llama.cpp(--fit on) |
Q8_0 |
63 – 64 | 专家放 CPU 内存直接计算,仅激活值过 PCIe;但内存装不下时会触发 Page Cache 抖动 |
llama.cpp(--fit on) |
BF16 |
35 – 36 | 同上,精度翻倍导致 CPU 内存带宽吃紧 |
vLLM(--cpu-offload-gb 16 --cpu-offload-params experts) |
FP8 |
20.1 | 仅卸载路由专家,性能直接翻倍;但无专家缓存,热点专家每步重复跨 PCIe |
vLLM(默认全卸载 --cpu-offload-gb 16) |
FP8 |
9.7 | 连带稠密层一起卸载,每步额外搬运大量非稀疏权重 |
vLLM(--cpu-offload-gb 50) |
BF16 |
3.3 – 7.3 | 带宽受限,仅适合大 Batch 吞吐而非单用户低延迟 |
| 旧版 Transformers + Accelerate | BF16 |
0.16 | 按整层模块搬运全部专家(哪怕本步只激活 8–10 个),无缓存无路由感知 |
从上表可以直观看出两个实战结论:
- 如果专家权重能完整塞进主机 RAM:
llama.cpp依然极难被超越(仅激活值过 PCIe,权重不动); - 用 vLLM 做单卡卸载时,务必加上
--cpu-offload-params experts:否则把稠密层一起踢出显存,速度会直接腰斩(20.1跌至9.7 tok/s)[内链:vLLM 与 llama.cpp 显存卸载参数调优]。
二、极限挑战:32GB Mac 跑 180B 模型,experts_offload 凭什么追平 Strata?
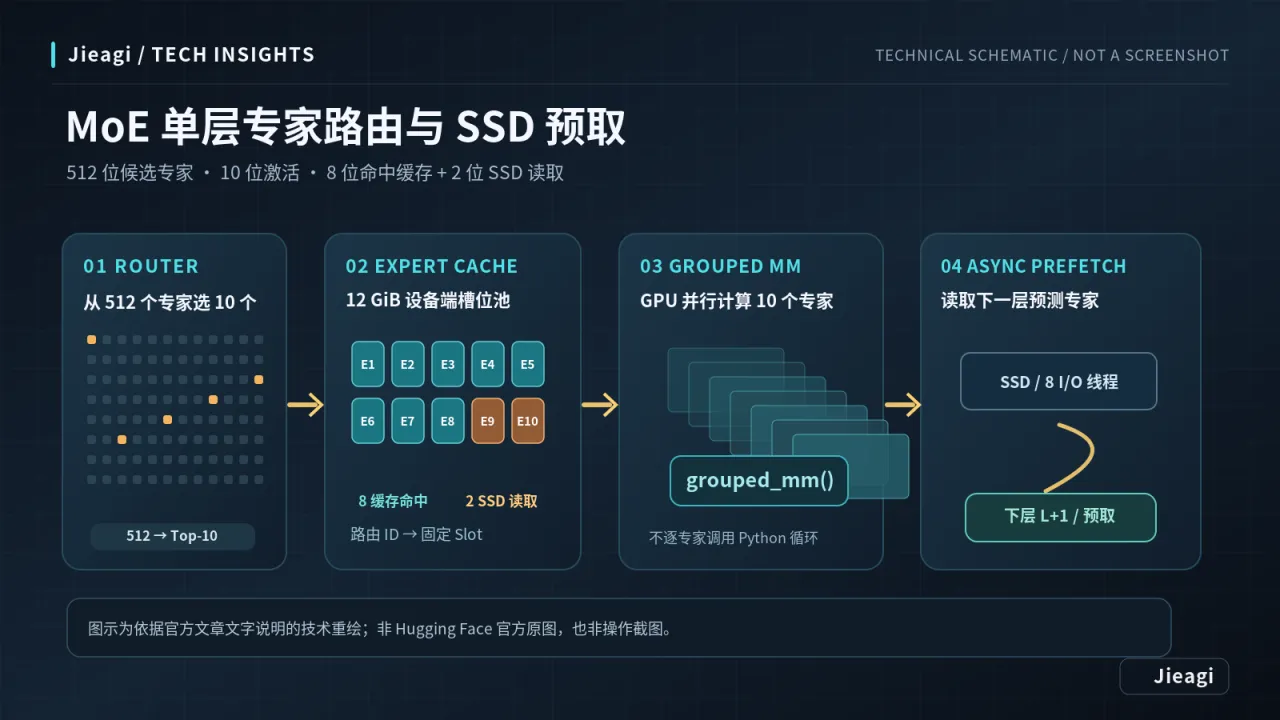
当模型升级到 Qwen3.8-Flash-Next(180B 参数,48 层,每层 512 个专家、每次激活 10 个,FP8 下仅专家权重就达 121GB,外加 51GB 的 n-gram 嵌入表) 时,32GB 内存连 RAM 都装不下,必须直接从 SSD 流式读取。
在此场景下,vllm-metal 因为无法流式卸载 32GB 的 n-gram 嵌入表而无法在 32GB 机器启动。Hugging Face 新方案(transformers#50717 + moe-expert-streaming)通过四项关键设计打破了瓶颈:
- Slot Pool 预分配槽位池(核心创新):不在 Python 循环里逐个执行激活的专家,而是预先在设备端分配固定张量槽位池,将路由器选出的 Expert ID 动态重映射到槽位,直接复用原生
grouped_mm单核并发算子; - 3-bit 离线专家量化 + 8-bit 稠密层:将 121GB 专家压缩至 49GB 磁盘占用(设备端缓存
12 GiB),稠密层压缩至5.4 GB(困惑度仅增加+0.2%),n-gram 表留存磁盘按行读取;整体加载仅占约 18 GiB 内存,6K 长文本推理峰值 25.4 GiB; - 8 线程并发 SSD 预取与提前路由:用当前隐状态提前两层运行路由器,猜测并异步预取下一层专家;在 SSD 空闲周期主动预读 1 个猜测专家;
- MPS 早期提交与定制 Metal Kernel:在每个 Block 后强制提交 GPU 工作避免 Python 排队空转,并利用
torch.mps.compile_shader动态编译 Gated DeltaNet 等算子。
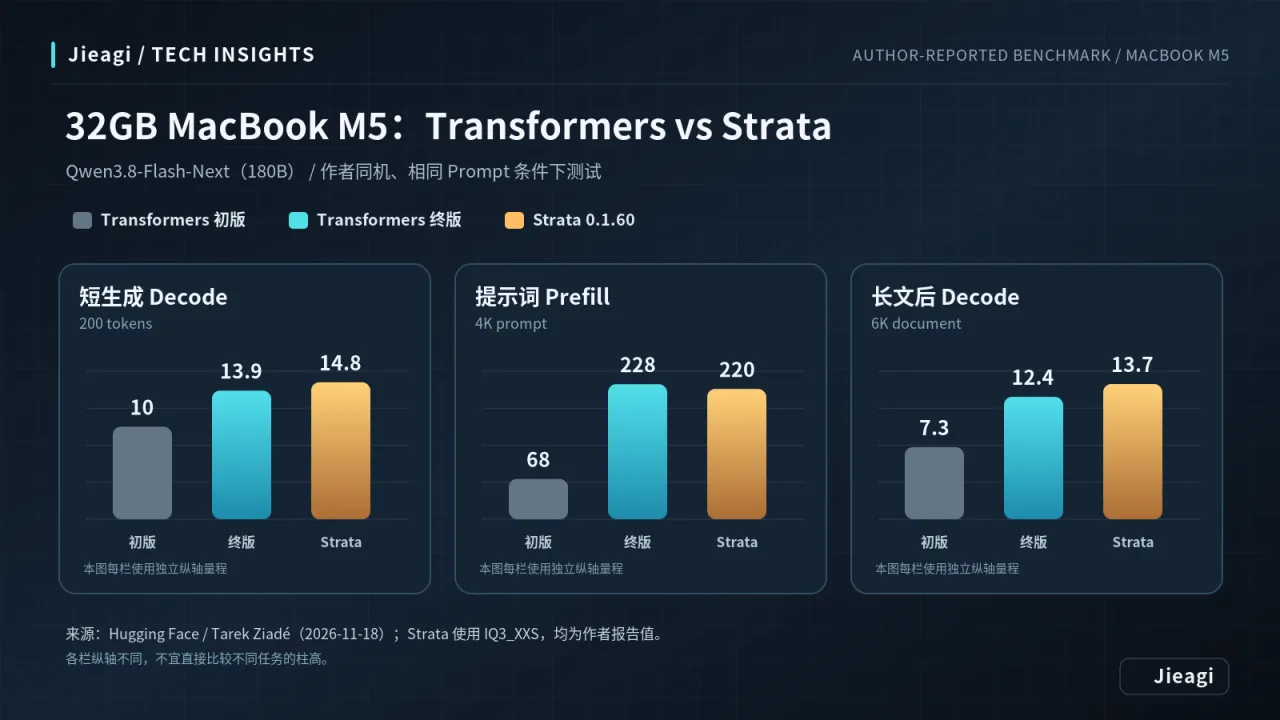
32GB MacBook M5 实测最终对比(Qwen3.8-Flash-Next)
| 测试场景 | Transformers(初版) | Transformers(终版优化) | Strata 0.1.60(IQ3_XXS) |
与 Strata 差距 |
|---|---|---|---|---|
| 短生成 Decode(200 tokens) | 10.0 tok/s |
13.9 tok/s |
14.8 tok/s |
仅慢 6%(1.06x) |
| 4K 提示词 Prefill | 68 tok/s |
228 tok/s |
220 tok/s |
反超 Strata(1.0x) |
| 6K 文档后 Decode | 7.3 tok/s |
12.4 tok/s |
13.7 tok/s |
约 1.1x |
三、开发者上手代码与选型建议
如果你想在本地尝试 experts_offload,可直接从 PR 分支安装 Transformers 并运行如下代码(以官方最新合并文档为准):
pip install "git+https://github.com/huggingface/transformers.git@refs/pull/50717/head"import torch
from huggingface_hub import snapshot_download
from transformers import AutoModelForCausalLM
path = snapshot_download("tarekziade/Qwen3.8-Flash-Next-expert-streaming")
model = AutoModelForCausalLM.from_pretrained(
f"{path}/dense",
dtype=torch.bfloat16,
device_map={"": "mps", "experts.*": "disk"},
# 配合 Metal 8-bit 量化与 12GiB 专家缓存池
experts_offload={
"cache_bytes": 12 << 30,
"quantized_experts": f"{path}/experts-q3",
},
)客观评估与选型结论:
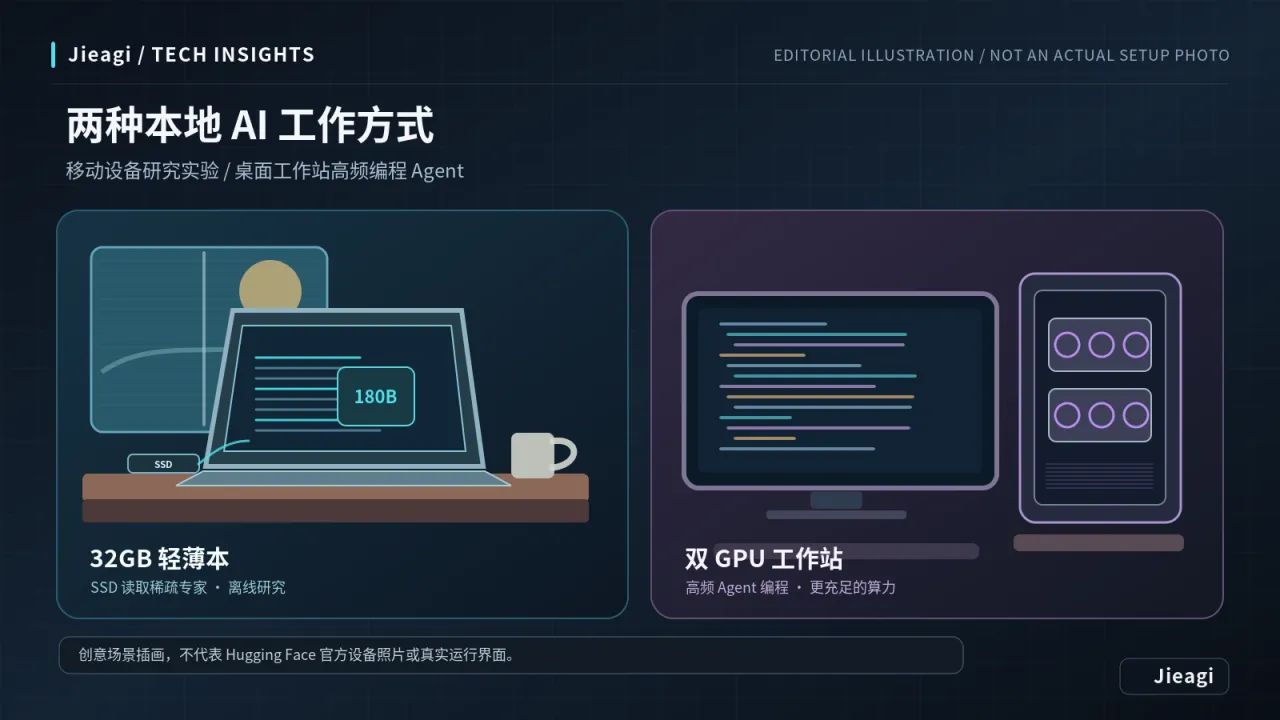
- 什么时候选它? 如果你需要对超大规模 MoE 模型的路由稀疏度、缓存命中率或算子做白盒研究,或者手头只有 32GB 统一内存笔记本想跑通 180B 模型做离线批处理与实验,
transformers#50717提供了无需写 C++ 扩展即可接近原生引擎的体验。 - 什么时候不选它? 作者本人也坦承,13.9 tok/s 对于高频交互的编码 Agent 依然偏慢(日常主力编码仍建议用云端 API 或双 RTX 4090 等大显存工作站);此外该 PR 的 API 形态仍在与 Transformers 维护者讨论中(未来量化配置可能并入
#50245统一计划),生产环境建议等待正式合入主线版本 [内链:本地编程大模型硬件配置与性价比测算]。
常见问题(FAQ)
Q1:32GB 内存跑 180B 模型,浏览器还能开着吗?
建议关闭。实测加载后基础内存占用约 18 GiB,处理 6K 上下文时峰值达 25.4 GiB,不关闭浏览器极易触发 macOS Swap 导致速度骤降。
Q2:为什么 Transformers 还有 6% 的差距追不上 Strata?
主要卡在每次生成约 10 ms 的宿主机往返同步开销。Strata 可以把整步计算预先排队并通过 Metal 共享事件同步,而 PyTorch 目前尚未暴露逐层原生异步流同步原语。
Q3:这个方案只支持 Apple Silicon(MPS)吗?
experts_offload 的通用磁盘流式加载与 Slot Pool 机制位于 transformers#50717 主体中,适用于标准 MoE 布局;但文中的 8-bit MetalConfig 与 Gated DeltaNet 加速 Kernel 属于针对 macOS MPS 的专项优化。
参考来源
转载请注明出处:界智通 · https://www.jieagi.com/aizixun/662.html

关注 AI 前沿动态,分享模型、工具与实战教程。
暂无评论