
OpenAI Performance Factory:Codex 自动排障架构拆解
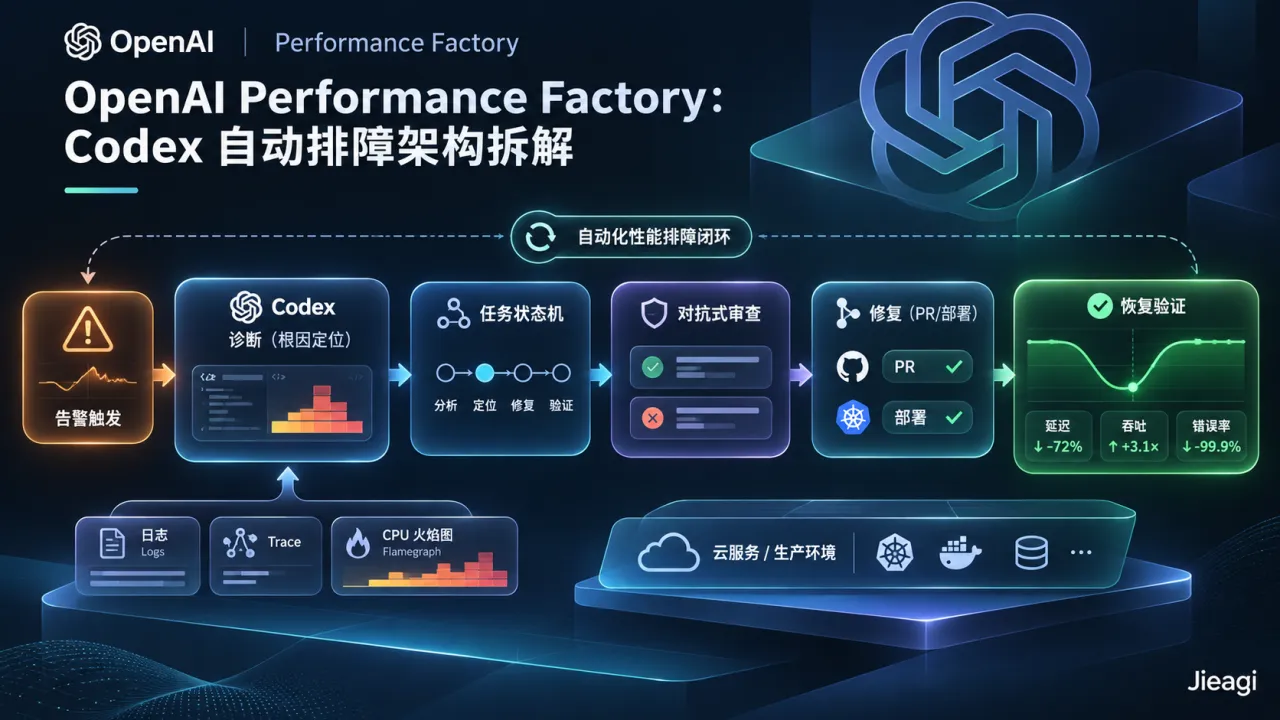
OpenAI 公开内部 Performance Factory 系统,通过任务状态机、调度循环、云端 Codex 与对抗式审查,3个月自动调查 1700+ 次 ChatGPT 性能回归并定位 600+ 根因。
目录 · 8 节
OpenAI Performance Factory 架构拆解:如何用云端 Codex 7×24 自动排查性能回归
2026 年 11 月 19 日,OpenAI 工程团队在官方博客发布长文 How OpenAI's Performance Factory keeps ChatGPT fast(同期 VentureBeat 亦进行了专题报道),首次完整披露了保障 ChatGPT 高并发低延迟的内部自动化系统——Performance Factory(性能工厂)。
当产品迭代因为 AI 编程而指数级加速时,传统靠资深 SRE 翻日志、抓火焰图的性能排查已经跟不上发版速度。OpenAI 给出的答案是:用云端 Codex Agent 接管“告警触发 → 根因定位 → 对抗式复核 → 提交修复 PR → 线上恢复验证”的完整闭环。过去三个多月,该系统已跟踪超过 1,700 次性能调查(平均每天 17 次),成功定位超过 600 个真实根因。
一、从人工排障到“Agent 工厂”的 6 个演进阶段
很多团队都在尝试用 AI 写运维脚本,但往往停留在“把报错贴进聊天框”。OpenAI 坦诚地复盘了内部性能团队走向全面自动化的 6 个台阶 OpenAI Engineering Blog:
- Pre-Codex(人工工具期):工程师积累了 30 多种 CPU/内存分析器(Profilers),但依然高度依赖个人对系统拓扑的记忆。
- Codex as a partner(结对排查):工程师能用自然语言问 Codex“为什么延迟变高”,但仍需人工决定调用哪个监控工具。
- Reusable skills(技能固化
perf-forensics):团队把排查经验写成共享技能perf-forensics,明确何时查发布记录、何时比对慢请求分组,并用历史故障做 Evals 回归测试。 - The human proxy(人类传话筒陷阱):当技能足够好用时,工程师发现自己沦为了“告警与 Codex 之间的复制粘贴工具”。
- Automated investigations(云端自动诊断):告警直接拉起云端 Codex 并将诊断发进 Slack,但随后 Slack 线程堆积如山,没人知道哪些回归修好了、哪些还悬着。
- The factory(有状态 Agent 工厂):最终演化出独立的任务状态机,让状态和证据脱离单次 Agent 会话持久化保存,在多个 Agent 与工程师之间无缝接力。
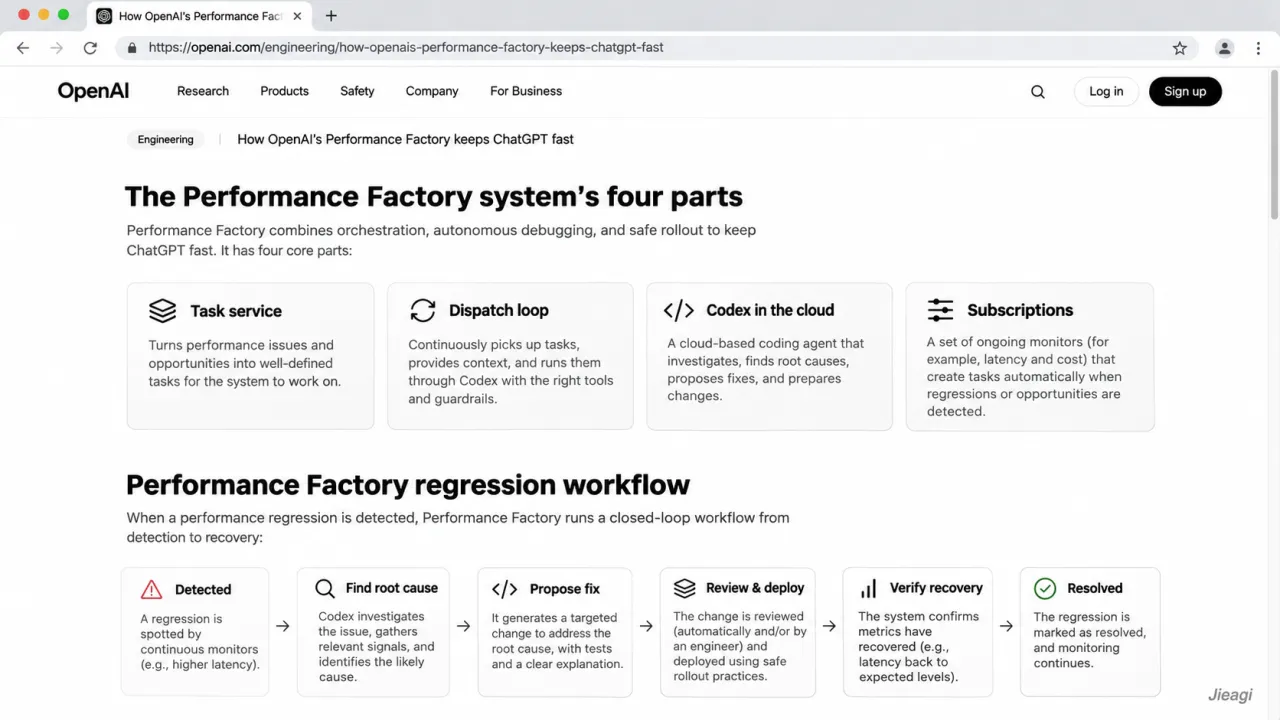
二、Performance Factory 四大核心组件拆解
OpenAI 的这套内部工厂并没有使用复杂的黑盒框架,而是由四个职责清晰的工程模块组成:
| 核心组件 | 职责与技术实现 | 工程价值 |
|---|---|---|
| 1. 任务服务(Task Service) | 用 config.toml 定义状态机与允许流转,用独立 Markdown(如 implementing.md、reviewing.md)定义每一步提示词 |
清晰界定哪些步骤由 Agent 推进、哪一步必须人工接管审批 |
| 2. 调度循环(Dispatch Loop) | 定期扫描就绪任务,按当前状态拉起对应的 Codex Turn 执行并推进状态 | 实现全异步、无状态阻塞的并发推进 |
| 3. 云端 Codex 执行环境 | 通过内部 API 在内网沙盒运行 Codex,以独立 Service Identity 授权访问代码库、Metrics、Logs、Traces 与 CPU 火焰图 | 无需占用工程师笔记本,且所有 Agent 操作可审计、权限可控 |
| 4. 事件订阅(Subscriptions) | 任务等待人工 Review 或发布部署时休眠,订阅 GitHub PR 评论、CI 失败或部署完成事件,触发后自动唤醒下一轮 Codex | 避免 Agent 空转烧钱,完美对接现有 CI/CD 与 GitHub 协作流 |
三、关键工程亮点:对抗式审查(Adversarial Review)与 70% 根因准确率
在推进自动化排障时,OpenAI 踩过一个非常典型的 LLM 坑:Agent 往往找到第一个“听起来合理”的解释就提前交卷了。例如在一次 ChatGPT 对话图片下载失败的排查中,调查 Agent 锁定了某个文件定位服务,但实际该服务早已恢复而图片依然报错。
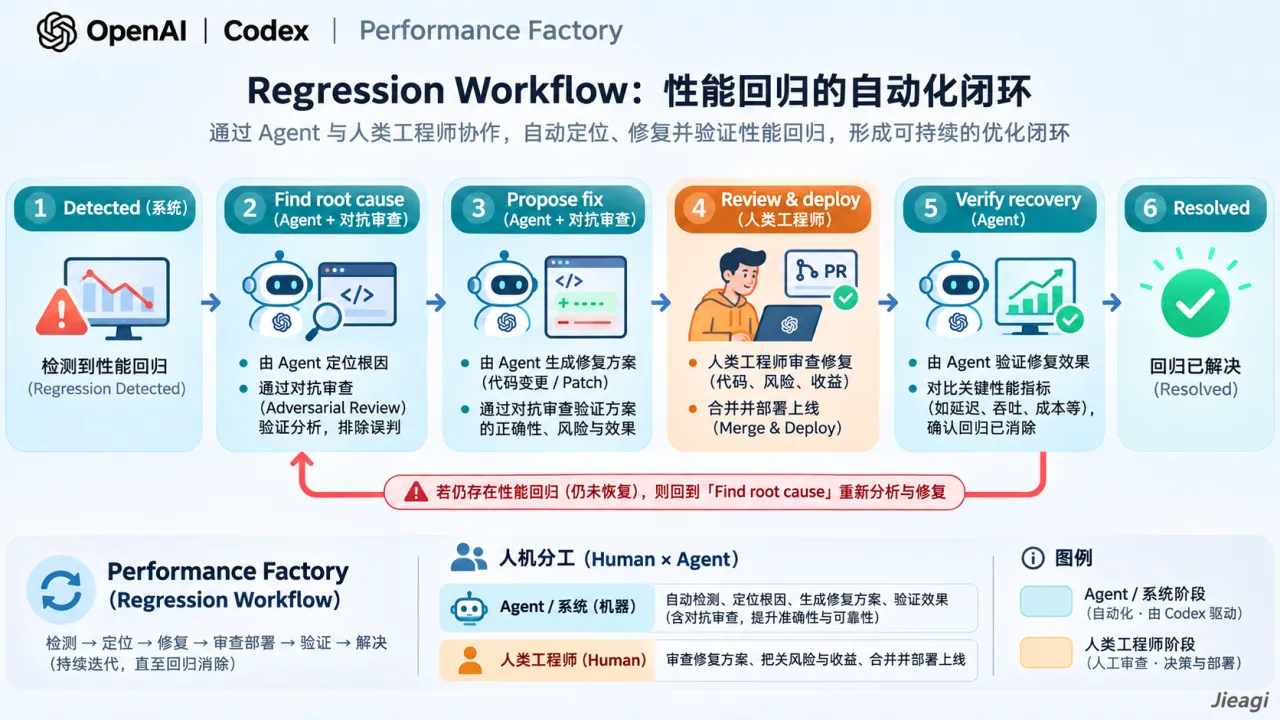
为此,OpenAI 在工作流中强制加入了对抗式审查(Adversarial Review)——由另一个独立的 Codex 会话专门扮演“挑刺者”,用反事实推理验证前者的结论:
- 如果怀疑是某次灰度发布导致的延迟飙升,未命中的对照组请求是否保持健康?
- 如果疑似变更已经回滚,指标是否真的同步恢复?
通过把长任务拆解为“调查 → 对抗质疑 → 编写修复 → 修复对抗审查 → 部署后验证恢复”等多个专注的短回合,OpenAI 人工抽检 100 份根因建议的结果显示:70% 完全准确,其余 30% 也提供了有价值的线索或需要进一步收敛因果链 OpenAI Engineering Blog。
四、给国内研发团队的 3 条可落地经验
- 保护工程师注意力,别把原始推理日志倒进群里:Codex 跑一次排查能吐出几千字日志。OpenAI 专门训练并评测“交接摘要质量”,要求报告必须精简、保留关键时间序列图与 CPU 火焰图,并按业务影响合并同类告警,让工程师只花精力做架构权衡,而不是去还原 Agent 的思考过程 [内链:LangSmith Coding Agents 产出归因与上下文管理]。
- 用历史故障做“无剧透”回测(Backtesting):更新排查 Skill 或升级模型前,必须用历史故障快照做回测——严格剥离恢复后的监控指标、历史记忆与复盘文档,分别评分“时间点/影响面定位是否准确”和“是否冤枉了无辜的发布”。
- 让 Agent 具备“工具链自愈”能力:如果监控分析器坏了或服务账号缺权限,排查 Agent 就会卡死。OpenAI 每天跑一个巡检 Agent 专门扫描失败日志,一旦发现同类工具报错多次阻塞调查,就自动建单让另一个 Codex 去修工具链本身。
五、局限与下一步方向
OpenAI 在文末也坦言,“写对修复代码比找对根因难得多”:部分性能问题涉及架构权衡(例如加缓存虽降延迟却可能引入脏数据),目前仍必须由熟悉业务的工程师最终拍板合并 PR。下一步,团队正探索用合成性能测试(Synthetic Tests)让 Agent 在提 PR 前先自测加速效果,并逐步把该工厂模式扩展到无告警主动巡检(直接比对跨版本 CPU/内存画像发现隐性退化)与副本数自动调优(Service Rightsizing)。
常见问题(FAQ)
Q1:Performance Factory 是 OpenAI 对外销售的商业产品吗?
不是。Performance Factory 是 OpenAI 内部基于云端 Codex API 与自研任务服务搭建的内部工程系统,但文中披露的任务状态机、perf-forensics 技能封装及对抗式审查架构可供外部团队直接借鉴。
Q2:OpenAI 的 Codex 修复 PR 会绕过人工直接上线吗?
目前不会。在当前的 Regression Workflow 中,Agent 负责定位根因并提出修复 PR,必须由人类工程师审查并决定是否合并部署,部署后再由 Agent 自动唤醒验证性能是否恢复基线。
Q3:为什么对抗式审查(Adversarial Review)在排障中这么重要?
单个 Agent 容易受“证实偏差”影响,找到首个看似相关的日志就停止探索;独立的审查 Agent 通过检查对照组与回滚时间线进行反证,能显著拦截误判。
参考来源
转载请注明出处:界智通 · https://www.jieagi.com/aizixun/717.html

关注 AI 前沿动态,分享模型、工具与实战教程。
暂无评论