
GPT-Live-1.1 上线 API,支持低价待机
OpenAI 开放 GPT-Live-1.1 语音 API,带来全双工会话和可配置的 WebRTC 待机。本文梳理活跃与待机计费、后端委派以及语音客服上线前应该验证的项目,并给出一分钟通话的成本示例。
目录 · 11 节
GPT-Live-1.1 上线 API,支持低价待机
11 月 20 日,OpenAI 宣布 GPT-Live-1.1 进入 API,同步介绍适用于 GPT-Live-1 和 GPT-Live-1.1 的 WebRTC 待机配置。新版此前已用于 ChatGPT Plus 和 Pro 的语音体验。本次面向开发者的新变化,是可以在自己的应用里指定模型 gpt-live-1.1,并决定闲置会话何时进入较低费率的状态。见 OpenAI 开发者公告。
全双工改变了什么
语音电话里,用户经常在听到一半就补充信息,例如“我说的是尾号 0467 的订单”。OpenAI 将 GPT-Live-1.1 定位为全双工语音模型,可以一边输出语音一边接收用户讲话。官方也报告了多语言发音、口音一致性和转写上的改善。客服团队应把订单号、地址、专有名词和说话重叠加入验收样本。即使转写有提升,交易编号也适合复述确认。见 模型文档。
待机时保持通话连接,按状态计费
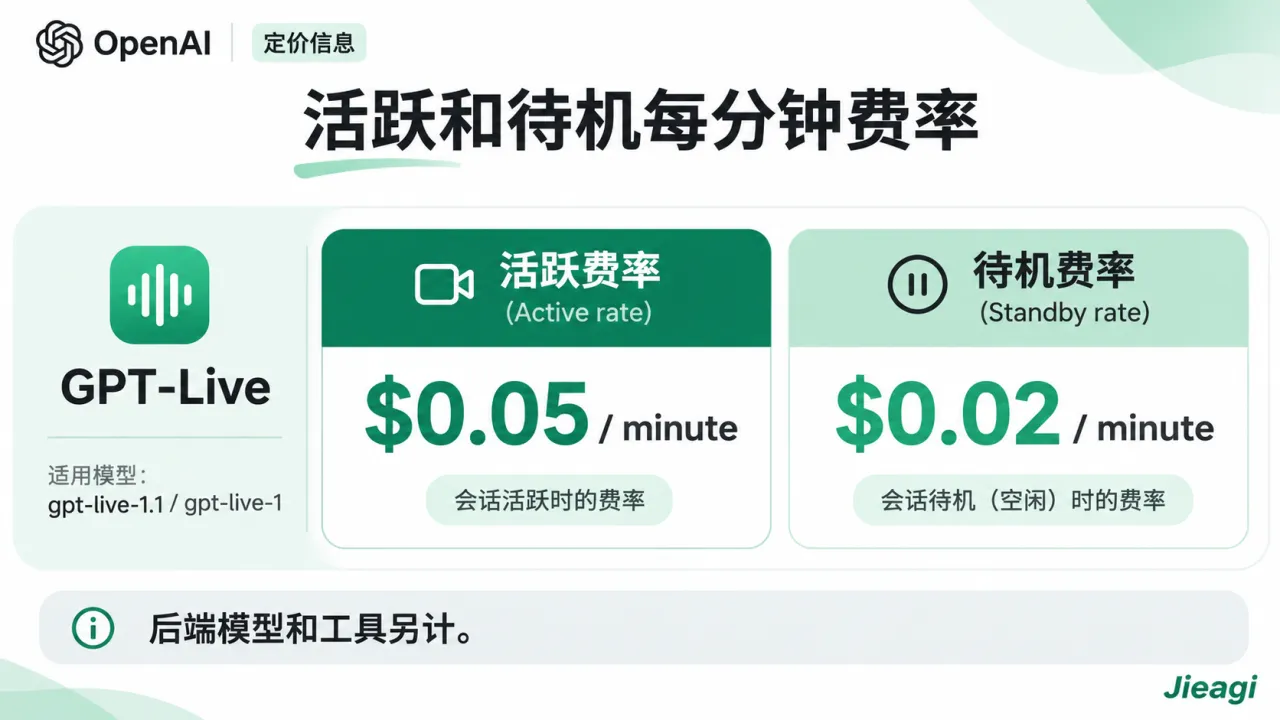
开发者可配置 5 至 60 秒的空闲阈值。达到阈值后,推理暂时暂停,WebRTC 通话连接保持打开,用户再次说话时会话恢复。官方给出的活跃和待机价格分别为每分钟 0.05 和 0.02 美元,后端模型与工具另计。
假设一次 60 秒通话有 40 秒在活跃状态(包含进入待机前的等待),20 秒实际处于待机。按公布单价做线性示意,两部分合计 0.04 美元。全程按活跃状态估算是 0.05 美元。这里展示的是计算方式,账单仍应按真实状态时长、计费细则及后端用量核对。见 官方价格页。
语音模型负责说话,业务后台负责办事
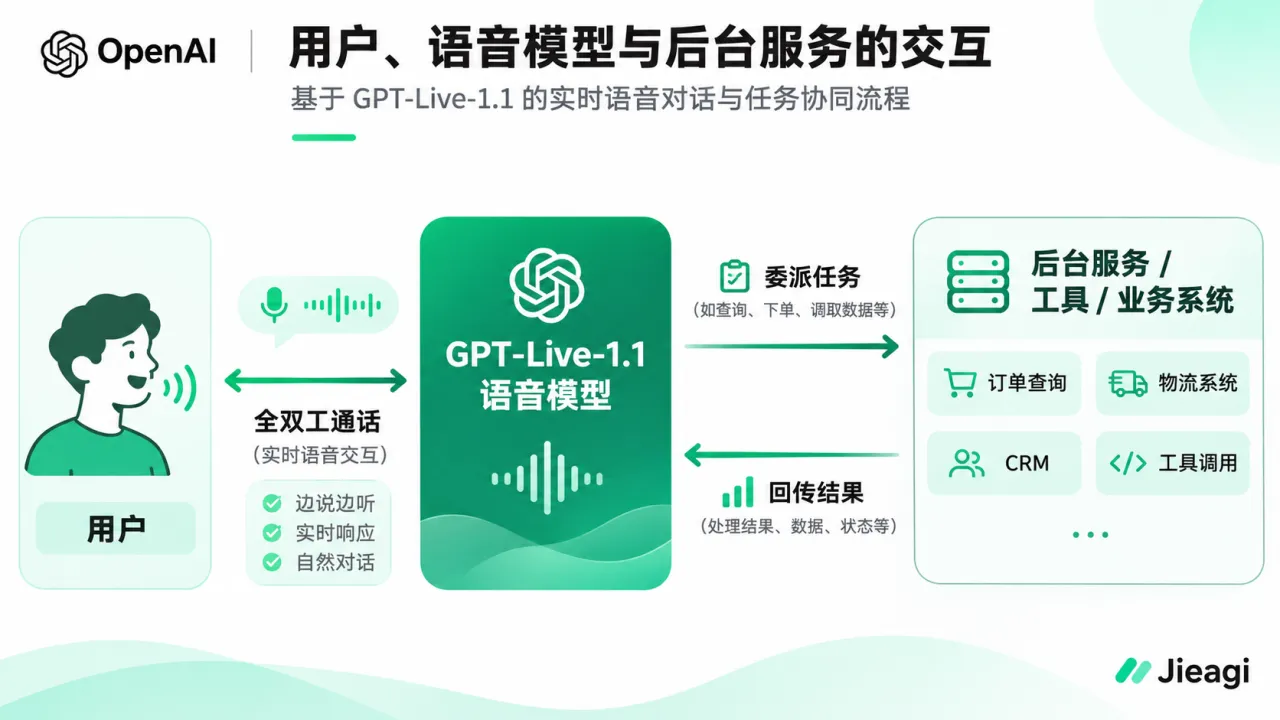
官方指南将语音模型与负责执行任务的后台分开。用户问订单到了哪里,前者维持对话,后者查询物流系统。应用决定调用哪个工具、用户是否具备操作权限,以及任务在对话被打断时是否继续。如果用户先让系统查询 A 订单,接着改成 B,团队应让后台标记请求对应的订单和会话轮次,避免较晚回来的 A 结果被当成 B 的答案。
怎样开始接入
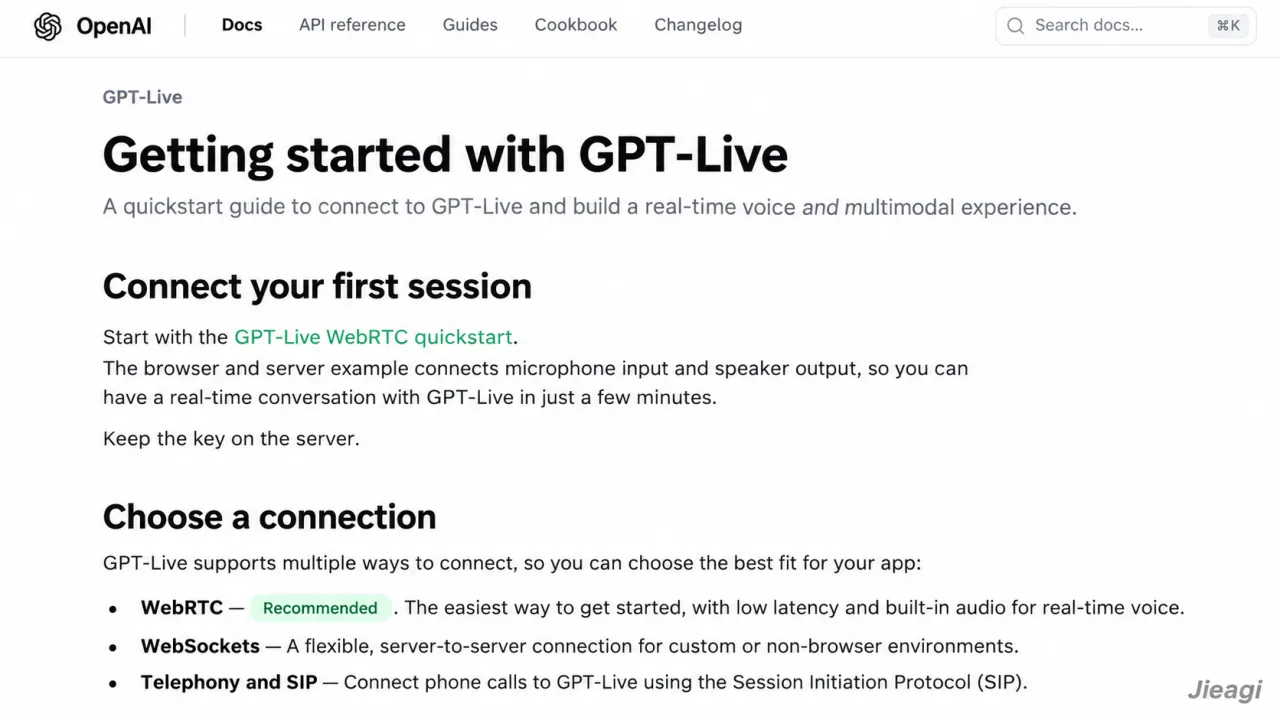
从官方 WebRTC 快速入门启动浏览器端麦克风与扬声器回路,再接一个只读业务工具。例如,先让应用查测试订单状态,分别检查语音连接、插话反馈、后台超时、结果复述。最后用两档阈值对同一批测试对话记录实际待机时长和恢复体验。若原有应用接的是普通文本聊天接口,应按 Live 的会话与事件文档重新接线。见 GPT-Live 接入指南。
编辑点评
待机是否省钱,取决于用户有多少时间停在阈值之后。客服若经常要等用户翻找资料,待机可降低这段时间的语音层费率。若多数对话一直在说话,最值得关注的指标会是插话处理、数字复述和后台返回的正确率。上线前把这三类指标与费用分开记录,才便于判断模型升级的实际收益。
常见问题
每种传输方式都有待机费率吗?
本次公布的待机费率针对 WebRTC 会话。
GPT-Live-1 可以待机吗?
可以。官方公告将 GPT-Live-1 与 GPT-Live-1.1 都列为适用模型。
语音费包含后台模型和工具吗?
这些调用另计,实际成本需结合应用选用的后台与工具。
[内链:OpenAI 语音智能体入门]
[内链:语音 API 成本估算]
参考来源
- OpenAI 开发者公告(2026-11-20)
- GPT-Live-1.1 模型文档(持续维护)
- OpenAI API 定价(持续维护)
- 官方接入指南(持续维护)
转载请注明出处:界智通 · https://www.jieagi.com/aizixun/800.html

关注 AI 前沿动态,分享模型、工具与实战教程。
暂无评论