
微信 WeMM-Video 开放权重,可同时看听
:腾讯微信视觉团队开放 WeMM-Video 权重,四种规格支持中英双语及文字、图片、音频和视频输入。本文解释带原声视频问答的用途、型号选择与本地试用入口,并给出验证声音和画面是否共同被理解的办法。
目录 · 10 节
微信 WeMM-Video 开放权重,可同时看听
微信视觉团队开放 WeMM-Video 模型系列权重,官方仓库的模型许可注明日期为 11 月 20 日。它接受文本、图片、音频和视频,生成文本回答。读视频时可以把画面和原声一起交给模型。这对需要检索有声素材的人很实用,例如找出某段录屏里讲解员一边点击了什么、一边说明了什么。见 腾讯项目页。
四个规格都能处理多模态输入
官方列出 2B、4B、9B 三个稠密模型和 35B-A3B 混合专家版。模型支持中英双语,提供直接回答和多步推理两种模式。不同规格的权重提供 BF16、FP8、AWQ、GGUF 和 NVFP4 等格式,具体是否可跑取决于所用推理框架与硬件。35B-A3B 中的活跃参数概念描述每次计算只用部分专家,仍应为权重以及视频输入占用的缓存做容量预算。见 项目模型列表。
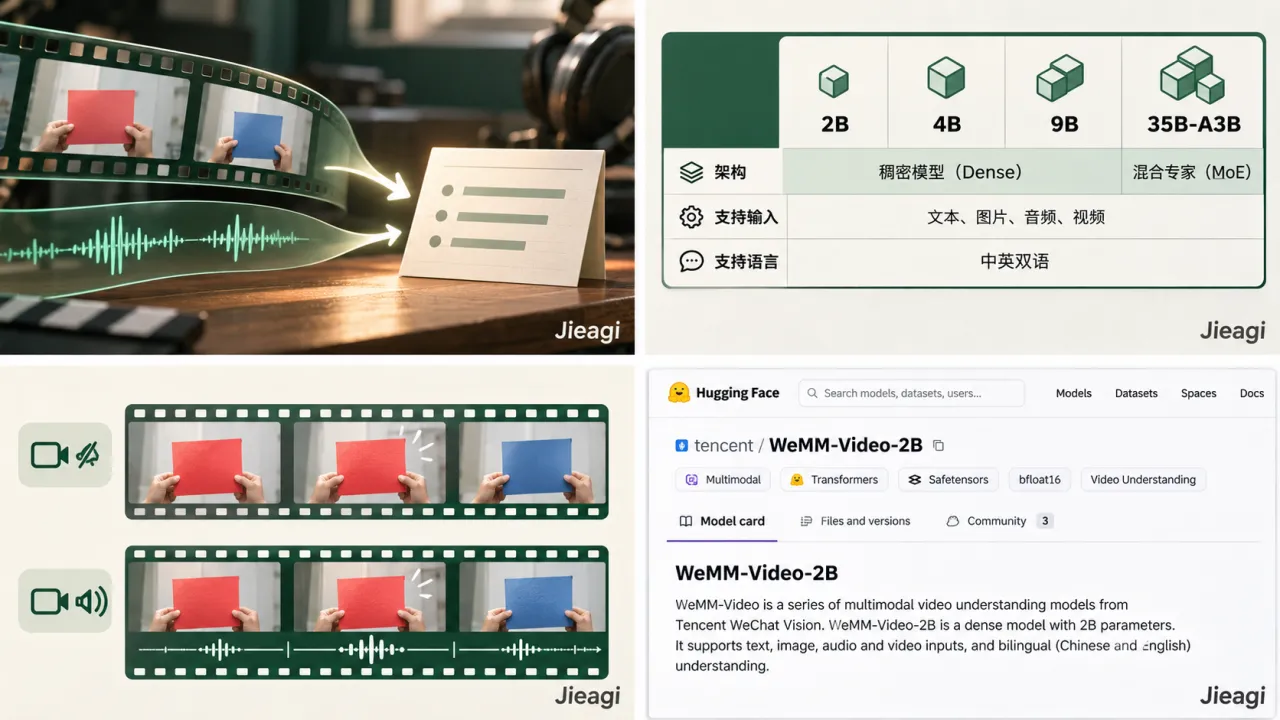
原声怎样改善视频问答
纯画面输入适合问“操作员按下哪个按钮”。若问题是“提示音出现时操作员在做什么”,仅看画面可能漏掉触发条件。纯音频也可能漏掉“屏幕上的项目此时变成了什么颜色”。原声和帧一起输入,使模型可以尝试回答这类跨模态问题。典型应用包括培训视频的知识索引、采访片段搜索和录屏回顾。它输出文字,可作为剪辑前的日志或人工复核线索。
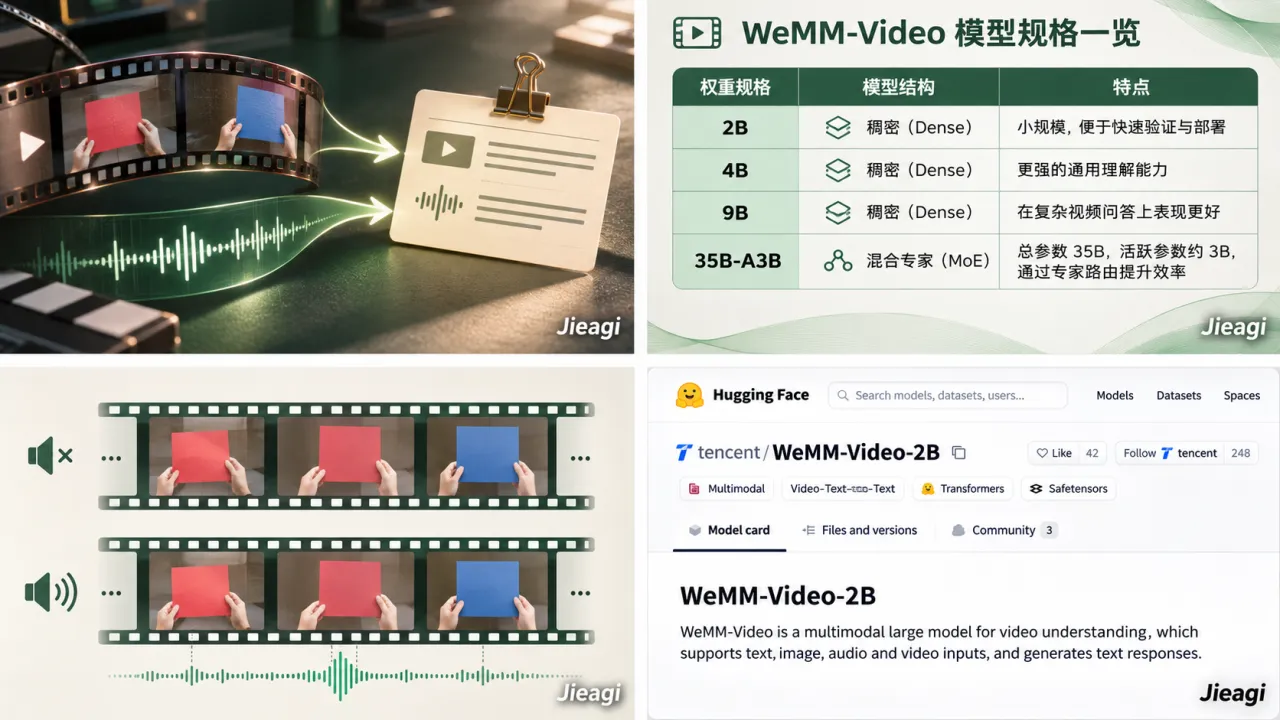
部署前可自己录一段几秒钟的短视频。让手先举起一张红纸,再播放一次提示音,最后换成蓝纸。分别使用纯帧和带原声输入,提问“提示音前后出现了哪两种颜色”。再把任一输入改成两次提示音或调整画面顺序,看看模型会不会忽略变化。这是一道可复查的小测试,比只看一段成功演示更能暴露本地采样参数和提示词的差异。
哪里能下载和试用
可从项目页的模型列表打开各权重。团队的 Transformers 快速入门以 2B BF16 为例,列出 Python 3.12、兼容 CUDA 12.9 的驱动及 FFmpeg 等条件,并给出相同 MP4 分别按画面和声画联合输入的示例。服务化章节另列带补丁的 vLLM、SGLang 及原生 GGUF 运行路线,先对照格式再选。对含自定义代码的权重,按项目建议检查代码并锁定版本。见 2B 权重 和 官方项目文档。
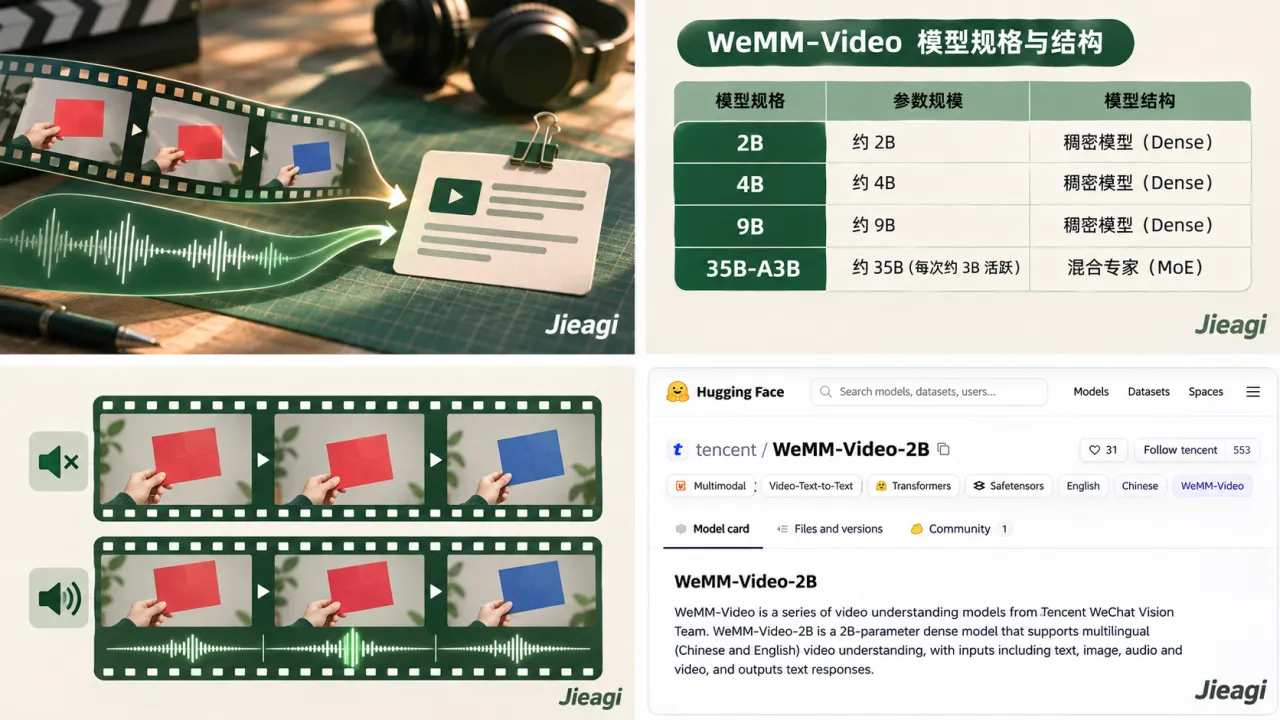
如果应用要把答案显示在时间轴上,可请人工检查该片段是否真的支持答案,再将结果写入剪辑备注。
编辑点评
优先用带明确正确答案的短样本检查模型是否真的利用声音,再扩大到访谈或教程。字幕、内容概括和事件定位也可以分开测,避免一个流畅的总摘要掩盖关键细节错误。团队公开的跑分提供了参考,中文口音、背景音乐和快节奏分镜仍要用自己的素材验证。
常见问题
它能直接生成视频吗?
公开权重用于理解输入并输出文本。
能处理中文视频吗?
官方将其列为中英双语模型。具体口音、混合语言和噪声表现应按素材验证。
装了 vLLM 就能用所有格式吗?
官方文档给出的是带补丁的部署路径,并有版本与格式要求。
[内链:多模态 AI 视频理解入门]
[内链:本地模型权重格式选型]
参考来源
- 腾讯微信视觉官方项目(许可所示 2026-11-20)
- 腾讯 2B 模型卡(持续维护)
- Nvdium 报道(2026-11-20)
转载请注明出处:界智通 · https://www.jieagi.com/aizixun/802.html

关注 AI 前沿动态,分享模型、工具与实战教程。
暂无评论