
AMD XDNA 2 接入 Unsloth 本地推理
AMD 和 Unsloth 为XDNA 2 Ryzen AI 电脑增加本地 NPU 推理路线。本文解释应用如何通过 Unsloth Desktop 调用模型、Windows 上如何找到 NPU 权重,以及共享内存会怎样影响型号选择。
目录 · 10 节
AMD XDNA 2 接入 Unsloth 本地推理
AMD 与 Unsloth 于美国当地 11 月 19 日发布 XDNA 2 NPU 适配消息。支持的 Ryzen AI Windows 电脑可以在 Unsloth Desktop 中加载支持的模型,供桌面聊天或兼容应用使用。这给希望在本机执行长时间推理的用户多了一条硬件路径。装机前最值得核对的条件是 NPU 代际、模型支持情况及可分配的共享内存。见 AMD 新闻稿。
应用通过本地接口访问 NPU 上的模型
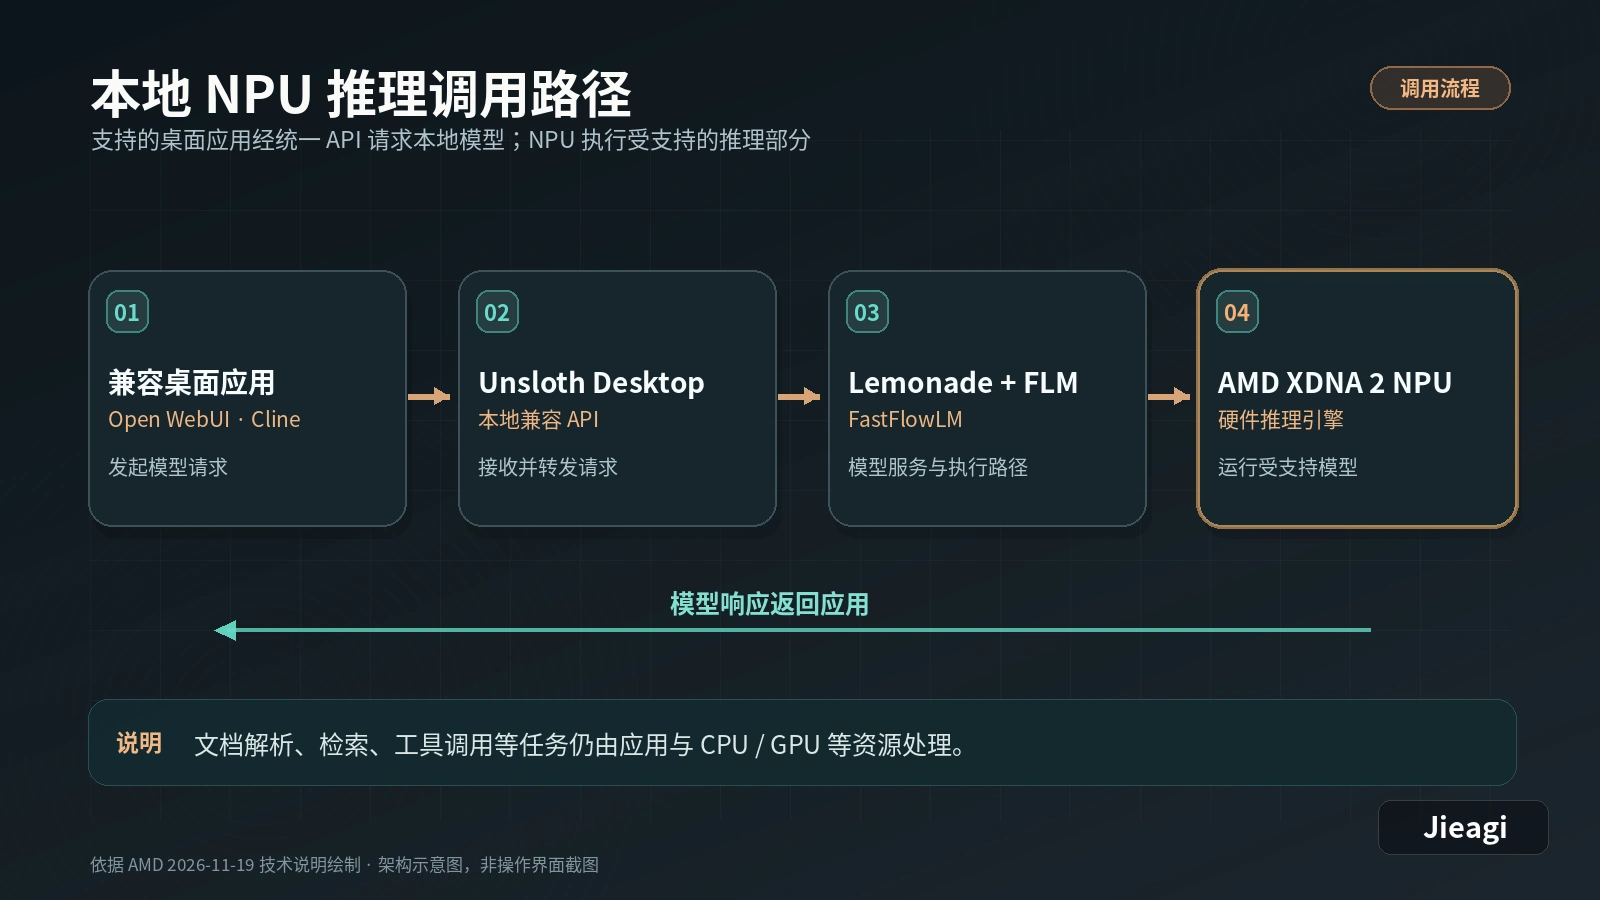
AMD 描述的路径是,兼容应用向 Unsloth Desktop API 发送模型请求,由 Lemonade 和 FastFlowLM 在 XDNA 2 NPU 上执行受支持的模型推理,再把结果返回。厂商宣称有超过 100 个兼容应用和工作流,例子包括 Open WebUI 和 Cline。这个口径是可连接的应用与工作流数量。文档解析、外部检索、图形计算等步骤仍由对应应用和其他部件处理。见 AMD 技术说明。
怎样验证手上的电脑
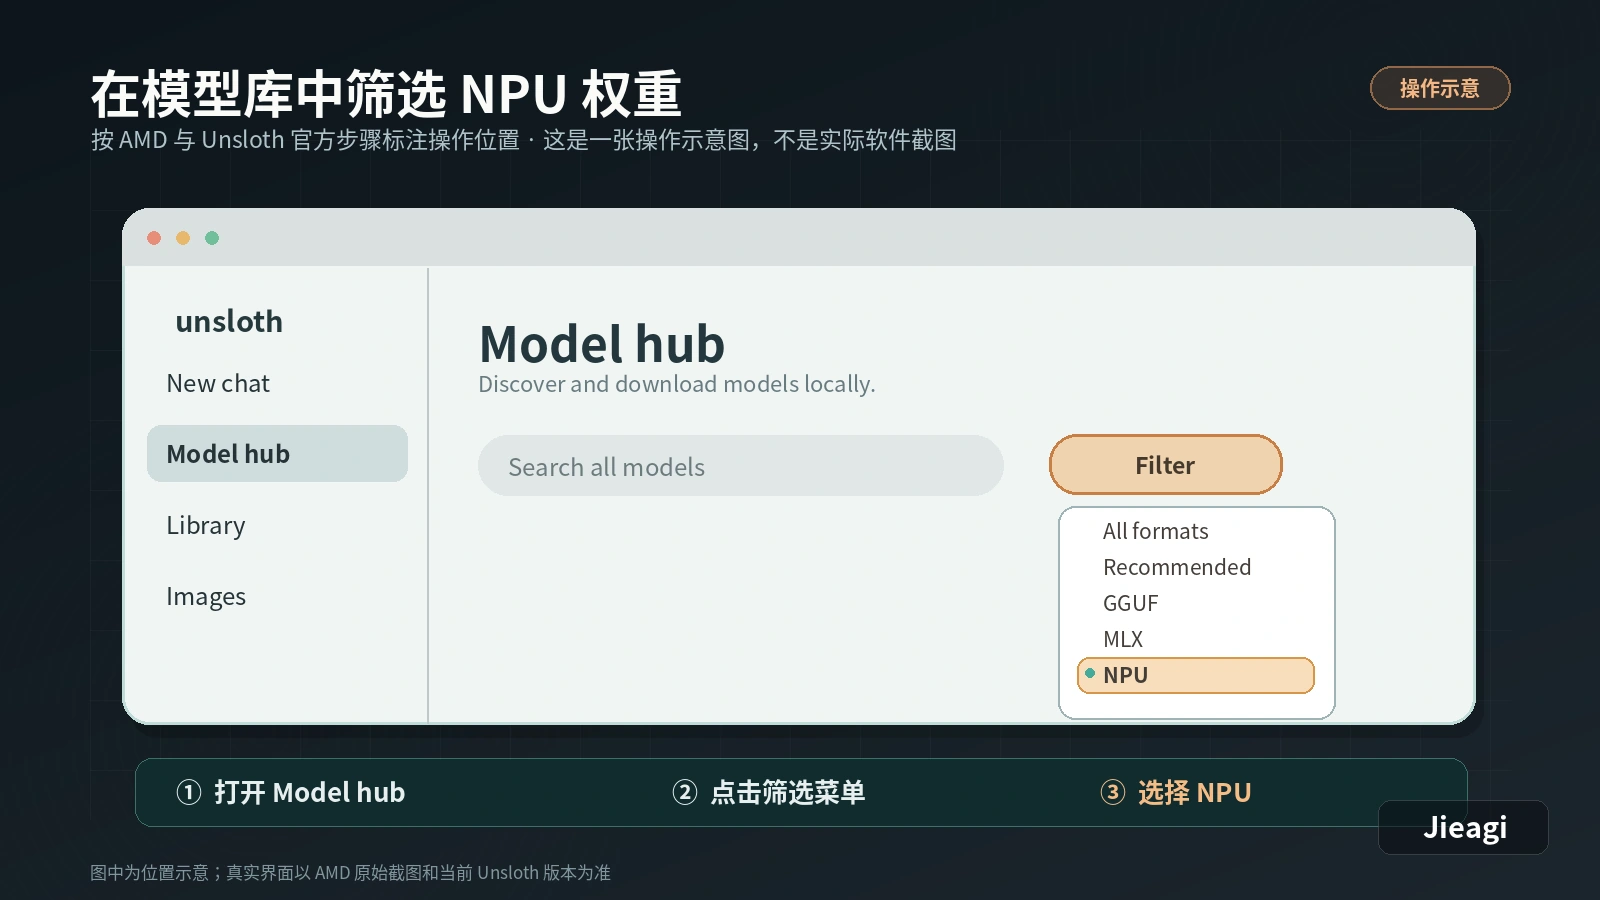
先确认处理器搭载 XDNA 2,并按 Unsloth 设备文档核对驱动及运行条件。安装 Windows 版 Unsloth Desktop 后,在模型库筛选 NPU,再启用 NPU 并下载受支持的模型。切回聊天页面,在 NPU 区域选择已下载模型,从较短上下文发一条简单测试。能正常出字之后,再使用同一份提示词和文档逐步调大上下文,记录响应时间和内存。见 AMD 安装演示 与 Unsloth 设备文档。
共享内存决定什么模型能顺畅运行
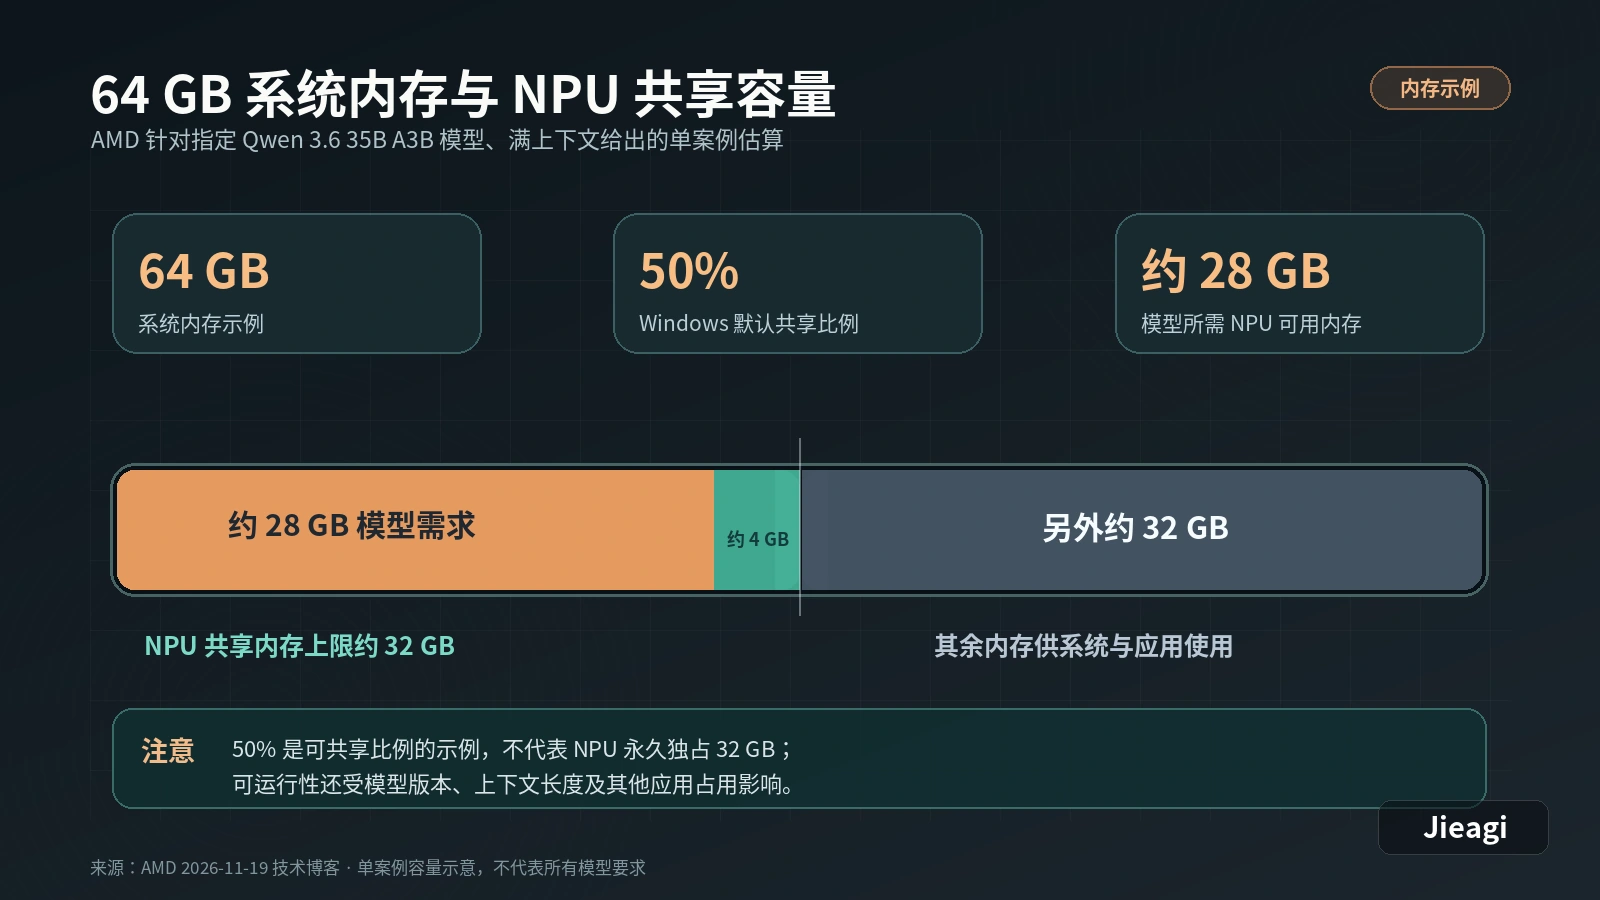
AMD 给了一个容量例子,Qwen 3.6 35B A3B 在其示例条件下跑满上下文,需要约 28 GB 的 NPU 可用内存。按 Windows 默认可共享一半内存估算,示例建议配 64 GB 系统内存。这是特定模型和上下文配置。其他模型有自己的要求。实际应用往往同时开着网页、编辑器和文件工具,也会占内存。用户可以优先测更小的受支持模型,再根据手头任务决定是否提升上下文或模型大小。
小模型能否覆盖日常任务,可以用自己常用的三类输入来判断,例如几行工作备注、一份短文档和一段较长的对话。先固定模型版本和上下文,再分别记录首次响应、完整结束时间和是否出现中途停止。如果测试时大量内存本来已被其他软件占用,可以关闭重型应用复测一次,看看差别是否来自可用内存。还有一个容易忽视的区别是,推理在本机执行,应用连接的外部检索或其他工具仍可能联网。对私有材料有要求的用户,应把模型端点与各工具的网络行为分别核对。
编辑点评
现有兼容机型最容易受益,因为可以拿自己的机器比较 NPU 和其他后端。想把推理放到桌面,与其只看厂商演示,不如先测两个指标。第一,换后端后,响应能否仍在可接受时间内回来。第二,常用应用同时打开时,系统是否还能保持足够的资源。编辑暂无同设备上的续航和性能实测。
常见问题
旧版 AMD NPU 能直接用吗?
本次公告的支持对象是 XDNA 2。不同机型应以 Unsloth 的设备文档为准。
所有模型都必须配 64 GB 吗?
64 GB 出自 AMD 的单个模型、满上下文示例。先查所选权重和实际任务的需求。
同一个应用能把每项工作都交给 NPU 吗?
NPU 路径用于受支持的模型推理。其余步骤由应用按原来的方式执行。
[内链:本地大模型硬件选型]
[内链:Unsloth Desktop 上手指南]
参考来源
- AMD 新闻稿(美国当地 2026-11-19)
- AMD 技术博客和安装演示(美国当地 2026-11-19)
- Unsloth AMD NPU 文档(持续维护)
转载请注明出处:界智通 · https://www.jieagi.com/aizixun/804.html

关注 AI 前沿动态,分享模型、工具与实战教程。
暂无评论