
Together AI上线Qwen3-TTS:97ms延迟支持10种语言
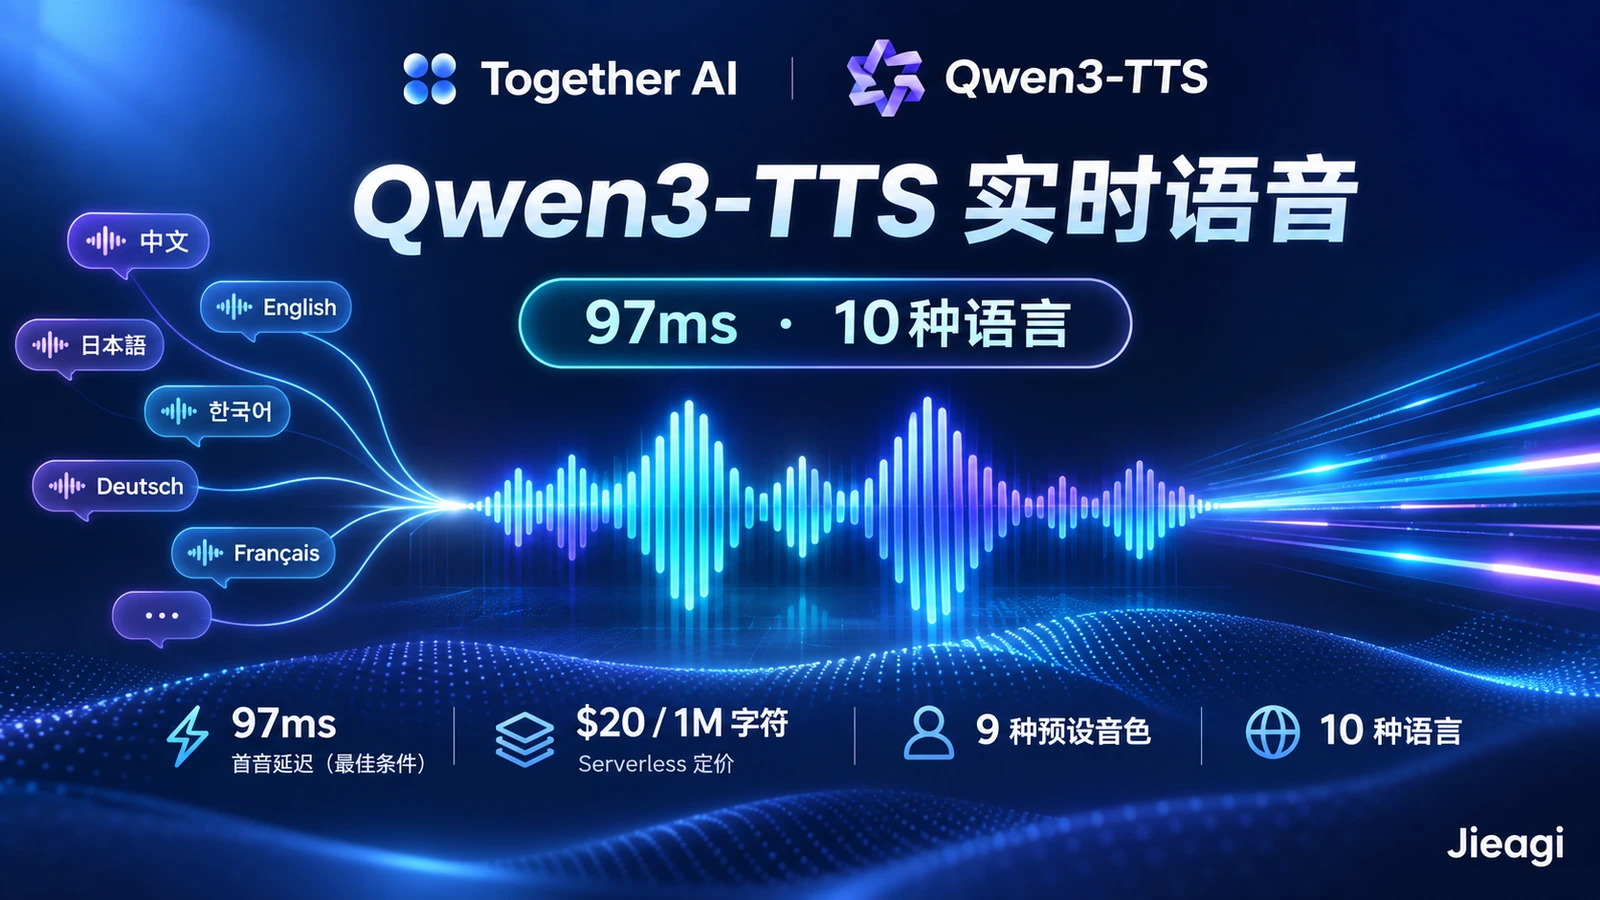
Together AI正式在其无服务器推理平台上线阿里开源语音模型Qwen3-TTS(1.7B),定价每百万字符20美元,支持HTTP流式与WebSocket接口,首音延迟低至97ms并支持自然语言控制情绪。
目录 · 6 节
Together AI 上线阿里 Qwen3-TTS:97ms 首音延迟支持 10 国语言,实时语音 Agent 迎来高性价比方案
2026 年 11 月 21 日,据 Futurum Group 报道,AI 推理云平台 Together AI 正式在其 Serverless Inference(无服务器推理)及专属端点上线阿里云通义千问团队开源的实时语音合成模型 Qwen3-TTS(底层模型为 Qwen/Qwen3-TTS-12Hz-1.7B)。
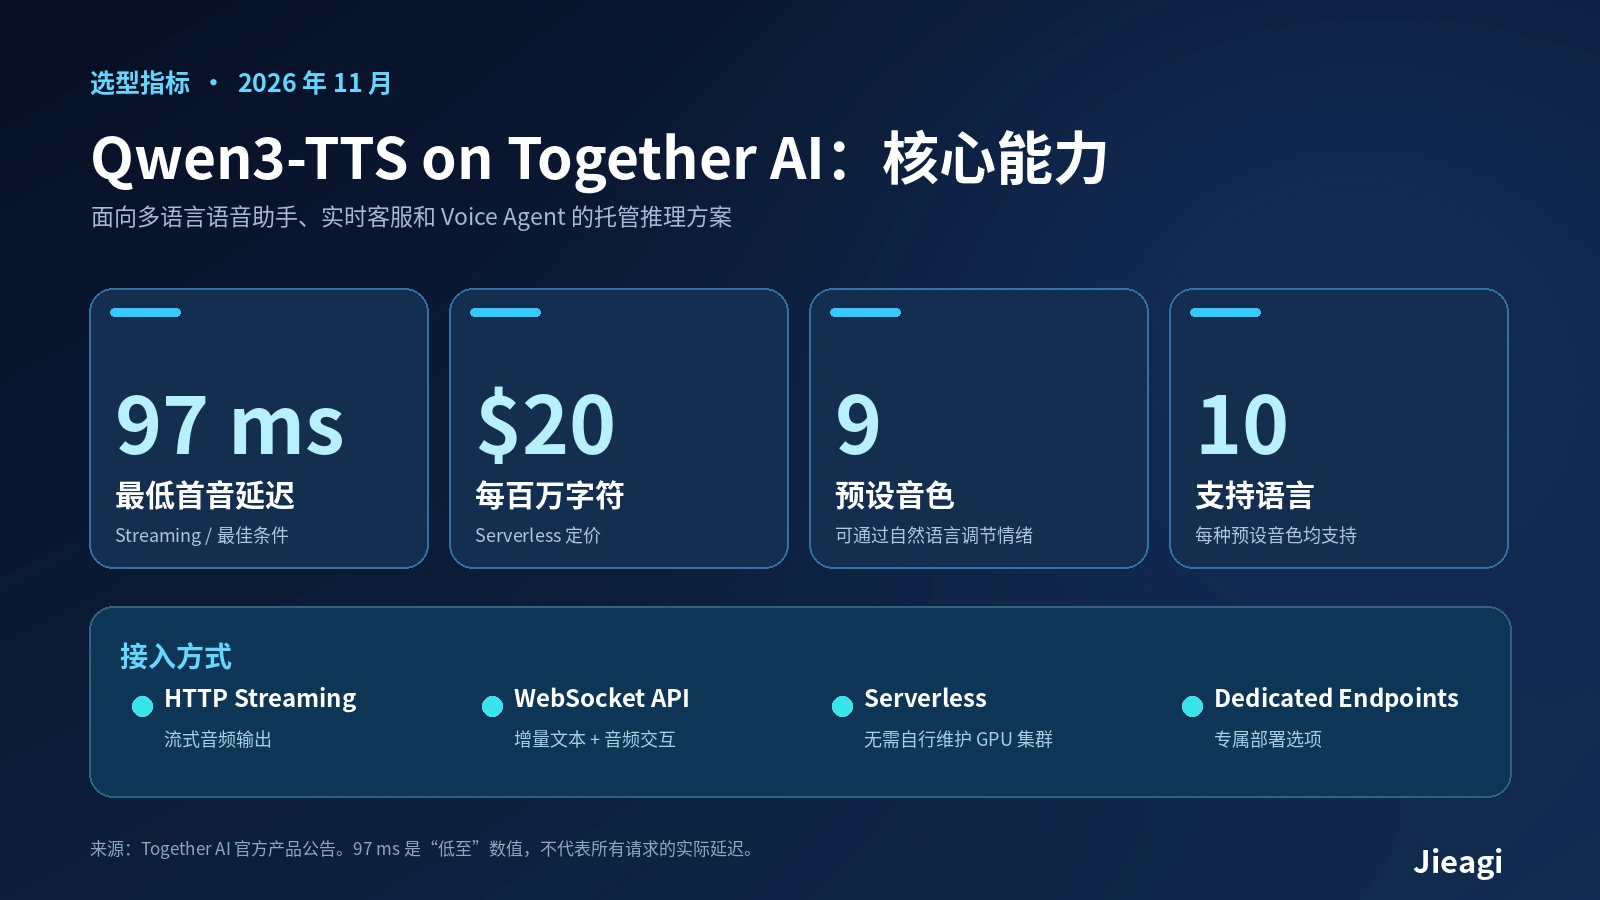
此次上线的最大亮点在于极致的交互延迟与情感控制能力:依托 Together AI 的推理栈优化,Qwen3-TTS 的首音延迟(Time-to-First-Audio)低至 97 毫秒,定价为 20 美元 / 100 万字符(以官方最新公布为准),并同步开放了 HTTP 流式与 WebSocket 双接口。
一、核心特性:音色与情绪解耦,单音色通吃 10 种语言
在企业级语音客服与实时对话 Agent 场景中,传统开源 TTS 往往面临“换一种情绪就变声”或“跨语种需要重新配音”的痛点。Qwen3-TTS 在本次托管版中重点解决了三个工程问题:
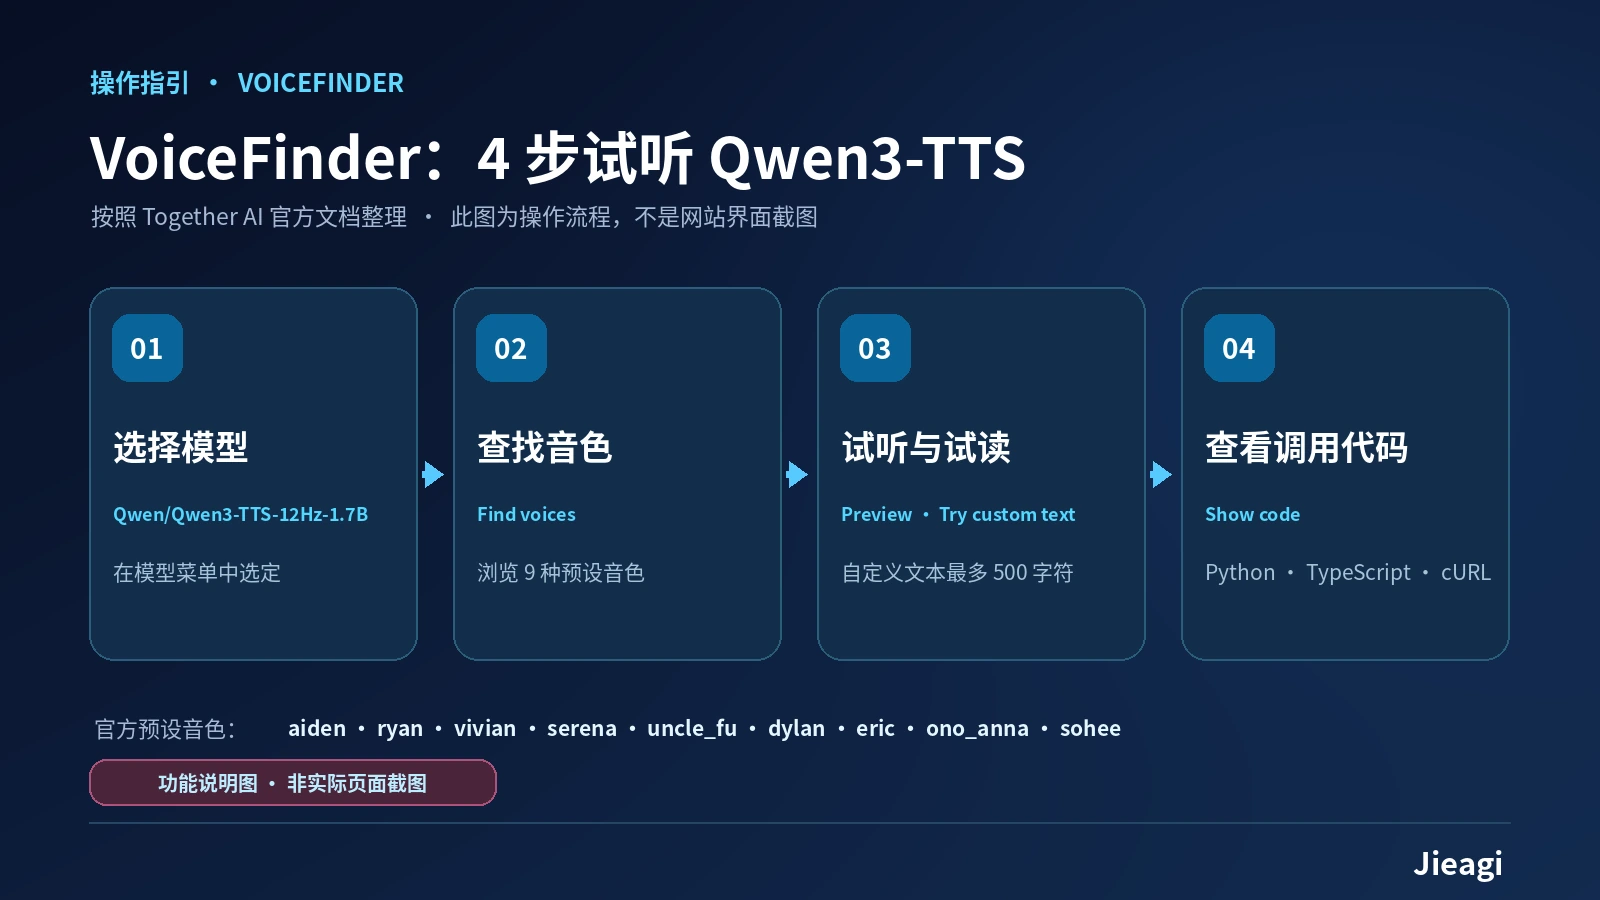
- 说话人身份与表达风格解耦:开发者先选定 9 种预设音色之一,随后只需在请求中用自然语言指令(如
excited and upbeat或sad and disappointed)即可动态调节语调与情感,而不会改变角色原本的声线特征。 - 原生跨语种一致性:9 种预设音色涵盖中文、英文、日文、韩文母语声线,且每一种预设音色均完整支持 10 种语言(包括中、英、日、韩、德、法、俄、葡、西、意语),方便出海应用在不同市场保持统一的品牌声音资产。
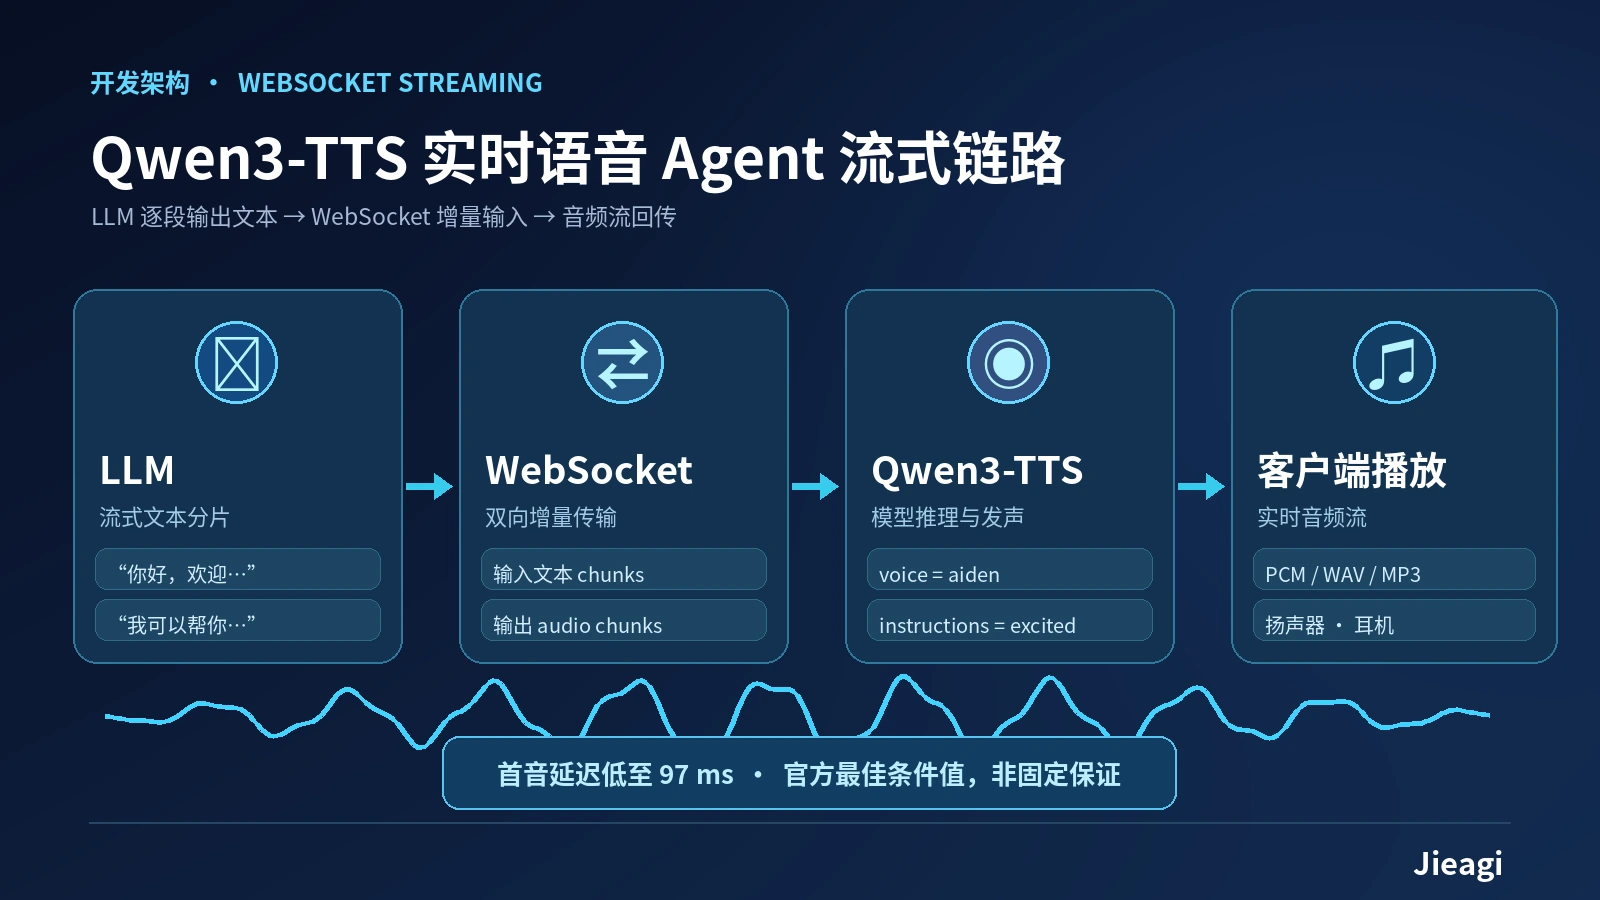
- 97ms 跨入实时对话门槛:配合 WebSocket API 接收大模型逐段吐出的流式文本,Together AI 的优化栈可在 97ms 内返回首帧音频,满足人类自然打断与低延迟语音交互要求。
| 核心参数 | Together AI Qwen3-TTS 托管规格 |
|---|---|
| 底层开源模型 | Qwen/Qwen3-TTS-12Hz-1.7B(阿里云 Qwen 团队) |
| 推理定价 | $20 / 1,000,000 字符(Serverless & 专属端点) |
| 首音延迟 | 低至 97ms |
| 接口协议 | HTTP Streaming(流式) / WebSocket API |
| 语言与音色 | 9 种预设音色,全量支持 10 种主要语言 |
二、对开发者与企业级语音栈的影响
随着语音交互成为客服自动化(Futurum 调研显示占企业生成式 AI 首选场景的 56.5%)的核心载体,开发者正加速摆脱单一闭源语音生态的绑定。Together AI 将语言、代码与低延迟开源语音统一到同一套无服务器推理平台,使团队可以在不自建 GPU 推理集群的前提下,以透明的字符单价搭建可控的多语种语音助手(更多实时语音方案对比见 [内链:2026 主流实时语音与 TTS API 延迟及成本对比])。
此外,OpenAI 也在同期开放了 GPT-Live-1.1 API 并引入 $0.02/分钟的待机计费(参见 [内链:OpenAI GPT-Live-1.1 实时语音 API 定价解析]),“大模型思考 + 低成本流式 TTS”与“端到端原生语音模型”两条技术路线正在同步进入价格战。
三、编辑点评
阿里云 Qwen3-TTS 凭借 1.7B 的轻量体量在开源社区本就口碑不俗,但许多中小团队苦于自建 WebSocket 流式推理和音质调优门槛而难以直接商用。Together AI 此次将其封装为 97ms 首音延迟的 Serverless API 并开放 VoiceFinder 试听,相当于替开发者补齐了工程化最后一公里;对于需要同时服务中日韩及欧美用户的出海应用团队而言,这套“单音色通吃 10 语种”的接口非常值得一试。
常见问题
Q1:Together AI 上的 Qwen3-TTS 怎么收费?
A:当前官方公布的 Serverless 推理定价为每 100 万字符 20 美元($20 / 1M characters),同时支持部署为专属端点,具体计费细则以 Together AI 官方最新公布为准。
Q2:Qwen3-TTS 支持中文吗?有哪些语言?
A:支持。其 9 种预设音色包含中文、英文、日文、韩文母语声线,且每个预设音色均可合成中、英、日、韩、德、法、俄、葡、西、意共 10 种语言。
Q3:如何控制合成语音的情绪和语气?
A:该模型将音色与风格解耦,开发者只需在调用参数中传入自然语言描述(例如“excited and upbeat”或“sad and disappointed”),即可改变说话语气而不会串音。
参考来源
转载请注明出处:界智通 · https://www.jieagi.com/aizixun/822.html

关注 AI 前沿动态,分享模型、工具与实战教程。
暂无评论