
GPT-6 模型选型教程:Astra、GPT-6.1 Sol、Luna API 价格对比与 Python 实战
Meta Description: OpenAI 于 2026 年 10 月 2 日发布 GPT-6 系列开发指南,介绍 Astra、GPT-6.1 Sol 和 Luna 的模型定位、推理强度、提示词优化、上下文缓存和多步骤 Agent 工作流。本文提供价格对比、Python Responses API 示例及生产环境成本优化方案。
目录 · 22 节
- 一、GPT-6 不再是一款模型,而是一套开发者模型组合
- 二、GPT-6 Astra、Sol、Luna 到底有什么区别?
- 三、三款模型 API 价格对比
- 四、怎样选择合适的推理强度?
- Low:轻量任务
- Medium:常规分析
- High:复杂推理
- Extra High / Max:高难度任务
- 五、使用 Python 调用 GPT-6.1 Sol
- 六、如何设计 GPT-6 多模型路由?
- 七、上下文缓存为什么能够明显影响费用?
- 八、长期 Agent 任务怎样管理上下文?
- 九、如何优化 Codex 的项目指令?
- 十、AI API 成本应该怎样评估?
- 十一、开发者常见问题
- GPT-6 Astra 一定优于其他模型吗?
- GPT-6.1 Sol 是否更适合 Codex?
- Luna 是否只能用于简单聊天?
- 更高推理强度是否必然更准确?
- OpenAI API Key 和 ChatGPT 会员可以共用费用吗?
- 十二、总结
- 官方参考资料
一、GPT-6 不再是一款模型,而是一套开发者模型组合
随着 AI 开始承担软件开发、数据分析、知识检索和多步骤任务执行,开发者面临的核心问题已经发生变化。
过去我们更关心:哪个模型最聪明?
现在需要进一步思考:哪个模型能够以合理的成本完成指定任务?
2026 年 10 月 2 日,OpenAI 发布《GPT-6 系列模型指南》,介绍如何为不同工作负载选择模型、配置推理强度、优化提示词,并将长期运行的 AI Agent 部署到生产环境。
这份指南重点介绍三个模型:
- GPT-6 Astra:面向高难度推理和复杂专业任务。
- GPT-6.1 Sol:兼顾较强智能水平与成本,适合编程和 Agent。
- GPT-6 Luna:强调速度与成本效率,适合高频重复任务。
值得注意的是,这是一份模型开发指南,并不是三款模型在 10 月 2 日同时首次发布的新闻。
它反映了 OpenAI 当前的模型使用思路:不必为所有任务使用价格最高的旗舰模型,而是根据任务难度和质量要求灵活选择。
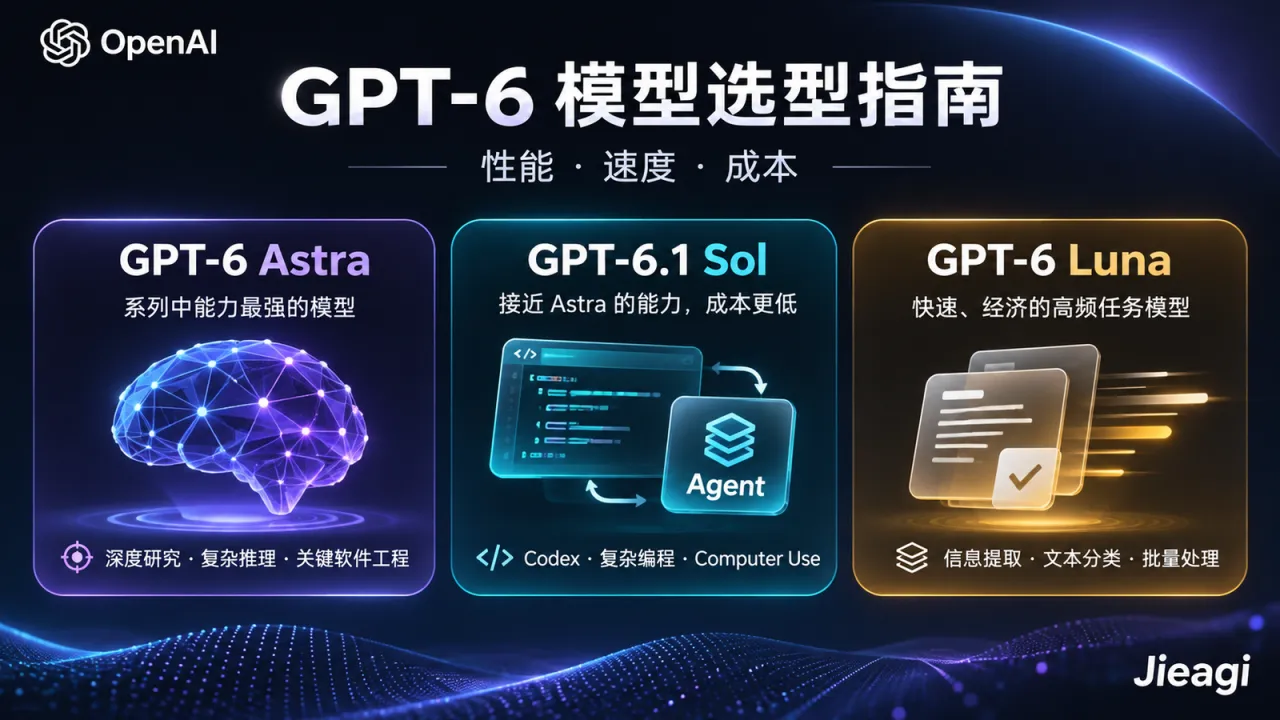
二、GPT-6 Astra、Sol、Luna 到底有什么区别?
按照 OpenAI 10 月 2 日指南的定位,三款模型覆盖不同类型的工作。
| 模型 | 官方定位 | 适合场景 |
|---|---|---|
| GPT-6 Astra | 系列中能力最强的模型 | 深度研究、复杂推理、关键软件工程 |
| GPT-6.1 Sol | 接近 Astra 的能力,成本更低 | Codex、复杂编程、Computer Use |
| GPT-6 Luna | 快速、经济的高频任务模型 | 信息提取、文本分类、批量处理 |
例如,一家企业正在开发 AI API 服务。
它可能每天处理数十万次请求,其中绝大多数只是简单文本分类。
如果全部使用 Astra,费用可能明显高于必要水平。
而对于涉及复杂代码分析、重大技术决策或多阶段研究的任务,使用更强模型可能降低失败和返工成本。
因此,模型选择不应该只比较每百万 Token 的价格,也应该比较完成同一个任务的成功率。
三、三款模型 API 价格对比
OpenAI 在 2026 年 10 月 2 日的指南中列出了以下参考价格。
| 模型 | 输入 / 百万 Token | 缓存输入 / 百万 Token | 输出 / 百万 Token |
|---|---|---|---|
| GPT-6 Astra | $10.00 | $1.00 | $50.00 |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 |
从这组基础费率可以看出:
GPT-6.1 Sol 的普通输入与输出 Token 单价约为 Astra 的五分之一。
Luna 则更适合对成本特别敏感、任务边界明确的场景。
但这里有一个很重要的提醒:
表格展示的是官方指南中的基础参考价格,不代表所有处理模式、长上下文请求或工具调用都会按照同一费率收费。
实际费用可能受到上下文长度、缓存写入、服务层级、工具使用和其他计费规则影响。
因此,开发者上线前仍然需要查看最新价格页。
四、怎样选择合适的推理强度?
OpenAI 指南将推理强度分成不同等级。
Low:轻量任务
适合简单文本提取、格式转换和少量代码修改。
例如,从一份结构清晰的订单中提取商品名称和数量。
Medium:常规分析
适合需要判断和规划的任务。
例如,对两个缓存方案进行技术对比,给出推荐理由。
High:复杂推理
适合困难的代码调试、多模块架构分析和深入审查。
Extra High / Max:高难度任务
在模型支持的情况下,可以进一步提高推理投入。
但增加推理资源并不必然提升每个任务的实际效果。
建议先测试 High,如果确实无法达到目标,再逐步提高。
对于高频生产系统,最有效的方式往往是建立一组固定测试任务,测量不同推理强度下的质量、延迟和费用。
五、使用 Python 调用 GPT-6.1 Sol
下面使用 OpenAI 官方 Python SDK 和 Responses API,构建一个简单的代码分析请求。
首先安装 SDK:
pip install -U openai配置环境变量:
Windows PowerShell:
$env:OPENAI_API_KEY="你的API密钥"Linux 或 macOS:
export OPENAI_API_KEY="你的API密钥"创建 test_gpt6.py:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={
        "effort": "medium"
    },
    input=(
        "请分析 Python FastAPI 服务在高并发下"
        "可能出现的数据库连接池耗尽问题。"
        "按影响程度给出排查顺序,"
        "并说明每一步应该检查哪些指标。"
    ),
)

print(response.output_text)

if response.usage:
    print(response.usage)
然后执行:
python test_gpt6.py该示例使用的正式模型 ID 是 gpt-6.1-sol。
如果希望对比不同推理强度,可以分别尝试 low、medium 和 high,记录任务质量及 Token 使用情况。
示例代码按照官方接口结构编写,正式使用仍需要真实 API Key 和有效额度。
六、如何设计 GPT-6 多模型路由?
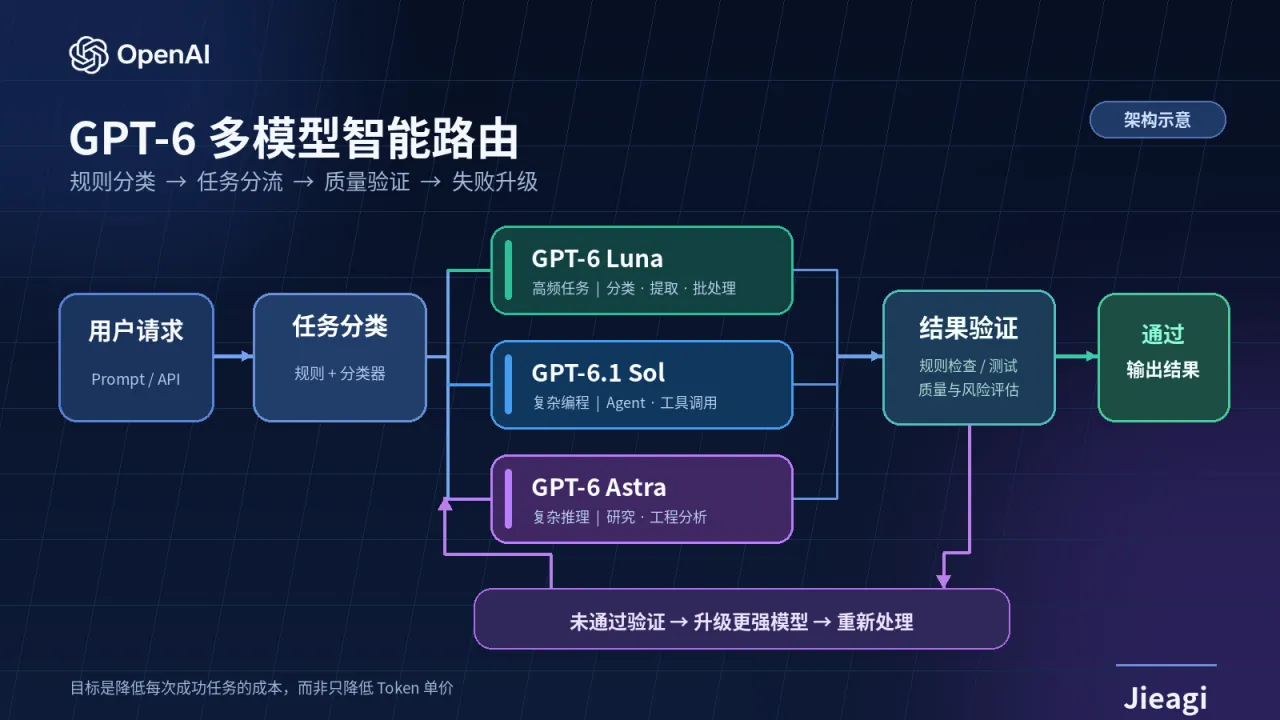
对于需要大量请求的 API 平台,可以考虑按照任务复杂程度路由模型。
例如:
用户请求 → 任务分类 → 选择模型 → 模型处理 → 结果验证。
一种初步策略是:
| 任务 | 初始模型 |
|---|---|
| 简单内容分类 | Luna |
| 常规文本处理 | Luna |
| 中等复杂度编程 | Sol |
| 多模块程序分析 | Sol |
| 高难度推理 | Astra |
| 高风险业务决策 | Astra 辅助分析+人工审批 |
需要注意,不能将任务模型路由仅仅交给一个不受限制的模型自由决定。
生产环境可以结合规则、分类器和任务评估结果来控制路由。
更进一步,还可以采用升级策略:
先使用较低成本模型处理任务。
如果结果未通过验证,再调用更强模型重新分析。
这样有机会减少部分请求的总体成本。
但对高风险场景,不能为了节省费用降低必要的审查强度。
七、上下文缓存为什么能够明显影响费用?
在 AI Agent 中,开发者通常会反复发送一些相同内容。
例如:
系统指令、工具定义、项目规则、技术文档和代码仓库摘要。
如果这些内容每次都被重新计算,就会带来重复成本。
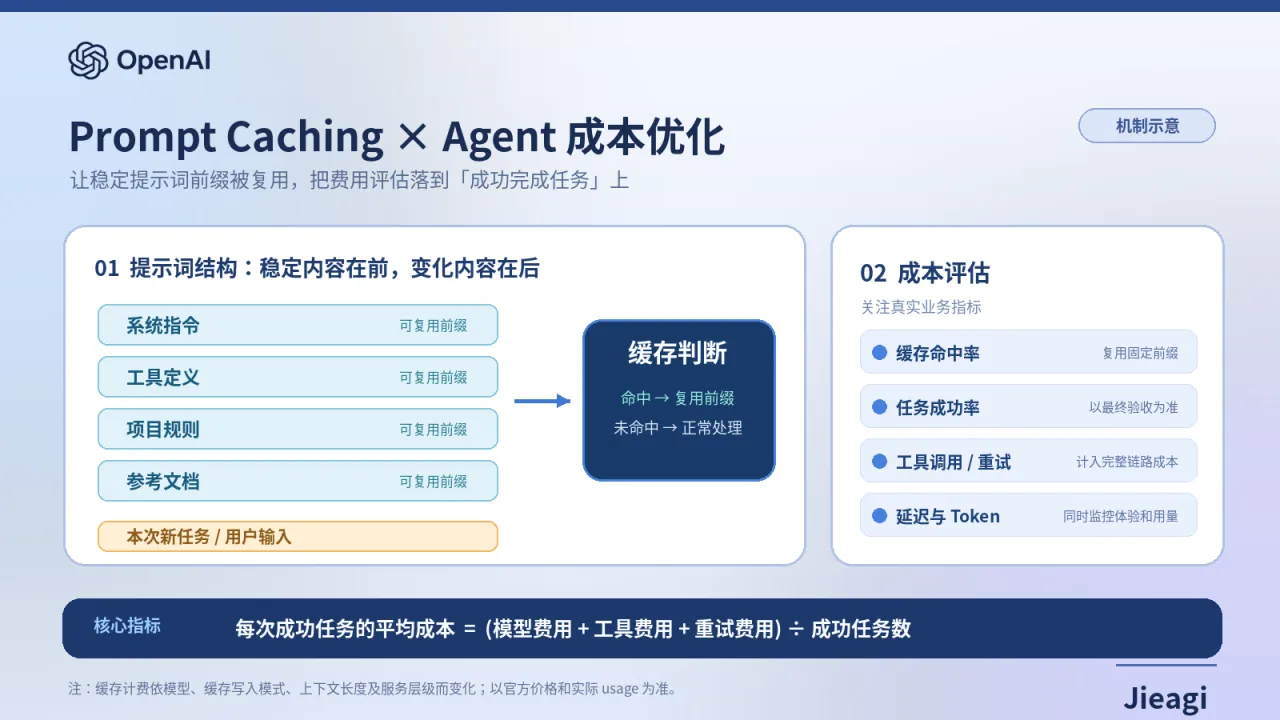
OpenAI 在指南中建议合理利用 Prompt Caching。
其核心做法是:
尽量保持稳定的输入前缀,将经常变化的用户任务放在后面。
例如:
固定的系统说明
固定的工具列表
固定的项目开发规则
固定的参考文档

本次需要处理的新任务
这样更有利于缓存机制识别重复部分。
但缓存是否实际命中,需要通过响应中的使用统计与平台监控确认。
另外,不能只比较缓存命中价格,还需要考虑适用的缓存写入费用与长上下文费率。
八、长期 Agent 任务怎样管理上下文?
对于持续多个小时的工作流,原始消息和工具输出可能不断增加。
例如:
某个 Coding Agent 运行了大量测试,并反复修改代码。
如果系统把所有构建日志完整保留在上下文中,费用和响应时间可能逐渐增长。
OpenAI 建议使用上下文压缩(Compaction),保留对后续任务真正重要的信息。
例如:
已经确认的需求、当前修改范围、失败原因、下一步任务以及不能违反的约束。
而大量重复构建日志,可以保留摘要和对应文件位置。
需要强调,压缩不应该破坏任务所需的关键事实。
对于代码开发,还应将 Git 提交、测试结果和实际文件状态作为可验证的外部记录,不能只依赖模型对历史过程的文字记忆。
九、如何优化 Codex 的项目指令?
OpenAI 特别强调明确任务边界。
例如,可以在项目规则中说明:
项目目标:
维护一个 Python API 服务。

允许执行:
- 读取项目源代码
- 修改测试目录
- 运行本地单元测试
- 生成修复报告

需要审批:
- 修改数据库结构
- 安装新的生产依赖
- 部署服务器
- 删除业务数据

完成标准:
- 修复目标问题
- 相关测试通过
- 输出修改文件清单
- 说明剩余风险
相比反复告诉 Agent“务必认真思考”,这种指令能够更清楚地说明什么是成功、哪些操作被授权。
对于长任务,还应明确什么情况需要暂停并征求用户意见。
例如涉及生产数据、支付操作或项目范围变化时。
十、AI API 成本应该怎样评估?
只比较单次调用价格,容易低估 Agent 的真实成本。
例如某个模型价格较低,但经常需要重复执行任务。
另一个模型虽然单价较高,却能一次完成工作。
这两种情况下,最终成本可能与表面价格不同。
建议记录:
- 请求模型;
- 输入 Token;
- 缓存输入 Token;
- 输出 Token;
- 工具调用费用;
- 请求延迟;
- 任务成功情况;
- 失败重试次数。
最终重点计算:
每次成功完成任务的平均成本。
这样才能判断更换模型是否真正划算。
十一、开发者常见问题
GPT-6 Astra 一定优于其他模型吗?
它是 OpenAI 在该系列中定位最高的模型,但实际任务效果仍然需要通过评测判断。
GPT-6.1 Sol 是否更适合 Codex?
OpenAI 将其作为复杂编程和 Agent 工作流的重要模型选择之一。
Luna 是否只能用于简单聊天?
不是。它也适合结构化信息提取、分类和大量重复任务。
更高推理强度是否必然更准确?
不一定,应根据任务测试结果选择。
OpenAI API Key 和 ChatGPT 会员可以共用费用吗?
API 计费与 ChatGPT 订阅属于不同产品体系,应分别查看使用规则。
十二、总结
OpenAI 的 GPT-6 模型指南强调了一个重要变化:
先进 AI 应用的竞争,正在从单一模型能力转向模型选型、任务编排与工程效率。
对于开发者来说,Astra、Sol 和 Luna 并不是简单的高、中、低档位,而是适用于不同工作负载的工具。
如果希望构建真正可持续运行的 AI 产品,就需要把模型能力、推理强度、缓存、长任务管理和费用评估结合起来。
最终目标不是消耗更少的 Token,而是以合理成本获得稳定、可验证的业务结果。
官方参考资料
OpenAI:《GPT-6 系列模型指南》 https://openai.com/zh-Hans-CN/index/practical-guide-building-gpt-6/
OpenAI API 模型目录 https://developers.openai.com/api/docs/models
OpenAI API 使用指南 https://developers.openai.com/api/docs/guides/latest-model
关注 AI 前沿动态,分享模型、工具与实战教程。
暂无评论