
Python AI 日志分析实战:脱敏统计 Nginx 错误并生成排障建议
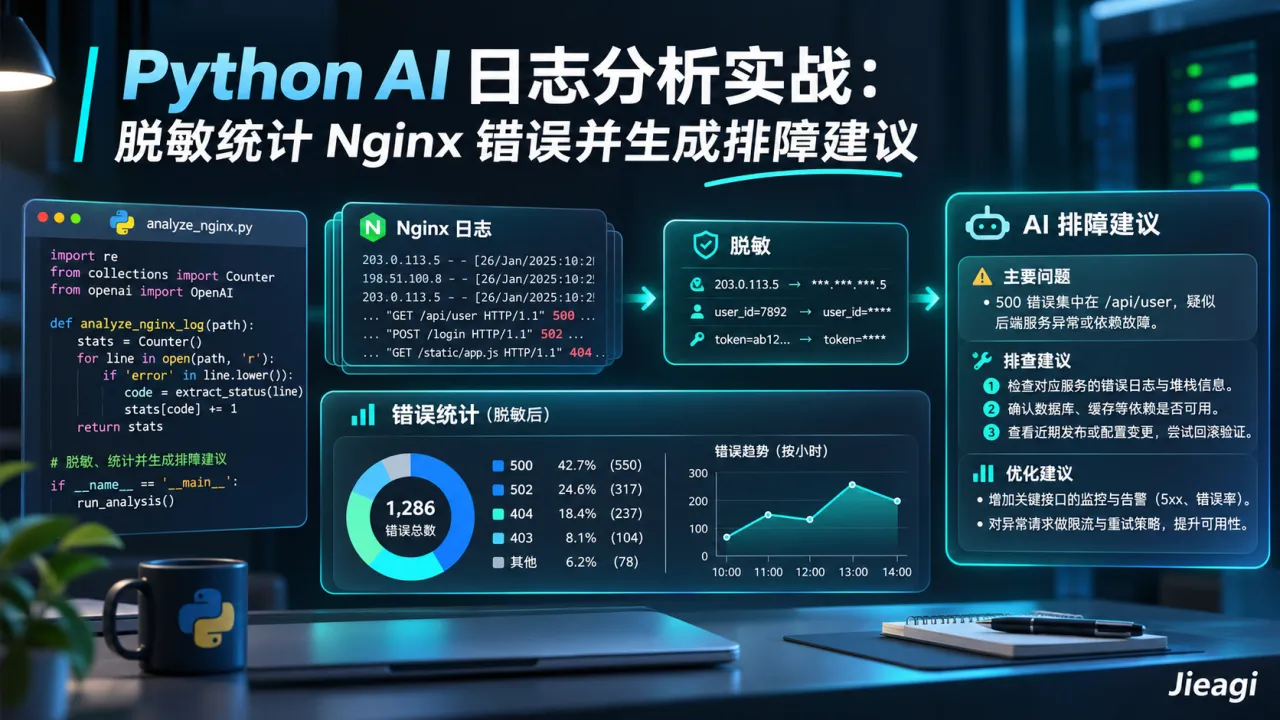
使用 Python 读取 Nginx 或应用文本日志,在本地完成错误等级计数与敏感信息脱敏,再通过 uiuiAPI 的 Chat Completions 接口生成可供运维人员核验的排障建议。教程包含完整代码、离线演练、超时重试、异常处理与费用控制,适合中小团队构建轻量级日志诊断工具。
为什么不直接把整份日志发给 AI?
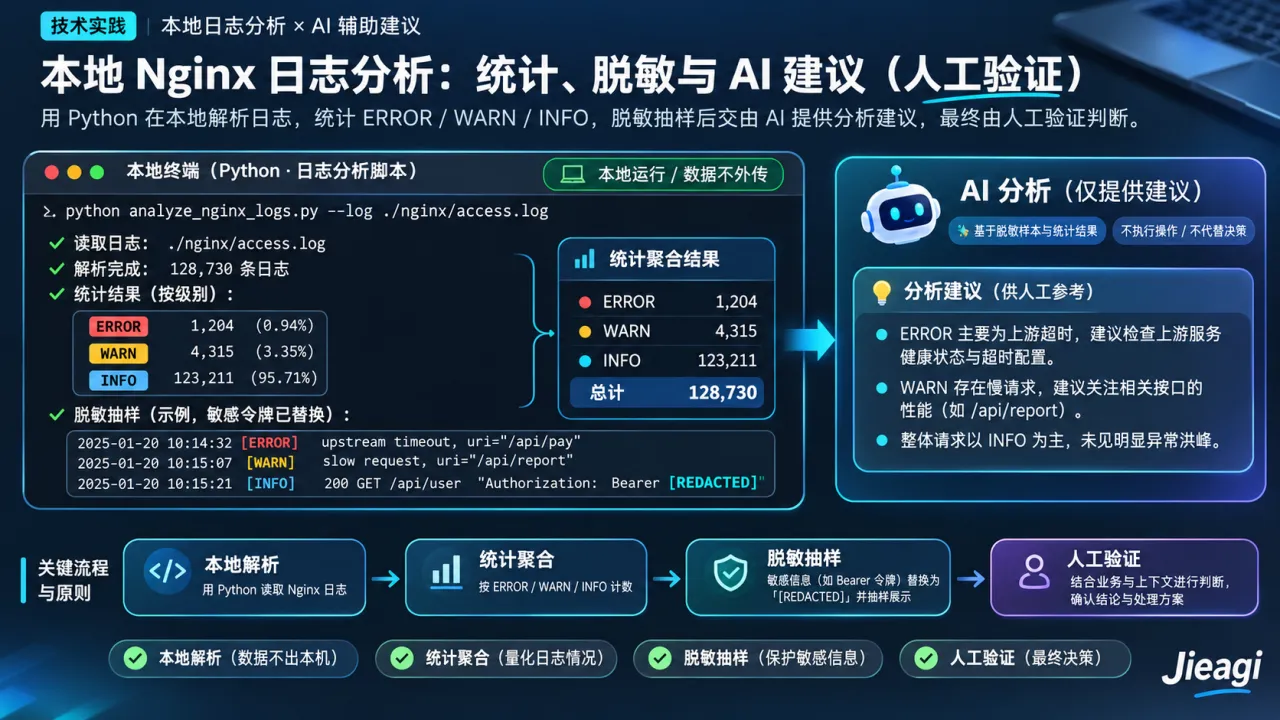
生产日志可能包含 IP、Token、用户标识和内部路径。将几十 MB 原始日志直接发送给模型,既昂贵又可能造成数据泄露。更可控的路线是:本地解析 → 统计聚合 → 脱敏抽样 → API 辅助分析 → 人工验证。这篇案例面向运维人员、独立开发者和维护 API 网关的团队,重点是把模型放在“建议层”,而不是让它直接执行危险操作。
目标效果与数据流
脚本逐行读取日志,将包含 ERROR、WARN、INFO 的行分组计数,每组最多取三条样本,并对常见令牌形式做基础遮盖。随后把统计摘要发给文本模型,让模型提出可能原因与验证顺序。脚本提供 --dry-run,即使没有 API Key,也能先检查脱敏效果。这不是完整 DLP 系统:自定义密钥、个人信息和堆栈上下文仍可能漏检,生产环境需要更严格的脱敏规则。
安装与目录
项目只有 analyze.py 和 sample.log。安装依赖:python -m pip install requests。Windows PowerShell 设置:$env:UIUI_API_KEY="你的令牌"; $env:MODEL="账户可用模型ID";macOS/Linux 使用 export UIUI_API_KEY='你的令牌' 与 export MODEL='账户可用模型ID'。密钥仅在本机终端设置,不写入源码或 Git。
sample.log 可写入如下虚构内容:
2026-11-21 INFO server started
2026-11-21 WARN upstream slow 1200ms
2026-11-21 ERROR upstream timeout Bearer sk-exampletoken
2026-11-21 ERROR database connection refused
将下面的代码保存为 analyze.py:
import argparse
import collections
import json
import os
import re
import time
from pathlib import Path
import requests

URL = "https://api.uiuihao.com/v1/chat/completions"
PATTERN = re.compile(r"(sk-[A-Za-z0-9_-]+|Bearer\s+\S+|password[=:]\S+)", re.I)

def scrub(s):
    return PATTERN.sub("[REDACTED]", s)[:500]

def request_ai(summary, key, model):
    prompt = ("你是生产日志分析助手。只能根据提供的统计事实给出排查建议;"
              "不得宣称已经定位根因。输出中文,包含:优先级、可能原因、"
              "验证步骤、回滚建议。不要猜测未出现的服务名。\n" + summary)
    payload = {"model": model, "messages": [
        {"role": "system", "content": "只分析脱敏统计,不输出敏感信息。"},
        {"role": "user", "content": prompt}]}
    for attempt in range(3):
        try:
            r = requests.post(URL, json=payload,
                headers={"Authorization": f"Bearer {key}"}, timeout=(10, 50))
            if r.status_code == 429 or r.status_code >= 500:
                if attempt < 2:
                    time.sleep(2 ** attempt)
                    continue
            r.raise_for_status()
            data = r.json()
            return data["choices"][0]["message"]["content"]
        except (requests.RequestException, ValueError, KeyError, IndexError, TypeError) as e:
            if attempt == 2:
                raise RuntimeError(f"请求失败:{type(e).__name__}") from e
            time.sleep(2 ** attempt)
    raise RuntimeError("未获得响应")

def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("logfile", type=Path)
    ap.add_argument("--dry-run", action="store_true")
    args = ap.parse_args()
    counts = collections.Counter()
    examples = collections.defaultdict(list)
    with args.logfile.open(encoding="utf-8", errors="replace") as f:
        for line in f:
            if len(line) > 20000:
                continue
            level = next((x for x in ("ERROR", "WARN", "INFO") if x in line.upper()), "OTHER")
            counts[level] += 1
            if len(examples[level]) < 3:
                examples[level].append(scrub(line.strip()))
    summary = json.dumps({"counts": counts, "samples": examples}, ensure_ascii=False)
    print("本地统计:", summary)
    if args.dry_run:
        return
    key, model = os.getenv("UIUI_API_KEY"), os.getenv("MODEL")
    if not key or not model:
        raise SystemExit("请设置 UIUI_API_KEY 与 MODEL")
    print("\nAI 排查建议(待人工验证):\n", request_ai(summary, key, model))

if __name__ == "__main__":
    main()
运行与输出示意
先执行 python analyze.py sample.log --dry-run,核对本地统计结果及脱敏样本;确认没有敏感信息后,再执行 python analyze.py sample.log。PowerShell 和 Bash 的运行命令相同,区别只在环境变量设置。预期本地统计含 ERROR: 2、WARN: 1、INFO: 1,Bearer 令牌样本被遮盖。AI 部分可能建议先检查上游响应时间、数据库连通性及错误发生时间,但不是实际运行结果,也不能当作根因结论。
关键实现解释
这里用流式文件迭代避免一次性把日志读入内存;使用 Counter 计数,不依赖额外数据平台。scrub() 只是一层示范性保护:它限制发送样本长度并遮盖几类明显凭据。真实日志可能包含手机号、邮箱、JWT、会话 Cookie 或其他机密,必须按企业数据分类规则进一步过滤。对于高敏日志,建议完全不发送样本,只发送聚合指标。
接口采用普通 JSON POST;重试仅针对请求异常、429 与部分服务端错误,最多三次。对模型的系统指令明确要求“只提供验证建议”,避免把相关性误当因果。模型的答案不应触发自动重启、删库、修改防火墙等操作。
生产化扩展
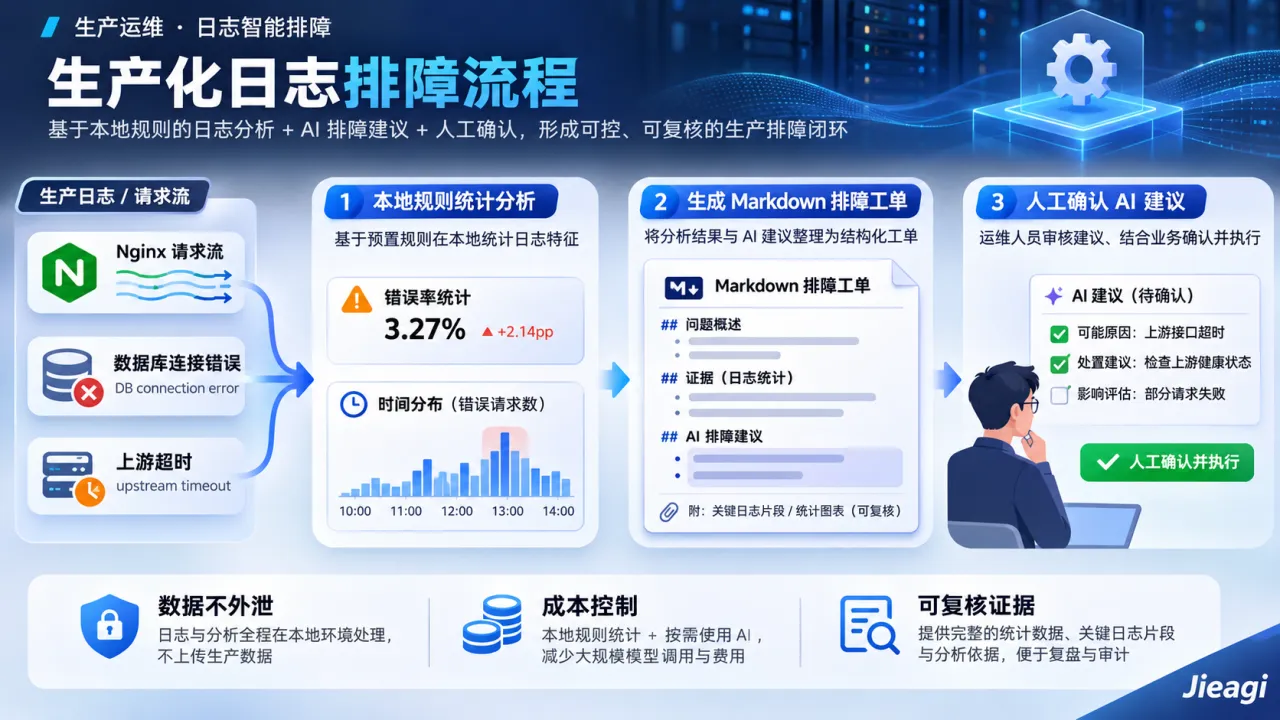
下一步可增加按分钟统计错误率、按 request ID 聚合、解析 Nginx JSON 日志、导出 Markdown 排障工单和告警阈值。若要做自动告警,建议由确定性的本地规则判断是否触发,再由模型生成解释文本。还应将脱敏测试纳入 CI,使用合成密钥检查是否会泄露,并记录每次请求的摘要哈希、耗时和人工确认状态。
总结
这套方法把敏感数据处理留在本地,把 AI 用于总结和辅助排障,适合先做一个可控的小工具,再逐步连接监控系统。真正的可靠性来自本地规则、可复核证据和人工确认,而不是模型的自信措辞。
准备工作与接口说明
准备 Python 3.10+(Node.js 案例使用 Node.js 20+)、可以访问网络的终端,以及从 uiuiAPI 主站控制台申请的 API Key。uiuiAPI 是第三方模型聚合服务,并非模型厂商官方接口;支持哪些模型、请求参数、计费倍率及限额,应以主站模型广场、账户权限和实际渠道为准。本文使用 OpenAI 兼容的 Chat Completions 请求形态,不能据此推断所有模型均支持所有能力。
所有示例统一调用 https://api.uiuihao.com/v1/chat/completions,不在客户端代码里写死密钥。模型通过 MODEL 环境变量选择:请填入自己账户可用、支持文本聊天的实际模型 ID。示例输出仅展示可能的预期格式,并非真实模型回包;本轮没有发送付费请求。
常见故障、安全与成本
- 401:检查
UIUI_API_KEY是否设置、令牌是否过期或复制时带入空格;不要把完整令牌贴进日志。 - 403:核对账户权限、渠道分组、模型授权或平台策略;不要自动绕过限制。
- 429:表示限流或配额问题,使用指数退避并设置最大尝试次数;不要无限并发重试。
- 超时与 5xx:区分连接失败、读取超时和上游异常;请求是否已计费可能不明确,重试前考虑幂等性和重复成本。
- 400 或参数不兼容:先用最小请求(
model、messages)排查,再逐项增加参数;不同渠道对temperature、max_tokens、结构化输出等支持不同。
API 费用通常受输入、输出 token、模型与渠道倍率影响;同一文本多次重试会增加调用量。请先用少量脱敏数据测试,并在主站查看实际账单。生产部署还应设置单用户配额、总预算、超时、审计记录、数据保留策略和密钥轮换。对于包含客户、财务、业务机密的数据,先取得处理授权,必要时本地脱敏或不发送到第三方。
参考资料与验证边界
- JieAGI 代码示例栏目
- uiuiAPI 主站
- OpenAI Chat Completions API 参考(仅用于兼容协议结构说明,不代表聚合渠道完全等同官方)
- Python requests 文档 / Node.js 文档

关注 AI 前沿动态,分享模型、工具与实战教程。
暂无评论