
Python AI 软件国际化教程:批量翻译 CSV 文案并自动检查占位符
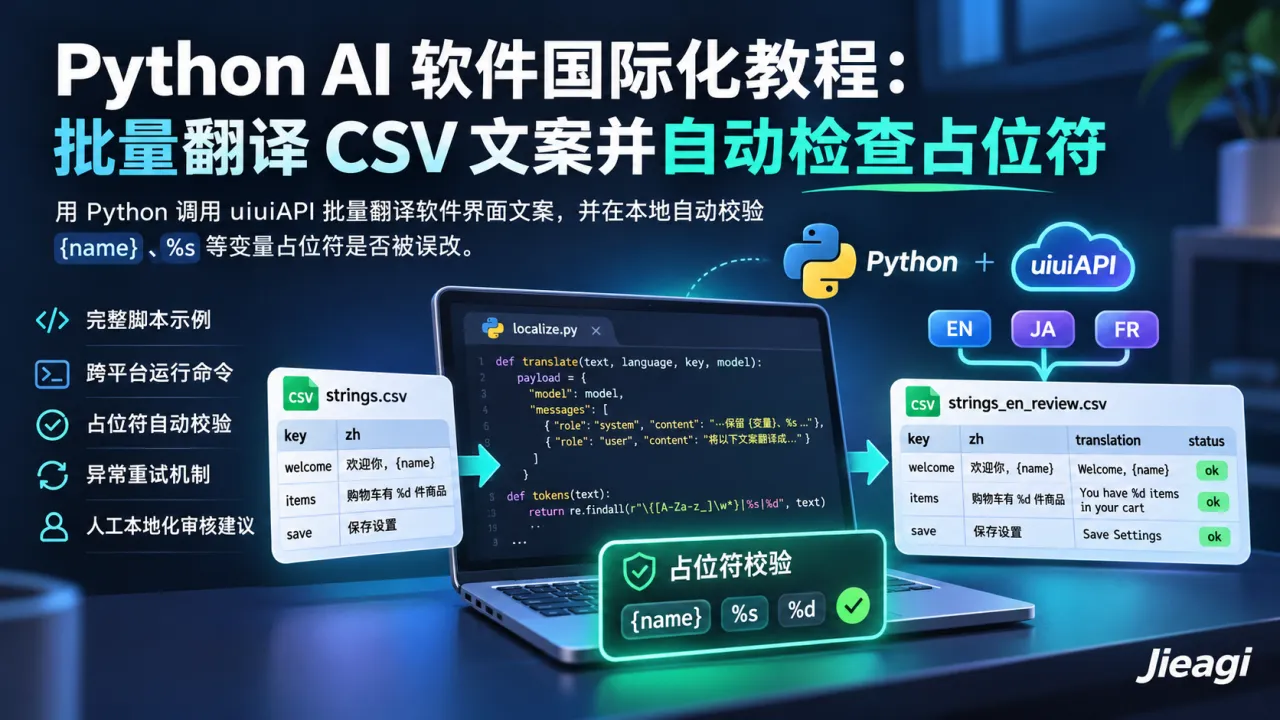
通过 Python 读取中文软件界面 CSV 文案,调用 uiuiAPI 兼容聊天接口翻译为英语、日语或法语,并在本地自动校验 {name}、%s 等变量占位符是否被误改。文章提供完整脚本、跨平台运行命令、待审输出、异常重试与人工本地化审核建议,适合网站及 SaaS 产品。
软件多语言翻译最容易忽略什么?
给网站或 SaaS 增加多语言支持,难点不只是把“提交订单”翻成英语。界面文案常含动态变量,例如 欢迎你,{name};还有格式化符号 %s、%d。如果模型把变量名翻译了,页面可能显示错误甚至在运行时抛出异常。因此,可靠的翻译流程必须把文本生成与程序校验结合起来。
本文搭建一个轻量的 CSV 本地化助手:输入中文文案与稳定的 key,按目标语言逐条调用文本模型,随后使用正则校验占位符集合是否保持一致。只有通过基础校验的译文才进入输出列;失败的条目标记为待人工复核。它适用于小型产品的初次国际化,也适合增量维护翻译文件。
方案边界与数据结构
输入文件使用两列:key 是程序引用的稳定键,zh 是中文原文。输出包含原文、译文和状态,便于开发者在合并资源文件前人工检查。此示例支持 en、ja、fr 三种目标语言;可以自行扩展语言映射。注意,占位符检查只能发现部分格式错误,不能验证语义、文化适配、长度限制或专业术语一致性。
安装与项目文件
使用 Python 3.10+,安装 python -m pip install requests。创建 localize.py 和 strings.csv。Windows PowerShell 中设置 $env:UIUI_API_KEY="你的令牌" 与 $env:MODEL="账户可用模型ID";macOS/Linux 使用 export UIUI_API_KEY='你的令牌'、export MODEL='账户可用模型ID'。请勿把密钥提交到仓库。
strings.csv 内容:
key,zh
welcome,"欢迎你,{name}"
items,"购物车有 %d 件商品"
save,"保存设置"
将完整代码保存为 localize.py:
import csv
import os
import sys
import time
from pathlib import Path
import requests

URL = "https://api.uiuihao.com/v1/chat/completions"
LANGS = {"en": "英语", "ja": "日语", "fr": "法语"}

def translate(text, language, key, model):
    payload = {"model": model, "messages": [
        {"role": "system", "content": "你是软件本地化译者。只输出翻译结果,保留 {变量}、%s、HTML 标签和换行,不添加解释。"},
        {"role": "user", "content": f"将以下软件界面文案翻译成{language},保持简洁:\n{text}"}
    ]}
    for n in range(3):
        try:
            r = requests.post(URL, json=payload,
                headers={"Authorization": f"Bearer {key}"}, timeout=(10, 45))
            if (r.status_code == 429 or r.status_code >= 500) and n < 2:
                time.sleep(2 ** n)
                continue
            r.raise_for_status()
            result = r.json()["choices"][0]["message"]["content"]
            if not isinstance(result, str):
                raise ValueError("返回不是文本")
            return result.strip()
        except (requests.RequestException, ValueError, KeyError, IndexError, TypeError) as exc:
            if n == 2:
                raise RuntimeError(f"翻译失败:{type(exc).__name__}") from exc
            time.sleep(2 ** n)
    raise RuntimeError("没有返回结果")

def tokens(text):
    import re
    return sorted(re.findall(r"\{[A-Za-z_][A-Za-z0-9_]*\}|%s|%d", text))

def main():
    if len(sys.argv) != 3 or sys.argv[2] not in LANGS:
        raise SystemExit("用法: python localize.py strings.csv en|ja|fr")
    key, model = os.getenv("UIUI_API_KEY"), os.getenv("MODEL")
    if not key or not model:
        raise SystemExit("请设置 UIUI_API_KEY 与 MODEL")
    rows = list(csv.DictReader(Path(sys.argv[1]).open(encoding="utf-8-sig", newline="")))
    if not rows or not {"key", "zh"}.issubset(rows[0]):
        raise SystemExit("CSV 必须包含 key,zh 列")
    output = []
    for row in rows:
        original = row["zh"]
        translated = translate(original, LANGS[sys.argv[2]], key, model)
        valid = tokens(original) == tokens(translated)
        output.append({"key": row["key"], "zh": original,
                       "translation": translated if valid else "",
                       "status": "ok" if valid else "review_placeholder"})
        print(row["key"], output[-1]["status"])
    target = Path(f"strings_{sys.argv[2]}_review.csv")
    with target.open("w", encoding="utf-8-sig", newline="") as f:
        writer = csv.DictWriter(f, fieldnames=["key", "zh", "translation", "status"])
        writer.writeheader()
        writer.writerows(output)
    print("已写入待审文件:", target)

if __name__ == "__main__":
    main()
运行与输出示意
执行 python localize.py strings.csv en,或把 en 改成 ja、fr。脚本会逐行调用接口,并生成 strings_en_review.csv 等待审核。预期示意:welcome 的译文保留 {name};items 的译文保留 %d;save 返回简洁的界面按钮文案。如果某条译文把 {name} 改为 {username},状态会成为 review_placeholder,翻译列清空,避免误用。
示例未实际发送付费请求,也没有验证特定模型对三种语言的翻译质量。运行前应先在主站确认所选模型具有文本生成能力,并检查账户余额、权限与渠道限制。
为什么采用“生成后校验”
提示词要求模型保留变量,但模型并非编译器。仅靠自然语言指令,仍可能出现变量拼写变化、额外解释、格式符丢失等情况。本地正则提取 {变量}、%s、%d,再排序比较,能捕获这些常见错误。对于 ICU MessageFormat、复数规则、HTML 富文本、嵌套模板以及转义序列,应采用专门解析器,而不是直接扩大正则表达式。
另一个重要选择是保留原始 key 和中文列,方便译者复核。译文不要直接覆盖原文,特别是当文案含金额、日期、合同或隐私说明时。翻译失败也不应默认用中文覆盖目标语言字段,否则可能让生产页面出现混合语言。
质量与费用优化
逐条调用便于定位失败,但请求次数较多。生产环境可以在本地缓存 key + 原文 + 语言 + 模型 的哈希,只有内容变化时重新翻译;也可以在保留 key 对齐的前提下分批处理,减少请求开销。重试有最大次数,避免 429 时持续冲击服务。对于语言质量,建议维护术语表,例如“令牌”“余额”“订阅”等专用词,并让人工译者审查长度、语气与上下文。
如果项目包含大量按钮、提示信息和表单错误文案,还应自动检查译文长度是否超出设计限制,检查 HTML 标签是否平衡,检测缺失 key,并在 CI 中阻止占位符不一致的资源文件合并。涉及法律、支付、医疗等高风险文案时,不应依赖机器翻译直接上线。
总结
AI 可以显著加快初稿翻译,但稳定的国际化交付依赖可追踪的 key、自动化占位符检查和人工审校。这个脚本提供一个可复制的起点:既利用模型的语言能力,也保留工程系统必须具备的确定性验证。
准备工作与接口说明
准备 Python 3.10+(Node.js 案例使用 Node.js 20+)、可以访问网络的终端,以及从 uiuiAPI 主站控制台申请的 API Key。uiuiAPI 是第三方模型聚合服务,并非模型厂商官方接口;支持哪些模型、请求参数、计费倍率及限额,应以主站模型广场、账户权限和实际渠道为准。本文使用 OpenAI 兼容的 Chat Completions 请求形态,不能据此推断所有模型均支持所有能力。
所有示例统一调用 https://api.uiuihao.com/v1/chat/completions,不在客户端代码里写死密钥。模型通过 MODEL 环境变量选择:请填入自己账户可用、支持文本聊天的实际模型 ID。示例输出仅展示可能的预期格式,并非真实模型回包;本轮没有发送付费请求。
常见故障、安全与成本
- 401:检查
UIUI_API_KEY是否设置、令牌是否过期或复制时带入空格;不要把完整令牌贴进日志。 - 403:核对账户权限、渠道分组、模型授权或平台策略;不要自动绕过限制。
- 429:表示限流或配额问题,使用指数退避并设置最大尝试次数;不要无限并发重试。
- 超时与 5xx:区分连接失败、读取超时和上游异常;请求是否已计费可能不明确,重试前考虑幂等性和重复成本。
- 400 或参数不兼容:先用最小请求(
model、messages)排查,再逐项增加参数;不同渠道对temperature、max_tokens、结构化输出等支持不同。
API 费用通常受输入、输出 token、模型与渠道倍率影响;同一文本多次重试会增加调用量。请先用少量脱敏数据测试,并在主站查看实际账单。生产部署还应设置单用户配额、总预算、超时、审计记录、数据保留策略和密钥轮换。对于包含客户、财务、业务机密的数据,先取得处理授权,必要时本地脱敏或不发送到第三方。
参考资料与验证边界
- JieAGI 代码示例栏目
- uiuiAPI 主站
- OpenAI Chat Completions API 参考(仅用于兼容协议结构说明,不代表聚合渠道完全等同官方)
- Python requests 文档 / Node.js 文档

关注 AI 前沿动态,分享模型、工具与实战教程。
暂无评论