
OpenAI防蒸馏报告:GPT-6.2推理链提取率降至0.2%
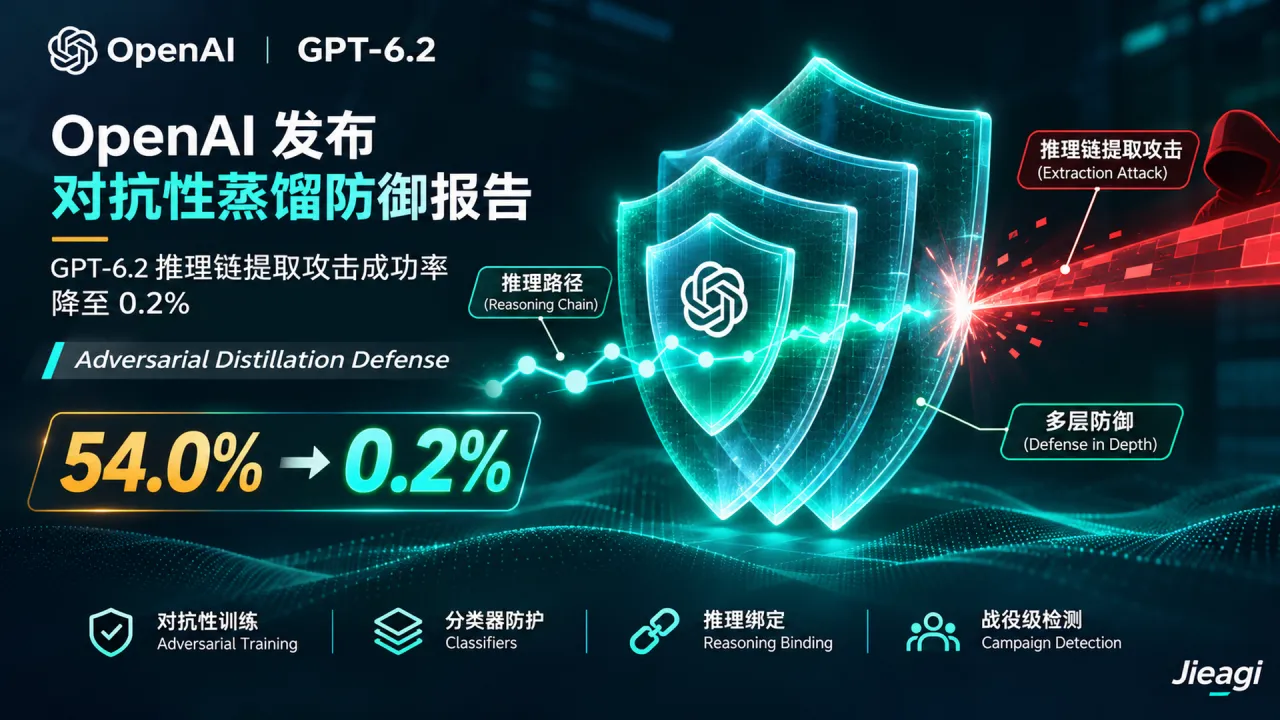
OpenAI于2026年11月20日发布对抗性蒸馏防御技术报告,披露GPT-6.2 Astra通过模型行为对抗训练、流式与Tool-Call输出分类器及API推理绑定,将黑盒推理链提取成功率从54.0%降至0.2%,同时分析对API开发者的影响。
目录 · 9 节
OpenAI 发布《对抗性蒸馏防御》报告:GPT-6.2 推理链提取成功率降至 0.2%,API 机制发生了哪些变化?
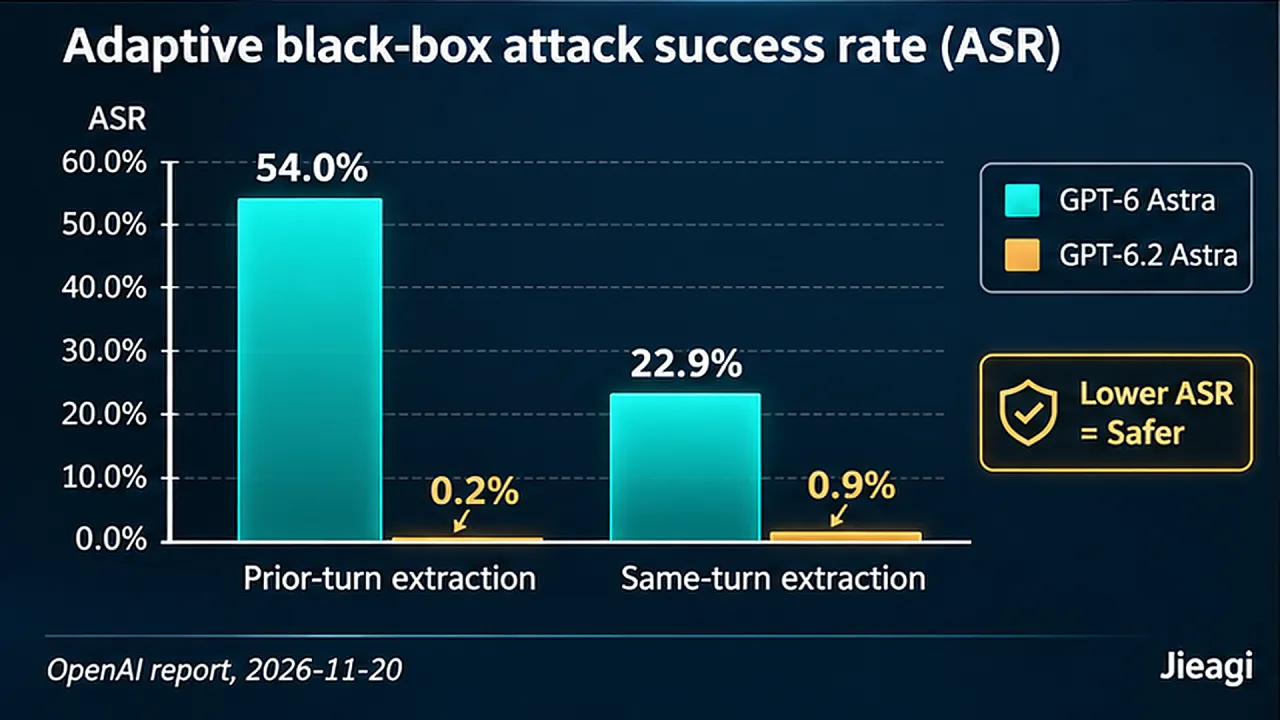
2026 年 11 月 20 日,OpenAI 正式发布《对抗性蒸馏防御》(Combatting adversarial distillation)技术报告,首次系统披露其针对前沿推理模型(Frontier Reasoning Models)的防蒸馏架构。根据报告披露的自适应黑盒红队测试数据,针对“从历史请求中提取受保护推理链(Protected Reasoning)”的攻击成功率(ASR),已从 GPT-6 Astra 的 54.0% 大幅降至 GPT-6.2 Astra 的 0.2%(针对当前请求的提取成功率则从 22.9% 降至 0.9%)。
对于广大的 AI API 开发者和企业应用架构师而言,这份报告不仅是一次安全防御升级的战报,更直接解释了近期 OpenAI API 在多轮对话、Tool-Call(工具调用)流式拦截以及推理状态管理上的底层逻辑变化。
一、为什么“推理链(CoT)蒸馏”成了安全与商业的双重红线?
在传统的模型蒸馏中,学生模型通常只能学习教师模型的最终输出(Final Response)。但随着推理模型(如 GPT-6 系列)普及,模型内部生成的思维链(Chain-of-Thought,OpenAI 称之为 Protected Reasoning)包含了大量的试错路径、规划逻辑与工具调用决策,其训练价值远高于单纯的最终答案。
OpenAI 在报告中引用了一项内部网络安全蒸馏实验,直观对比了“仅用用户可见的推理摘要”与“使用精确推理链”作为训练数据的差异:
- 实验设置:使用相同的预训练学生模型,分别基于 Astra 级教师模型在编程与防御性网络安全任务上的轨迹进行监督微调(SFT),随后在网络安全与代码环境中进行轻量级强化学习(RL)。
- 核心结论:在 ExploitBench 与 SEC-bench Pro 两项安全基准测试中,基于精确推理链微调的学生模型整体显著优于仅使用推理摘要的基线;即便经过后续 RL 训练,在高推理预算下,精确推理链训练出的学生模型依然具备更高的攻击能力迁移上限。
这意味着,如果恶意行为者通过提示词注入或 API 漏洞批量提取前沿模型的精确推理链,就能在低成本下训练出具备同等复杂任务能力(如漏洞挖掘与利用)、却完全剥离了原厂安全护栏(Safeguards)的衍生模型。
二、技术拆解:OpenAI 如何在请求级把 ASR 从 54.0% 压到 0.2%?
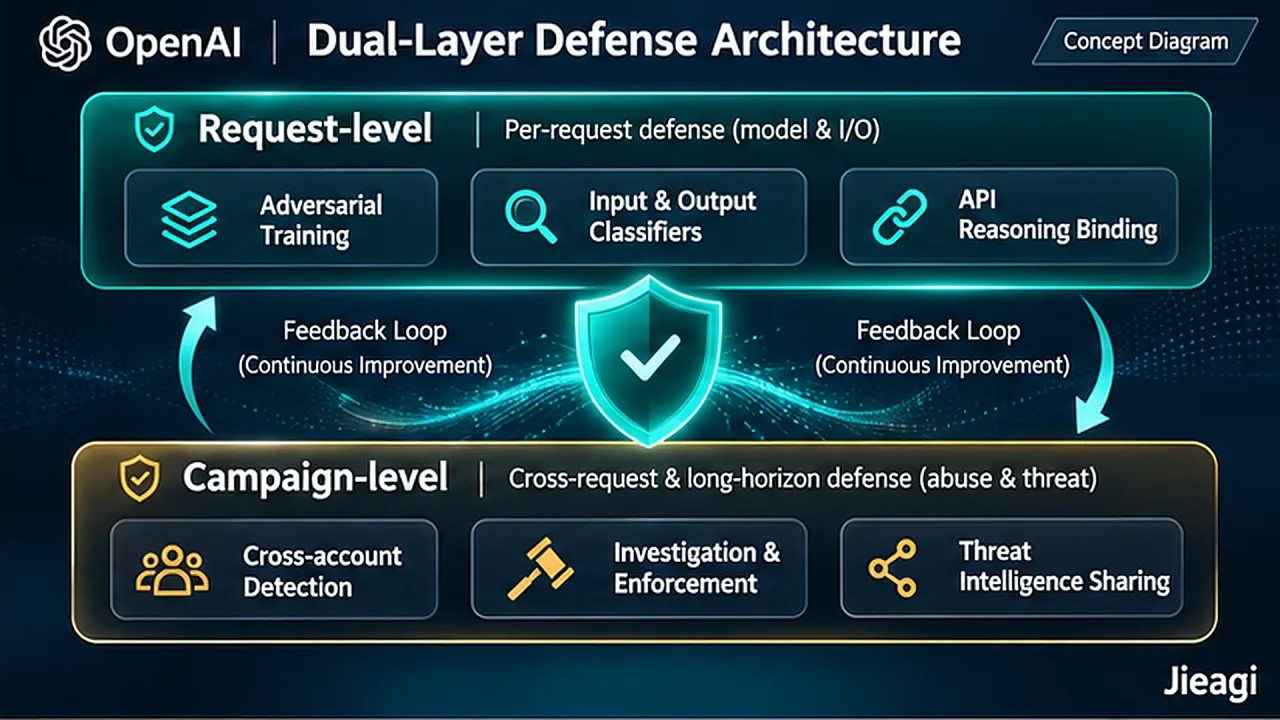
为了在不影响正常开发者解释需求的前提下堵住推理链泄露,OpenAI 在 GPT-6.2 Astra 和 GPT-6.2 Sol 中部署了三道彼此强化的请求级防线:
1. 模型行为对抗训练(Defensive Training)
OpenAI 将自动红队(Automated Red-Teaming)、安全调查以及外部白帽披露的成功提取案例转化为对抗训练样本,教导模型识别“套取内部推理过程”的诱导话术并直接拒绝,同时保留对正常教学解释与代码排错请求的响应能力。
2. 全链路输入/输出分类器(覆盖流式与 Tool-Call 参数)
这是对开发者体验影响最直接的一环。OpenAI 指出,模型不仅可能在助手回复文本中泄露推理链,还极易在调用外部工具的 tool_call 参数(Arguments)中夹带受保护的内部推理。因此,新的输出分类器同时覆盖流式(Streaming)与非流式响应,并在数据返回调用方之前对文本流和工具参数进行实时拦截。
3. API 级加密推理与对话历史强绑定
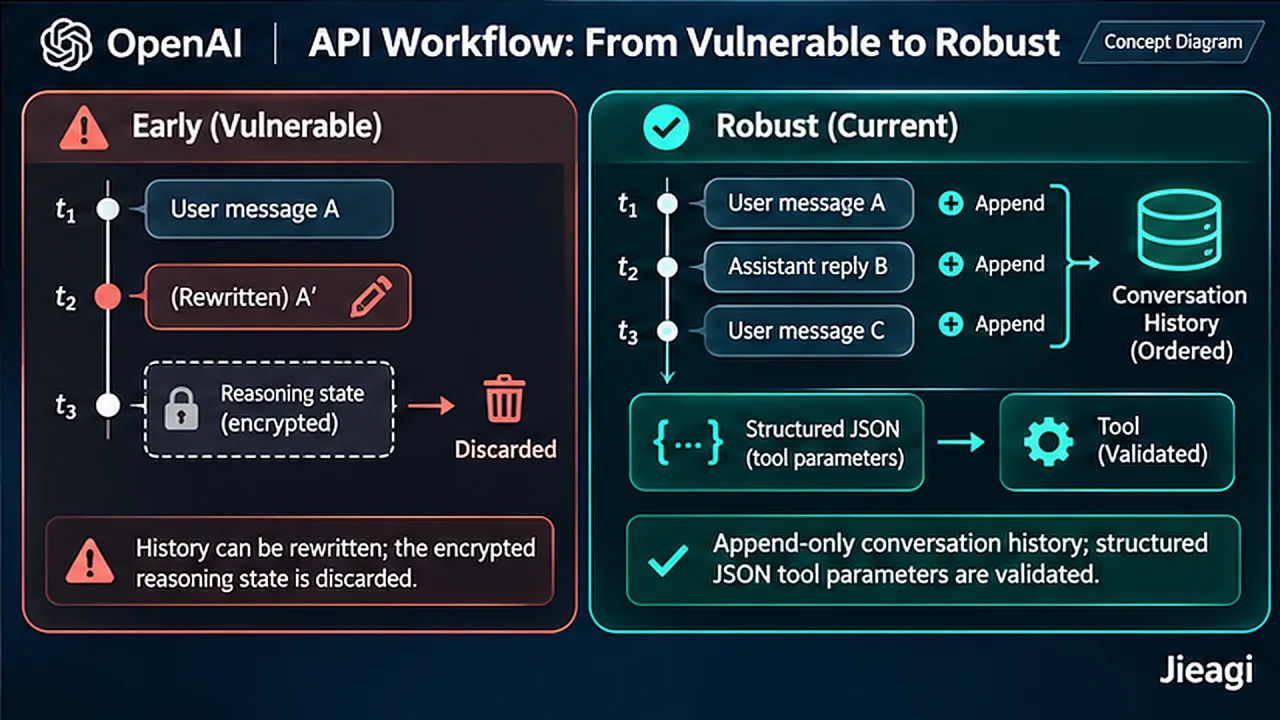
在 2026 年 9 月的早期披露中,OpenAI 曾修复过“将加密推理(Encrypted Reasoning)从 A 对话搬运到 B 对话并诱导模型解密可读化”的跨会话漏洞。而在 GPT-6.2 Astra 和 Sol 中,API 层面进一步收紧了隔离边界:
- 历史不可篡改绑定:模型的受保护推理与其生成的对话历史强绑定。如果开发者在多轮调用中修改或重写了较早的一条消息,API 会自动丢弃该消息之后生成的所有历史推理状态(以官方最新文档与行为为准)。
- 跨代模型隔离:禁止安全护栏较弱的旧款模型家族读取 GPT-6.2 Astra 与 Sol 生成的受保护推理状态。
- 跨租户隔离:严格限制用户、工作区(Workspace)及组织边界之间的加密推理复用。
| 攻击场景(自适应黑盒红队评估,6 个攻击模型聚合) | GPT-6 Astra(旧版护栏)ASR | GPT-6.2 Astra(新版护栏)ASR | 降幅 |
|---|---|---|---|
| 从历史请求中提取受保护推理链 | 54.0% | 0.2% | -53.8 个百分点 |
| 从当前请求中提取受保护推理链 | 22.9% | 0.9% | -22.0 个百分点 |
三、战役级溯源与地缘政治表态
除了单次请求拦截,OpenAI 还在报告中披露了战役级(Campaign-Level)的账号网络封禁规模:2026 年夏季以来,针对有组织蒸馏攻击的每周执法封禁规模已达到数千至数万个账号。OpenAI 还将威胁指标(IoC)通过 Frontier Model Forum 等渠道共享给其他模型厂商与合作云平台,要求部署伙伴执行一致的安全基准。
值得注意的是,报告专门设立章节阐述了“对抗性蒸馏的国家安全影响”,明确重申:
- 2026 年 2 月曾向美国国会通报关于 DeepSeek 试图蒸馏美国前沿模型的活动;
- 2026 年 9 月披露挫败了一起提取受保护推理链的行动,并将其核心活动归因于 Moonshot AI(Kimi 开发者)相关人员;
- 公开表态支持美国国会推进《Chip Security Act》《AI OVERWATCH Act》及《MATCH Act》等法案,主张将硬件出口管制与 API 防蒸馏结合。
四、对中文开发者与 API 用户的实际影响
对正常使用 OpenAI API 构建 Agent、编程助手或自动化工作流的开发者来说,新版防御机制有三个需要注意的工程细节(建议结合 [内链:OpenAI API 多轮对话与状态管理最佳实践] 一同排查):
- 慎用“编辑历史消息”重构上下文:如果你的 Agent 框架习惯在多轮执行中动态修改
messages列表里的历史用户消息或系统提示词来压缩上下文,在 GPT-6.2 上会直接触发 API 丢弃后续推理状态,导致模型重新思考甚至增加延迟与 Token 消耗。 - 排查 Tool-Call 流式响应的静默截断:当工具参数中包含大量复杂解释或类似思维链的草稿文本时,输出分类器可能触发风控拦截。建议在客户端做好
finish_reason异常捕获与降级提示,并引导模型仅在参数中输出结构化字段。 - 合规账号与代理网络风险:OpenAI 在战役级检测中高度关注跨账号集群行为与代理网络特征。企业或团队调用 API 时,应避免使用来路不明的共享中转池或高频切换异常出口 IP,以免被误判为协同蒸馏网络而遭批量封号(相关合规迁移可参考 [内链:多模型 API 网关高可用容灾方案])。
(注:以上安全策略、API 行为细节与封禁标准均以 OpenAI 官方最新公布为准。)
常见问题(FAQ)
Q1:OpenAI 的“受保护推理(Protected Reasoning)”和普通的推理摘要有什么区别?
A:推理摘要是面向用户展示的高层概览,而受保护推理是模型在内部生成完整答案前逐步推演的精确思维链(CoT)。OpenAI 实验显示,使用精确推理链蒸馏出的模型在网络安全等复杂任务上的能力上限显著高于仅用摘要训练的模型。
Q2:普通开发者调用 GPT-6.2 Astra 的 API 会被误伤吗?
A:正常请求模型“解释原理”或“分步教学”不会受到限制,模型经过对抗训练后会区分合法解释需求与恶意提取内部推理轨迹的诱导。但如果在 tool_call 参数中夹带冗长推理或频繁修改历史对话状态,可能会遇到输出分类器拦截或推理状态被丢弃的情况。
Q3:为什么在多轮对话中修改早前的消息会导致推理状态丢失?
A:从 GPT-6.2 Astra 和 GPT-6.2 Sol 开始,OpenAI 在 API 层面将受保护的加密推理与产生它的对话历史进行了严格绑定,防止攻击者通过篡改上下文或跨会话搬运来诱导模型吐出早期推理内容。
Q4:企业如何降低被误判为“协同蒸馏”账号的风险?
A:建议使用企业官方直连通道或正规授权的云厂商 API 端点(如 Azure OpenAI 等),避免与高风险代理节点混用 IP,并确保遵守官方使用条款。具体政策与风控规则以官方最新公布为准。
转载请注明出处:界智通 · https://www.jieagi.com/aizixun/763.html

关注 AI 前沿动态,分享模型、工具与实战教程。
暂无评论