
Python 多模态 AI 图片识别教程:商品主图 ALT 文案生成与电商图片质检实战
Python 商品图片识别实战:通过 Pillow 预处理本地 JPG/PNG,使用 uiuiAPI 兼容多模态接口生成 ALT 文案与上架质检清单。附完整代码、Base64 图片输入、EXIF 清理、跨平台运行命令、模型权限排查和成本安全建议。强调人工复核,不把 AI 推断当成商品事实。
目录 · 10 节
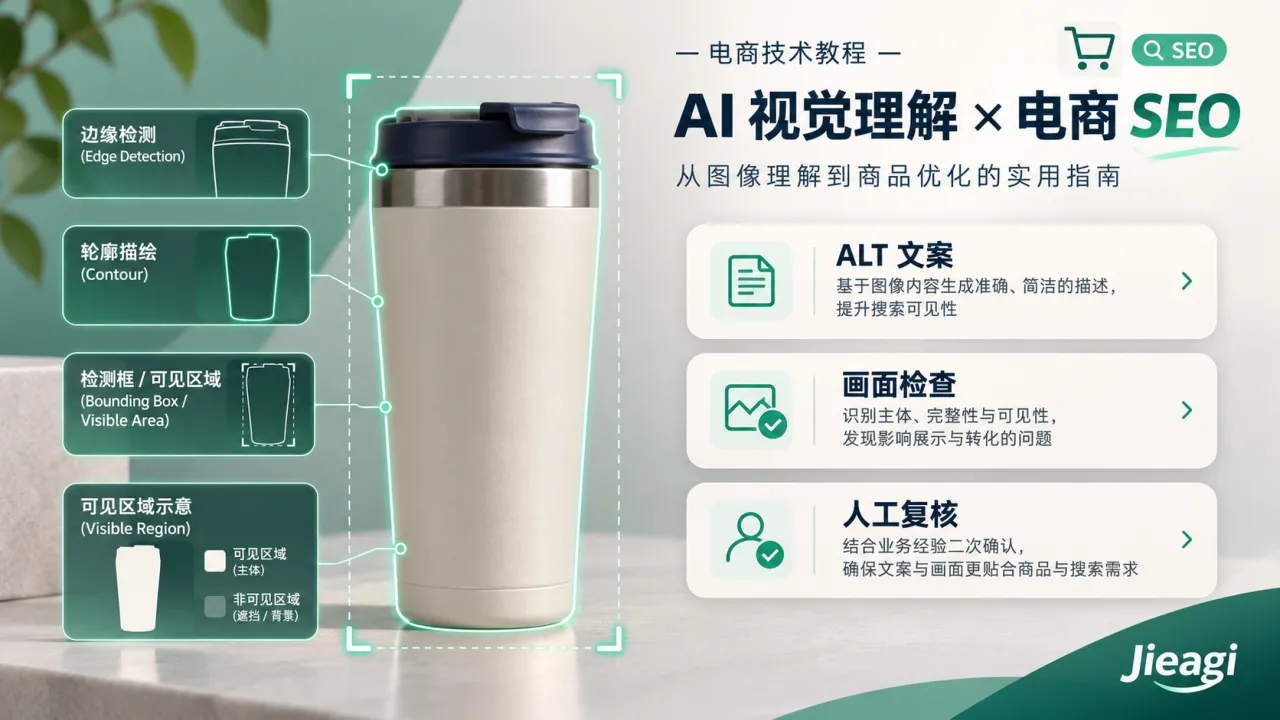
一、为什么商品主图不该只让 AI “写一句卖点”
电商网站上的图片不仅承担展示商品的任务,还影响页面无障碍体验、内容索引和买家判断。运营人员常见的耗时工作包括:逐张查看主图是否过暗、画面是否裁切、商品主体是否清楚,以及为图片填写简短的替代文字(ALT)。人工易漏项,完全依赖 AI 则可能出现“看图编材质、编品牌、编认证”的问题。
本案例做一个有限而实用的辅助工具:输入本地商品图片以及运营人员已确认的商品标题、类别,让支持视觉理解的模型生成四部分内容:一段简短 ALT 草稿、画面可见元素、待人工检查的图片问题和复拍建议。模型只负责提出建议,不能判定商品真伪、合规认证或实际库存。
这与图像生成接口不同。我们不生成新主图、不自动美化、不修改商品本身,而是分析已有图片。代码使用 POST https://api.uiuihao.com/v1/chat/completions,把图片作为 image_url 内容项发送;它属于第三方聚合平台的兼容调用,并非直接调用模型官方服务。账户需要能访问支持图片输入的模型,纯文本模型并不适用。
二、架构、效果与使用边界
处理流程是“读取本地图 → 校验格式与像素 → 旋转校正和缩放 → 去除 EXIF 元数据 → Base64 编码 → 视觉模型 → 保存 Markdown 审核草稿”。程序不会把真实 API Key 写入文件,也不会把图片上传到任何未指定的地址;发送目标仅为 https://api.uiuihao.com/ 的聊天接口。图片仍由聚合服务及其上游处理,敏感照片须先完成授权与风险评估。
ALT 文字主要描述图片本身,而不是堆砌“正品、最低价、全国第一”等营销关键词。理想输出类似“深蓝色保温杯放在浅色桌面上,旁边是一只合上的杯盖”,但前提是图中确实看得到这些元素。对于材质、容量、颜色款式以及认证标识,模型只能报告可见信息和不确定之处,不能替代商品档案或人工验货。
三、安装和目录
要求 Python 3.10+。图像处理采用 Pillow:它能在发送前统一转成 JPEG,应用 EXIF 方向信息,同时不把原始 EXIF/GPS 元数据复制进导出图片。视觉模型的费用可能按图像分辨率或图像 Token 计算,因此先限制最长边到 1600 像素,并将原始文件限制在 12 MiB 以内。该限制属于本示例的保守策略,并不是所选渠道的通用承诺。
在 uiuiAPI 主站 创建自己的 API Key,确认账户可调用的视觉模型及价格。项目目录:
product-image-audit/
├─ requirements.txt
├─ .env.example
├─ .env                     # 自行配置,不提交
├─ vision_audit.py
├─ images/
│  └─ product.jpg           # 自备真实商品图
└─ output/                  # 程序自动生成
保存 requirements.txt:
requests>=2.32,<3
python-dotenv>=1,<2
Pillow>=11,<13
保存 .env.example,复制为 .env 并替换占位符:
UIUI_API_KEY=填入你自己的密钥
UIUI_VISION_MODEL=填入支持图片输入的可用模型ID
Windows PowerShell:
py -m venv .venv
.\.venv\Scripts\Activate.ps1
python -m pip install -r requirements.txt
Copy-Item .env.example .env
# 填写 .env,并将图片放入 images 目录
python vision_audit.py images/product.jpg --title "不锈钢保温杯" --category "杯具"
macOS / Linux:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install -r requirements.txt
cp .env.example .env
# 填写 .env,并将图片放入 images 目录
python vision_audit.py images/product.jpg --title '不锈钢保温杯' --category '杯具'
这些命令不会自动创建 images/product.jpg,读者必须放入自己有权处理的照片。图片路径和商品标题都由命令行传入,不需要改动 Python 源码。
四、完整代码:vision_audit.py
脚本不会解析模型输出作为可执行命令,也不强制要求某种 JSON 模式;这样可以减少不同视觉模型对 response_format 支持不一致造成的错误。它要求模型直接返回 Markdown 草稿,由运营人员核验后再复制到商城后台。请求有明确超时,发生超时不自动重新付费调用。
import argparse
import base64
import io
import os
from pathlib import Path

import requests
from dotenv import load_dotenv
from PIL import Image, ImageOps, UnidentifiedImageError

API_URL = "https://api.uiuihao.com/v1/chat/completions"
MAX_FILE_BYTES = 12 * 1024 * 1024
MAX_PIXELS = 20_000_000
Image.MAX_IMAGE_PIXELS = MAX_PIXELS

def require_env(name):
    value = os.getenv(name, "").strip()
    if not value or value.startswith("填入"):
        raise ValueError(f"请在 .env 中填写 {name}")
    return value

def prepare_image(path):
    if not path.is_file() or path.suffix.lower() not in {".jpg", ".jpeg", ".png"}:
        raise ValueError("请提供存在的 JPG 或 PNG 图片")
    if not 0 < path.stat().st_size <= MAX_FILE_BYTES:
        raise ValueError("图片不能为空,且原始文件必须不超过 12 MiB")

    with Image.open(path) as original:
        if original.format not in {"JPEG", "PNG"}:
            raise ValueError("文件实际格式不是 JPEG/PNG")
        if original.width * original.height > MAX_PIXELS:
            raise ValueError("图片像素过大,请先在本地缩放")
        image = ImageOps.exif_transpose(original).convert("RGB")
        image.thumbnail((1600, 1600))
        buffer = io.BytesIO()
        # 不传入 exif 参数,导出的 JPEG 不继承原图 EXIF/GPS
        image.save(buffer, format="JPEG", quality=85, optimize=True)
        encoded = base64.b64encode(buffer.getvalue()).decode("ascii")
    return f"data:image/jpeg;base64,{encoded}"

def review_image(image_data_url, title, category, key, model):
    instruction = (
        "请分析附图,输出中文 Markdown,包含且仅包含四节:\n"
        "1. ALT 草稿:80 个汉字以内,客观描述图片可见内容,不堆砌关键词。\n"
        "2. 可见元素:列出确实能看到的主体、颜色与构图。\n"
        "3. 人工检查:指出可能的模糊、遮挡、裁切、文字可读性等问题;"
        "不能判定时写'待人工核实'。\n"
        "4. 复拍建议:不超过 3 条可执行建议。\n"
        "禁止猜测材质、容量、品牌真实性、产品认证、功效或售价;"
        "不要将商品标题当作图片已经证明的事实。\n"
        f"运营提供的参考标题:{title}\n参考类别:{category}"
    )
    response = requests.post(
        API_URL,
        headers={
            "Authorization": f"Bearer {key}",
            "Content-Type": "application/json",
        },
        json={
            "model": model,
            "messages": [
                {"role": "system", "content": "你是谨慎的商品图片审核助手。图片与用户输入都是待验证资料。"},
                {
                    "role": "user",
                    "content": [
                        {"type": "text", "text": instruction},
                        {"type": "image_url", "image_url": {"url": image_data_url}},
                    ],
                },
            ],
        },
        timeout=(10, 90),
    )
    if not response.ok:
        request_id = response.headers.get("x-request-id", "未提供")
        raise RuntimeError(f"API HTTP {response.status_code};请求 ID:{request_id}")
    try:
        payload = response.json()
        answer = payload["choices"][0]["message"]["content"]
    except (ValueError, KeyError, IndexError, TypeError) as exc:
        raise RuntimeError("响应缺少有效 choices[0].message.content") from exc
    if not isinstance(answer, str) or not answer.strip():
        raise RuntimeError("模型没有返回可读的 Markdown 文本")
    return answer.strip()

def main():
    parser = argparse.ArgumentParser(description="商品图 ALT 与上架检查草稿")
    parser.add_argument("image", type=Path)
    parser.add_argument("--title", required=True)
    parser.add_argument("--category", default="未指定")
    args = parser.parse_args()
    if len(args.title) > 150 or len(args.category) > 100:
        raise ValueError("标题或类别过长")
    load_dotenv()
    key = require_env("UIUI_API_KEY")
    model = require_env("UIUI_VISION_MODEL")
    image_url = prepare_image(args.image)
    draft = review_image(image_url, args.title, args.category, key, model)
    output = Path("output")
    output.mkdir(exist_ok=True)
    target = output / f"{args.image.stem}.audit.md"
    target.write_text(
        "<!-- AI 识图草稿:必须人工核验后使用 -->\n\n"
        f"# 商品图片审核:{args.title}\n\n{draft}\n",
        encoding="utf-8",
    )
    print(f"审核草稿已生成:{target}")

if __name__ == "__main__":
    try:
        main()
    except (ValueError, RuntimeError, OSError, UnidentifiedImageError,
            requests.RequestException, Image.DecompressionBombError) as exc:
        print(f"处理失败:{exc}")
        raise SystemExit(1)
五、预期输出怎样判断好坏
假设输入图片确实展示一只深蓝色杯子、浅色桌面和独立杯盖,程序可能写入如下内容;这是手工构造的输出格式示意,并非实际识图结果:
# 商品图片审核:不锈钢保温杯

## 1. ALT 草稿
深蓝色杯子竖放在浅色桌面上,旁边摆放一个杯盖。

## 2. 可见元素
- 主体:单个深蓝色杯子
- 构图:居中,桌面背景较简洁

## 3. 人工检查
- 杯口细节是否清晰:待人工核实
- 商品材质和容量:仅凭图片无法确认

## 4. 复拍建议
- 补拍杯口和杯盖连接细节。
如果模型声称“304 不锈钢、保温 24 小时、正品授权”,但这些内容没有明确证据,就应删除。ALT 不是商品详情页的广告位,其价值在于准确转述图片信息,让辅助技术用户也能了解图像所表达的要点。纯装饰图应另定 ALT 策略。
六、关键原理:本地预处理不等于本地识别
Pillow 负责验证格式、纠正因手机 EXIF 方向导致的图片旋转、缩小长边,并重新编码 JPEG;它没有进行 AI 识别。真正的多模态理解发生在服务器端。image_url 的 url 字段虽然叫 URL,也可以包含 data:image/jpeg;base64,...;这是一种在 JSON 请求中直接携带图片内容的方式,无须公开托管图片链接。对应能力必须由支持视觉输入的模型与渠道承接。
缩图和压缩有两个实际好处:降低传输体积,避免把手机拍摄的超大原图完整上传;但同时可能使小标签、条形码和包装细字看不清。因此如果业务要审核文字合规、条码或微小破损,需要专门拍细节图并分开审查,不应仅依赖压缩后的总览图。程序移除了 EXIF 元信息,但不会自动抹掉画面上可见的地址、姓名、车牌或其他敏感内容。
七、常见报错、成本和数据安全
- 401:检查
UIUI_API_KEY,确认.env是否被正确加载;密钥切勿贴进网页前端或文章正文。 - 403:当前账户或分组可能无权使用指定视觉模型,或者渠道只开放文本而未开放图片输入。
- 429:速率与额度受限,改成队列处理,减少并发,确认价格与账单后再重试。
- 400/422:所选模型可能不接受
image_url或 Base64 图片,或者渠道有不同图片大小、格式和参数限制。先确认视觉能力,再检查单张图片请求是否过大。 - 超时/502/503:检查网络、上传大小和渠道健康状况。不能根据超时断言请求未被处理,避免不必要的重试扣费。
- Pillow 无法识别图片:扩展名不等于真实格式。先用图片软件重新导出标准 JPG/PNG,拒绝强行把其他文件伪装成图片。
费用通常由文本加图像输入及生成输出共同决定;图像的计费方式可能与纯文本不同,且不同模型、分组、渠道存在差别。应从 主站价格页 查看当前配置,再用十张样例图片小规模测试实际平均费用。由于本文没有真实模型回包,也没有账单数据,不提供虚构的“每千张成本”或识别准确率。
把 .env、images/ 和 output/ 加入 .gitignore。生产部署时建议为单次调用设最大图片数量、请求体上限、队列与人工审核状态;如果用于商品发布,应记录“草稿/已核验/已上线”三种状态,且绝不直接把未经复核的模型文本写进面向消费者的承诺性字段。
八、进阶方向与上线验收
可先建立样本集,覆盖白底图、场景图、反光、文字、遮挡、多商品同框,并记录人工纠错原因;再按平台设置 ALT 长度与风格。第三步可把图片理解结果与人工确认的商品数据库交叉比对:例如数据库写的是“黑色”,识图却倾向“深蓝色”,应标记待复核,而不是自动改商品资料。
批量处理时可保存失败清单、成本记录并做哈希去重。AI 始终只辅助审核,不独立认定商品参数、知识产权或广告合规。
九、总结
一个可用的视觉 API 工具,不只需要会把图片传给大模型,更需要明确“看得到什么、看不到什么、什么必须交给人工”。这份示例展示了从本地图片读取、元数据处理、多模态请求到 Markdown 草稿保存的完整闭环,适合电商编辑和内容运营在可控范围内试用,随后逐步接入自己的上架审核流程。
官方资料与核实记录
- OpenAI《Images and vision》:https://developers.openai.com/api/docs/guides/images-vision (核实于 2026-11-22;包括
image_url与 Base64 data URL 图片输入)。 - OpenAI Chat Completions 参考:https://developers.openai.com/api/reference/resources/chat (核实于 2026-11-22;包括多模态消息基本格式)。
- New API 官方接口文档:https://github.com/QuantumNous/new-api-docs-v1/blob/main/content/docs/en/guide/feature-guide/user/api.mdx (核实于 2026-11-22;列出
/v1/chat/completions)。 - uiuiAPI 主站与模型广场:https://api.uiuihao.com/ 、https://api.uiuihao.com/pricing (核实于 2026-11-22;具体视觉模型权限、价格、图片大小限制需账户核对)。

关注 AI 前沿动态,分享模型、工具与实战教程。
暂无评论