
Inkling 2 Mini深度解读:26B环路模型笔记本可跑
Thinking Machines Lab发布26.4B开源MoE模型Inkling 2 Mini,采用Looped Transformer架构每Token循环三次,20GB权重可在笔记本本地运行,DeepSWE v1.1达48.2%,本文深度解析其架构、基准与Jetson部署实测。
目录 · 8 节
Thinking Machines 发布 Inkling 2 Mini:26B 环路 Transformer 如何实现笔记本级前沿编码能力?
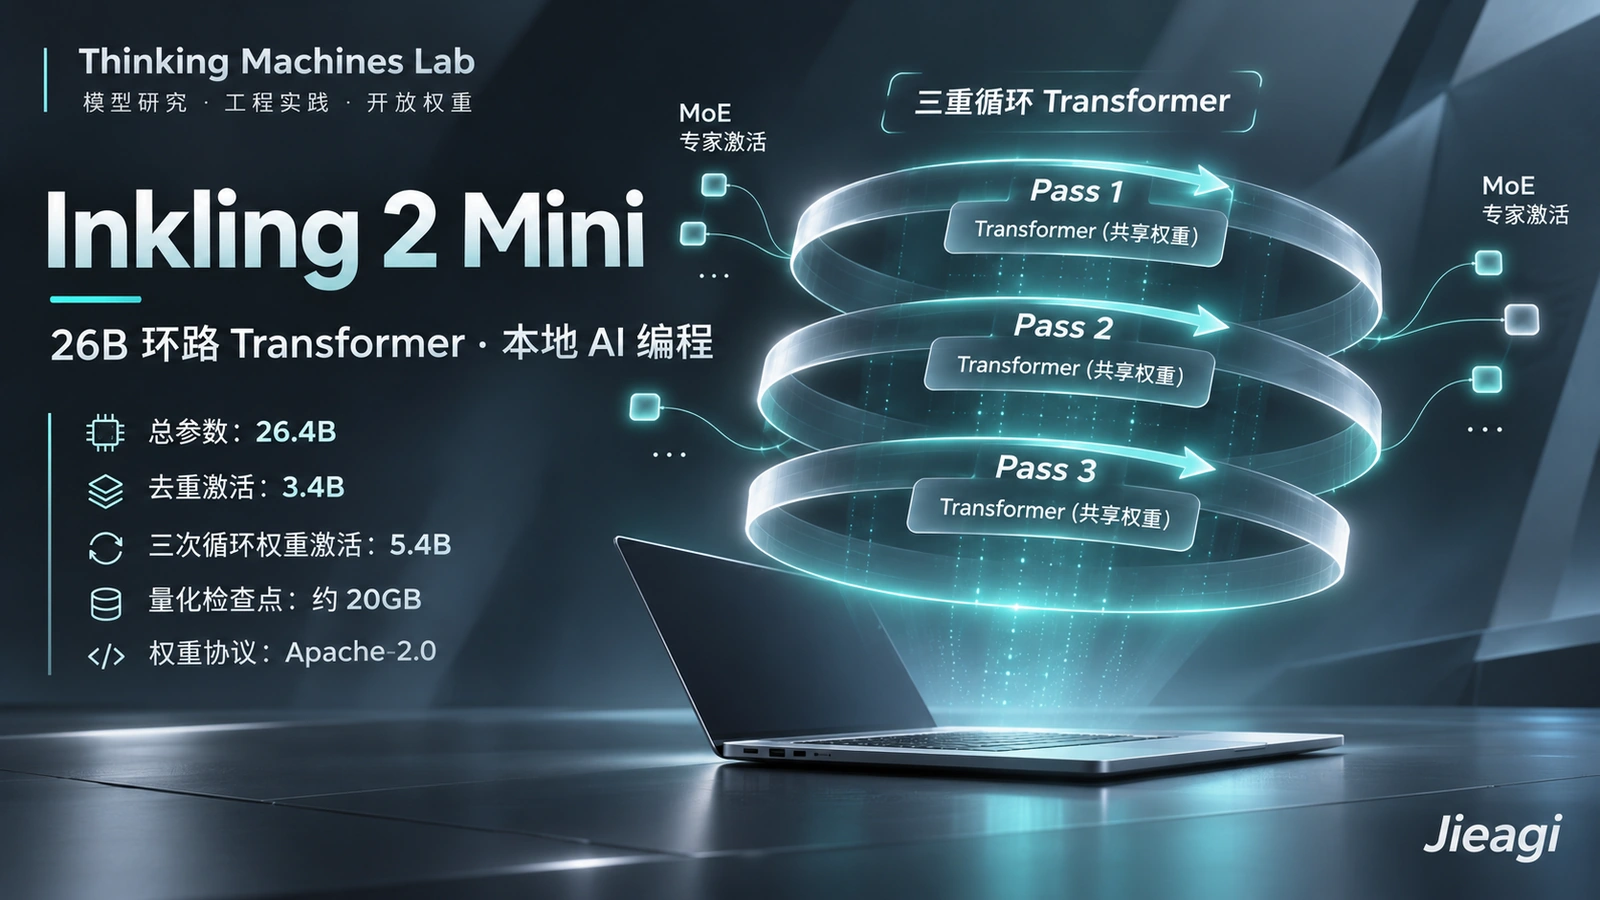
对于追求本地隐私和低推理成本的开发者而言,2026 年 11 月 20 日至 21 日迎来了一款极具工程启发性的开源新品。由 Thinking Machines Lab 推出的 Inkling 2 Mini 正式开源(Apache-2.0 协议),这款总参数仅 26.4B(单次激活仅 3.4B)的 MoE 模型,量化后仅需 20GB 即可在消费级笔记本上运行,却在 DeepSWE v1.1 编码基准上取得了 48.2% 的成绩,领跑 100B 参数以下的开源权重阵营。
一、发布了什么:26.4B 体积里的“三重循环”黑科技
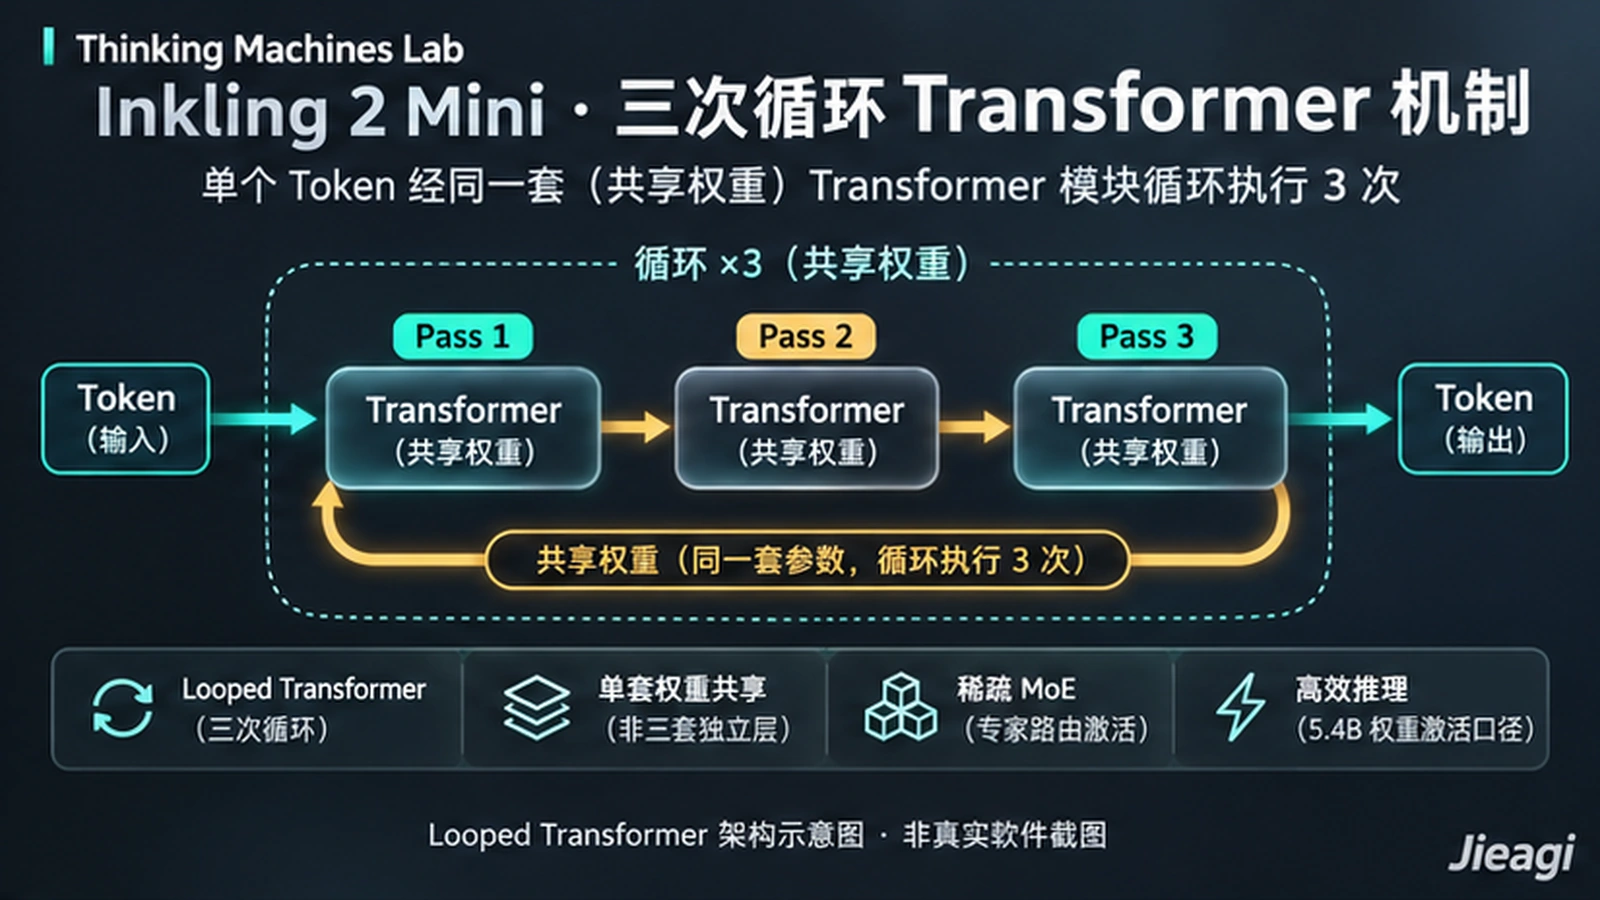
不同于传统大模型靠堆砌层数和参数量换取智商,Inkling 2 Mini 的核心突破在于 Looped Transformer(环路 Transformer) 设计:
- 参数与精度:总参数 26.4B 的稀疏混合专家(MoE)架构,每个 Token 仅激活 3.4B 参数;官方提供 NVFP4 / MXFP8 量化检查点,磁盘与显存占用约 20GB,支持文本与图像双模态输入。
- 循环推理机制:模型的中间 Transformer 层会对每个输入 Token 循环执行三次。这种“用算力换显存”的策略,使其在显存受限的端侧设备上拥有了更深的推理路径。
- 上下文与混合推理:支持高达 1,000,000(1M)Tokens 的超长上下文窗口,并采用混合推理模式(Hybrid Reasoning)。
- API 价格与开源协议:权重采用商业友好的 Apache-2.0 协议开放;托管 API 定价仅 $0.15 / 1M 输入 Tokens 与 $0.50 / 1M 输出 Tokens,缓存输入更低至 $0.015 / 1M Tokens(以官方最新公布为准)。
二、基准与竞品对比:100B 以下开源编码新标杆?
根据 BenchLM 2026 年 11 月 21 日汇总的公开基准数据 及 AI Weekly 报道,Inkling 2 Mini 在智能体、编码与多模态解析上的表现颇为亮眼,甚至在多项任务上超越了参数和定价远高于它的闭源轻量模型(如 xAI 今年 4 月发布的 Grok 4.3):
| 对比维度 | Inkling 2 Mini | Grok 4.3(闭源对比参照) |
|---|---|---|
| 权重开放与协议 | 开源权重(Apache-2.0) | 闭源专有 |
| API 输入 / 输出单价(/1M) | $0.15 / $0.50(缓存 $0.015) | $1.25 / $2.50(缓存 $0.20) |
| 上下文窗口 | 1M Tokens | 1M Tokens |
| BenchAlign 综合估分 | 55.9 / 100(排名 #69,估算证据) | 46.7 / 100(排名 #106,支持证据) |
| 编码专项得分(BenchAlign) | 53.9(估算) | 43.8(支持) |
| 智能体专项得分(BenchAlign) | 59.1(估算) | 43.3(支持) |
在具体的细粒度开源榜单上,Inkling 2 Mini 披露了如下成绩(需注意部分基准尚无 Grok 4.3 同口径交叉数据):
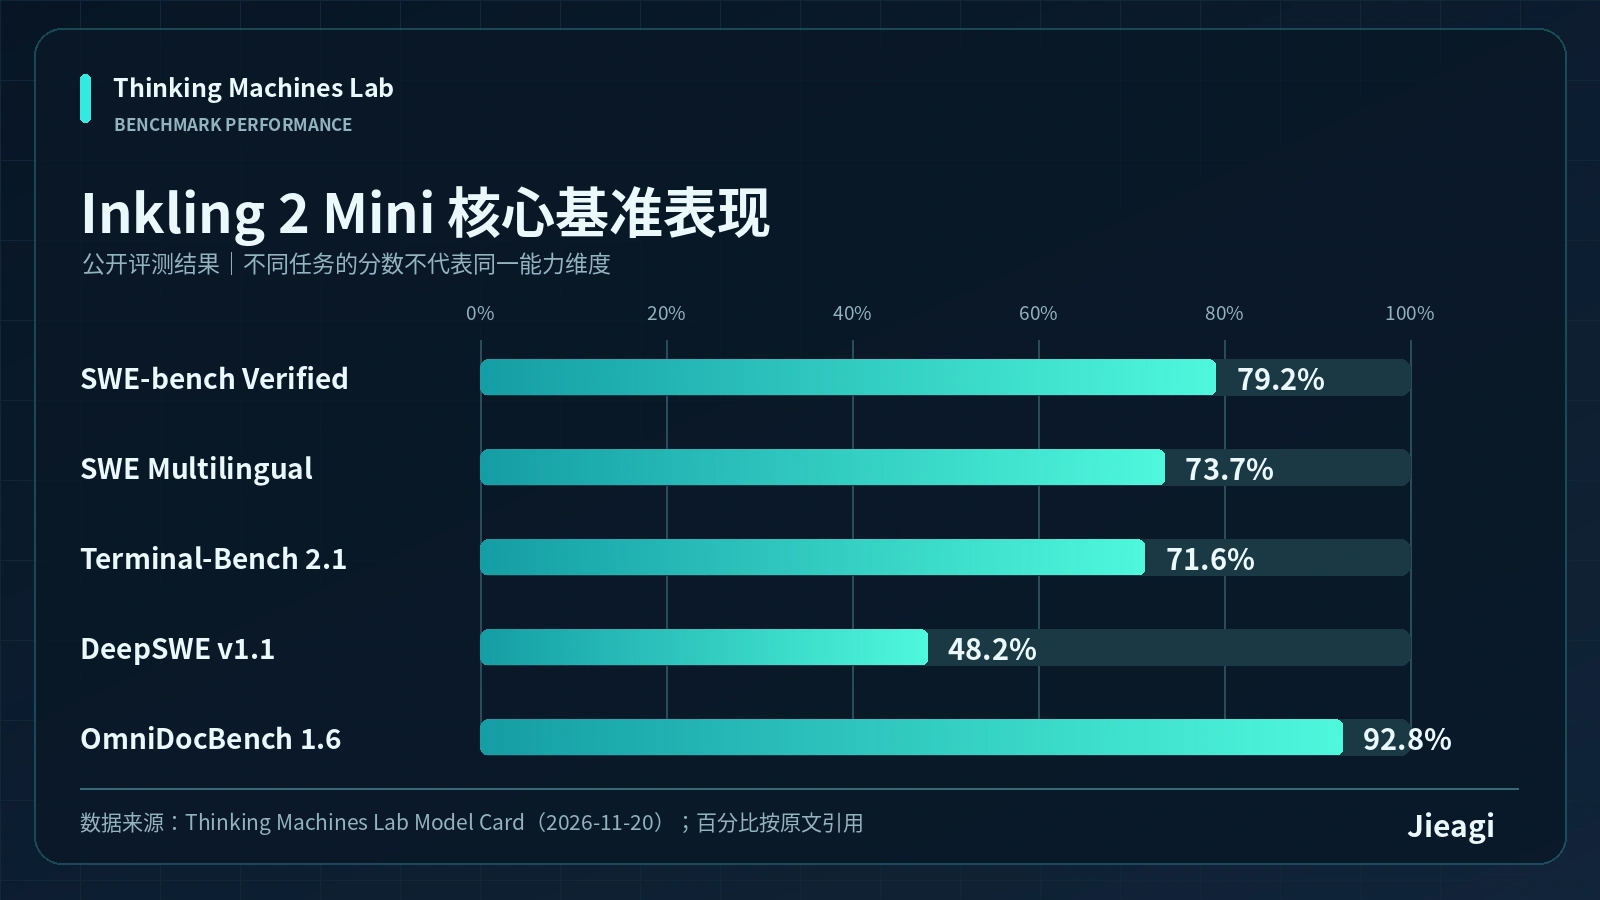
- 编码能力:SWE-bench Verified 达 79.2%、SWE Multilingual 73.7%、Terminal-Bench 2.1 71.6%、DeepSWE v1.1 达 48.2%。
- 文档与视觉:OmniDocBench 1.6 高达 92.8%、MMMU-Pro 74.9%、ScreenSpot Pro 76.5%。
- 安全对抗:据 Vals 评测,其在 CyberBench 上的得分与 Claude Opus 5.5 CVP 持平,而推理成本仅为其零头。
三、技术解读与端侧实测:Jetson AGX Thor 跑出 53 tok/s
由于环路结构需要反复读取同一组权重,Inkling 2 Mini 实际上非常适合高内存带宽的统一内存设备(如 Apple Silicon Mac 或 NVIDIA Jetson / DGX Spark)。
2026 年 11 月 21 日,开发者社区在 NVIDIA 开发者论坛发布了单台 Jetson AGX Thor(128GB) 上的 vLLM 完整实测配方:
- 生成速度:开启 DSpark 投机采样后达到 50–53 tok/s(关闭时为 39.6 tok/s,带宽利用率约 80%),Prefill 预填充速度约 3,600 tok/s,4 并发总吞吐达 82.5 tok/s。
- 实操避坑点:官方提供的
vllm/vllm-openai:inkling-2-mini镜像默认未包含 Thor 的 SM110(compute capability 11.0)内核,直接启动会报错conv_mix.cu: no kernel image is available。开发者需指定TORCH_CUDA_ARCH_LIST=11.0重新编译内核即可跑通 524K 长上下文(相关本地部署工具链可参考 [内链:vLLM 本地大模型量化部署调优指南])。
四、对开发者与企业的实际影响
- 端侧编码 Agent 迎来高性价比底座:过去在笔记本上跑开源编码模型往往在 30%–40% 的 SWE 通过率徘徊,Inkling 2 Mini 将 20GB 级设备的编码可用度拉升至接近云端中端模型的水平,适合离线内网研发与 [内链:本地 AI 编程助手集成方案]。
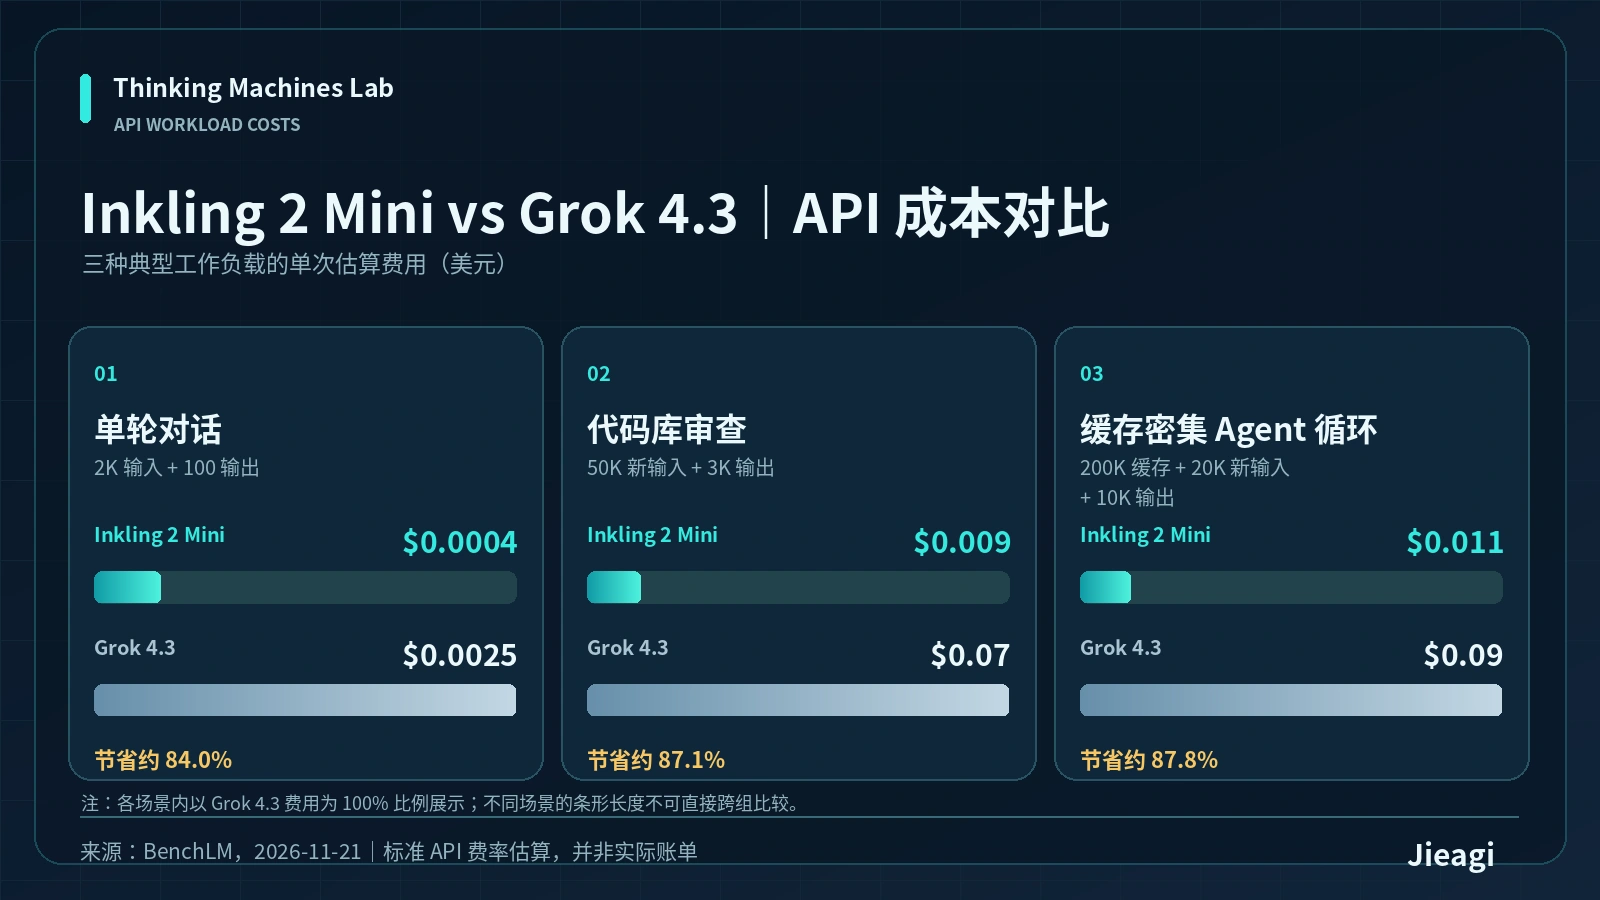
- 极致的 API 代理循环经济账:按 BenchLM 测算的“缓存密集型 Agent 循环(200K 缓存 + 20K 新输入 + 10K 输出)”场景,Inkling 2 Mini 单轮成本仅 $0.011,约为 Grok 4.3($0.09)的八分之一。
五、局限与待观察问题
- 环路计算的延迟代价:虽然省下了显存,但每个 Token 经过中间层三次意味计算量(FLOPs)并未按 3.4B 等比例缩小,在算力受限而非带宽受限的旧显卡上,首字延迟(TTFT)与吞吐优势会打折扣。
- 部分榜单仍属估算证据:目前 BenchLM 上的综合排名(#69)尚包含部分“Estimated(估算)”指标,在大规模迁移生产工作流前,建议用自身业务仓库做一次端到端回归测试(参考 [内链:轻量级开源模型生产评估清单])。
(注:模型价格、开源协议及端侧性能数据均基于 2026 年 11 月 21 日公开资料,后续变动以官方最新公布为准。)
常见问题
Q1:Inkling 2 Mini 对本地电脑的显存或内存有什么要求?
A:官方发布的 NVFP4/MXFP8 量化版本体积约 20GB,因此拥有 24GB 显存的消费级显卡,或 32GB 及以上统一内存的 MacBook Pro / 边缘计算盒均可流畅加载运行。
Q2:Inkling 2 Mini 可以免费用于商业项目吗?
A:可以。Thinking Machines Lab 采用 Apache-2.0 开源协议发布其模型权重,允许商业修改与部署,具体条款以官方仓库协议文件为准。
Q3:什么是 Looped Transformer(环路架构),它有什么优缺点?
A:环路架构让同一个中间网络层在推理时重复计算多次(Inkling 2 Mini 为 3 次)。优点是大幅减少权重存储占用、提高参数效率;缺点是单 Token 计算密度增加,对低算力芯片的速度有一定考验。
Q4:Inkling 2 Mini 在 1M 上下文下推理质量稳定吗?
A:在公开长文本测试 MRCR v2(256K–512K 区间)中其得分为 46.4%,LongBench v2 为 66.9%。长上下文表现良好,但超长代码库仍建议配合合理的上下文压缩策略。
参考来源
转载请注明出处:界智通 · https://www.jieagi.com/aizixun/824.html

关注 AI 前沿动态,分享模型、工具与实战教程。
暂无评论