
 界智通
GPT-6.1 Sol Ultrafast 是什么?API 调用、速度、价格、Codex 与适用场景全面解析
 jieagi_Pan
OpenAI 的模型竞争正在进入一个新的阶段。
过去大家最关注的是:
模型谁更聪明?
现在越来越多真实业务开始关注另一个问题:
模型到底能不能足够快?
尤其是在 AI Coding、Computer Use、实时 Agent、企业自动化等场景里,一个模型即使推理能力很强,如果每次输出都需要等待几十秒,整体使用体验仍然会受到明显影响。
2026 年 10 月 8 日,OpenAI 正式在 API 中为 GPT-6.1 Sol 增加了 Ultrafast 模式。
开发者现在可以直接通过:
{
  "model": "gpt-6.1-sol",
  "service_tier": "ultrafast"
}
调用这一高速服务等级。
OpenAI 官方确认,GPT-6.1 Sol Ultrafast 已经进入 GA,可供所有 API 用户使用,但仍然受到各自 API Rate Limit 限制。
一、GPT-6.1 Sol 是什么?
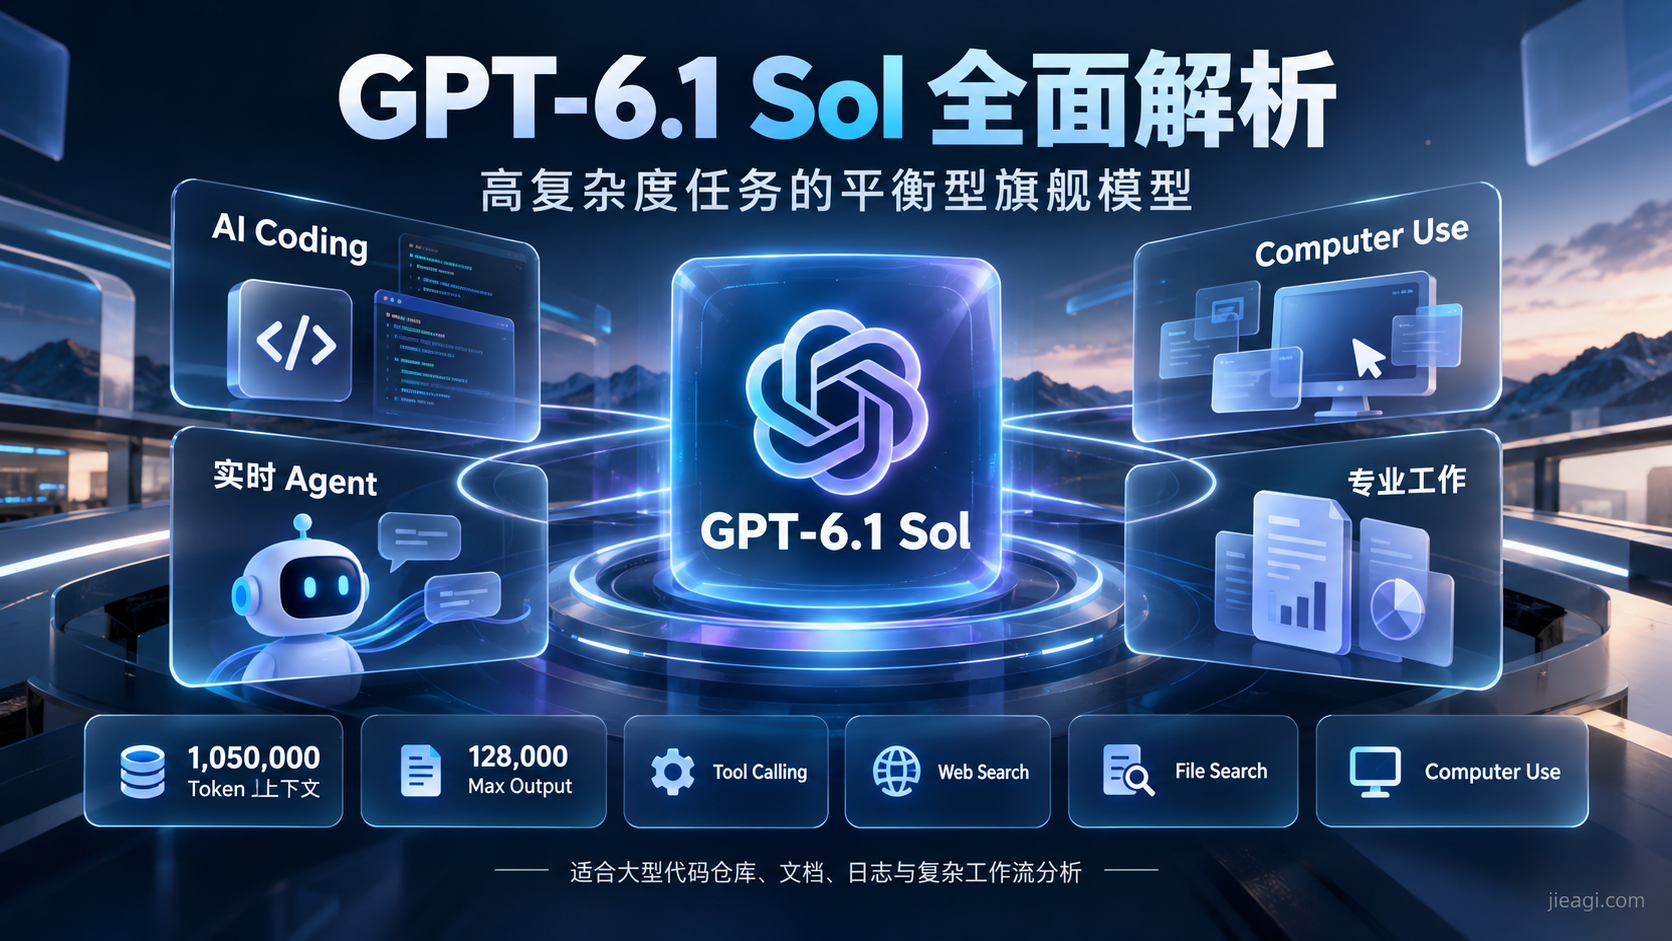
GPT-6.1 Sol 是 OpenAI 在 GPT-6 系列中面向高复杂度任务推出的模型。
OpenAI 对它的官方定位非常明确:
在复杂 Coding、Computer Use 和专业工作中提供接近 GPT-6 Astra 的表现,同时保持更低成本。
它并不是专门追求最低价格的小模型,而更像是:
能力、速度和成本之间的平衡型旗舰模型。
GPT-6.1 Sol 支持:
- 复杂代码任务;
- Computer Use;
- 专业知识工作;
- Tool Calling;
- Web Search;
- File Search;
- Computer Use 工具;
- 多档 Reasoning Effort;
- 超长上下文。
官方模型页显示,它拥有 1,050,000 Token 上下文窗口,最大输出可达到 128,000 Token。
这意味着它非常适合:
大型代码仓库
+
大量项目文档
+
日志
+
数据库结构
+
历史 Issue
+
测试代码
一起交给模型分析。
二、Ultrafast 模式到底是什么?
Ultrafast 并不是一个新的模型名称。
它本质上是:
GPT-6.1 Sol 的一种更高速服务等级。
可以把它理解成:
同一个模型
        ↓
Standard
Fast
Ultrafast
它们主要区别在:
请求被分配到什么级别的推理基础设施,以及响应速度和价格。
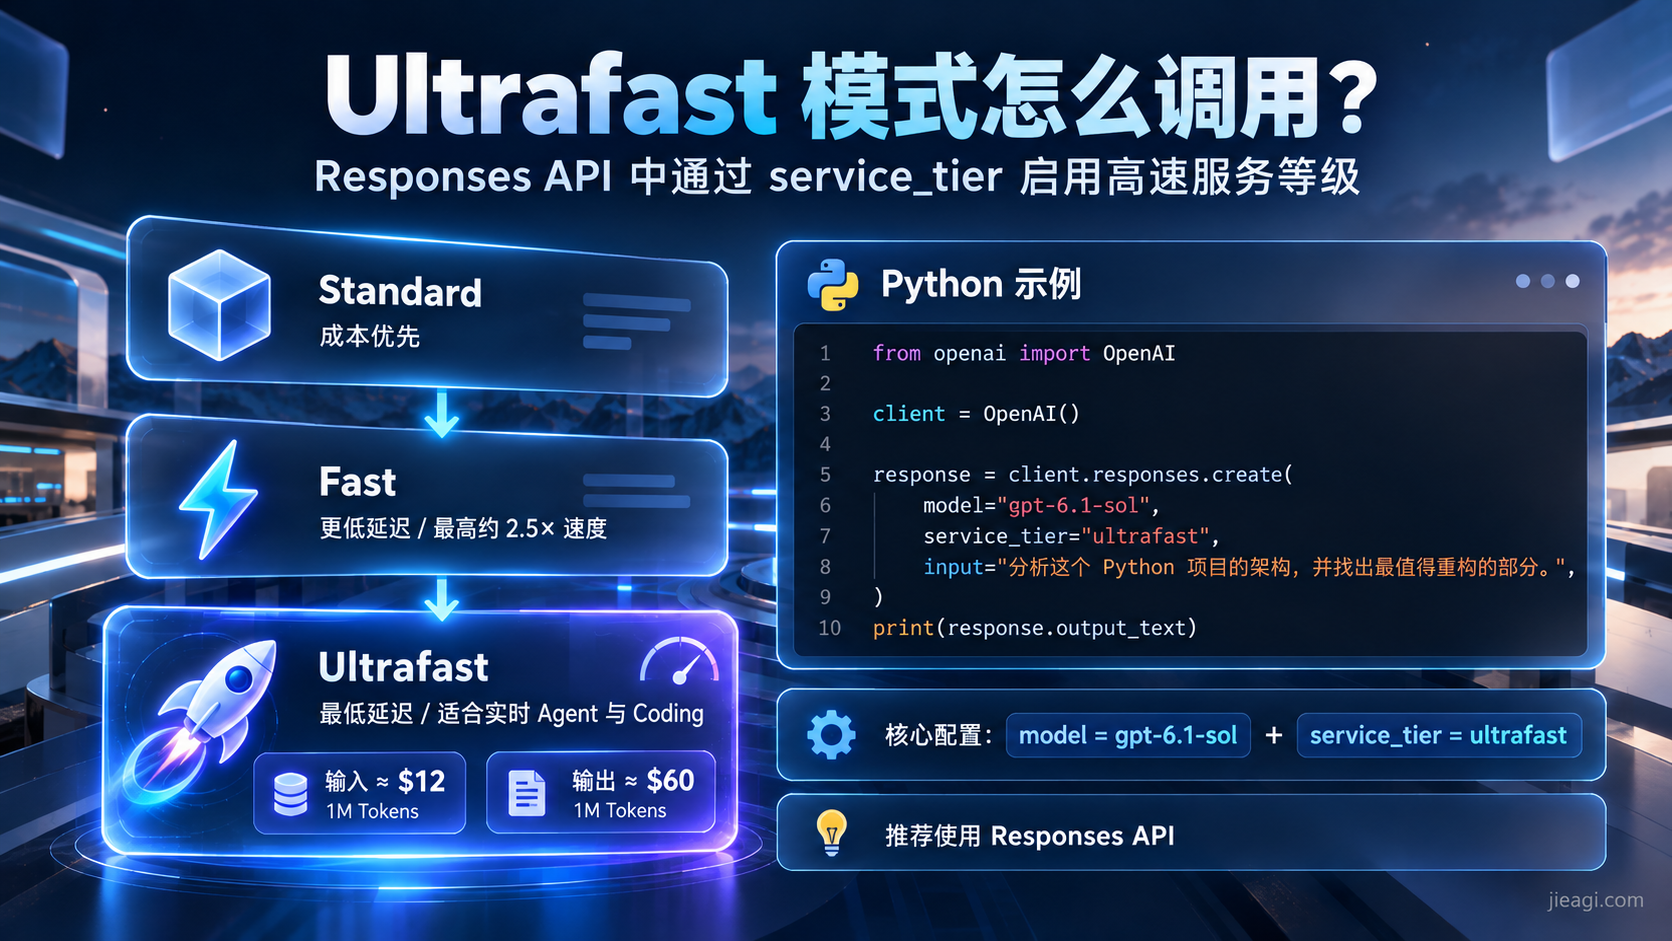
Standard 更适合成本优先。
Fast 更适合对延迟敏感的常规产品。
Ultrafast 则进一步强调:
尽可能降低 Token 之间的生成延迟。
OpenAI 官方说明,使用 Ultrafast 时,开发者仍然调用:
gpt-6.1-sol模型本身并没有改变。
只是增加:
"service_tier": "ultrafast"即可。
三、GPT-6.1 Sol Ultrafast 怎么调用?
目前最推荐使用:
Responses API。
这是因为 GPT-6.1 Sol 的 Tool Calling 主要围绕 Responses API 提供。
最基础的调用结构如下:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.1-sol",
    service_tier="ultrafast",
    input="分析这个 Python 项目的架构,并找出最值得重构的部分。",
)

print(response.output_text)
核心就是:
service_tier="ultrafast"如果使用 JSON 请求,大致相当于:
{
  "model": "gpt-6.1-sol",
  "service_tier": "ultrafast",
  "input": "帮我分析这个项目中的性能瓶颈"
}
这也是目前 GPT-6.1 Sol Ultrafast 最关键的配置。
四、Standard、Fast、Ultrafast 有什么区别?
可以简单理解为:
| 模式 | 适合场景 | 特点 |
|---|---|---|
| Standard | 后台任务、批处理 | 成本最低 |
| Fast | 普通实时应用 | 更低延迟 |
| Ultrafast | Coding、实时 Agent、Computer Use | 追求最高速度 |
OpenAI 当前说明:
Fast 模式最高可以达到 Standard 大约 2.5 倍的速度。
Ultrafast 则是更进一步的低延迟服务等级。
这意味着一个典型应用可以这样设计:
后台总结
→ Standard

在线聊天
→ Fast

Coding Agent
→ Ultrafast
这样可以在成本和体验之间取得更合理的平衡。
五、Ultrafast 价格是多少?
这是开发者最关心的问题之一。
GPT-6.1 Sol Standard 当前的短上下文基础价格是:
输入:
$2 / 1M Tokens

缓存输入:
$0.10 / 1M Tokens

Cache Write:
$2.50 / 1M Tokens

输出:
$10 / 1M Tokens
官方明确说明:
GPT-6.1 Sol Ultrafast 的价格为 Standard 的 6 倍。
因此按照当前价格计算,短上下文情况下大致相当于:
Ultrafast 输入
≈ $12 / 1M Tokens

Ultrafast 输出
≈ $60 / 1M Tokens
这与 OpenAI 官方模型页给出的 6× Standard 规则一致。
所以 Ultrafast 并不是“免费提速”。
而是:
用更高 API 成本换更低延迟。
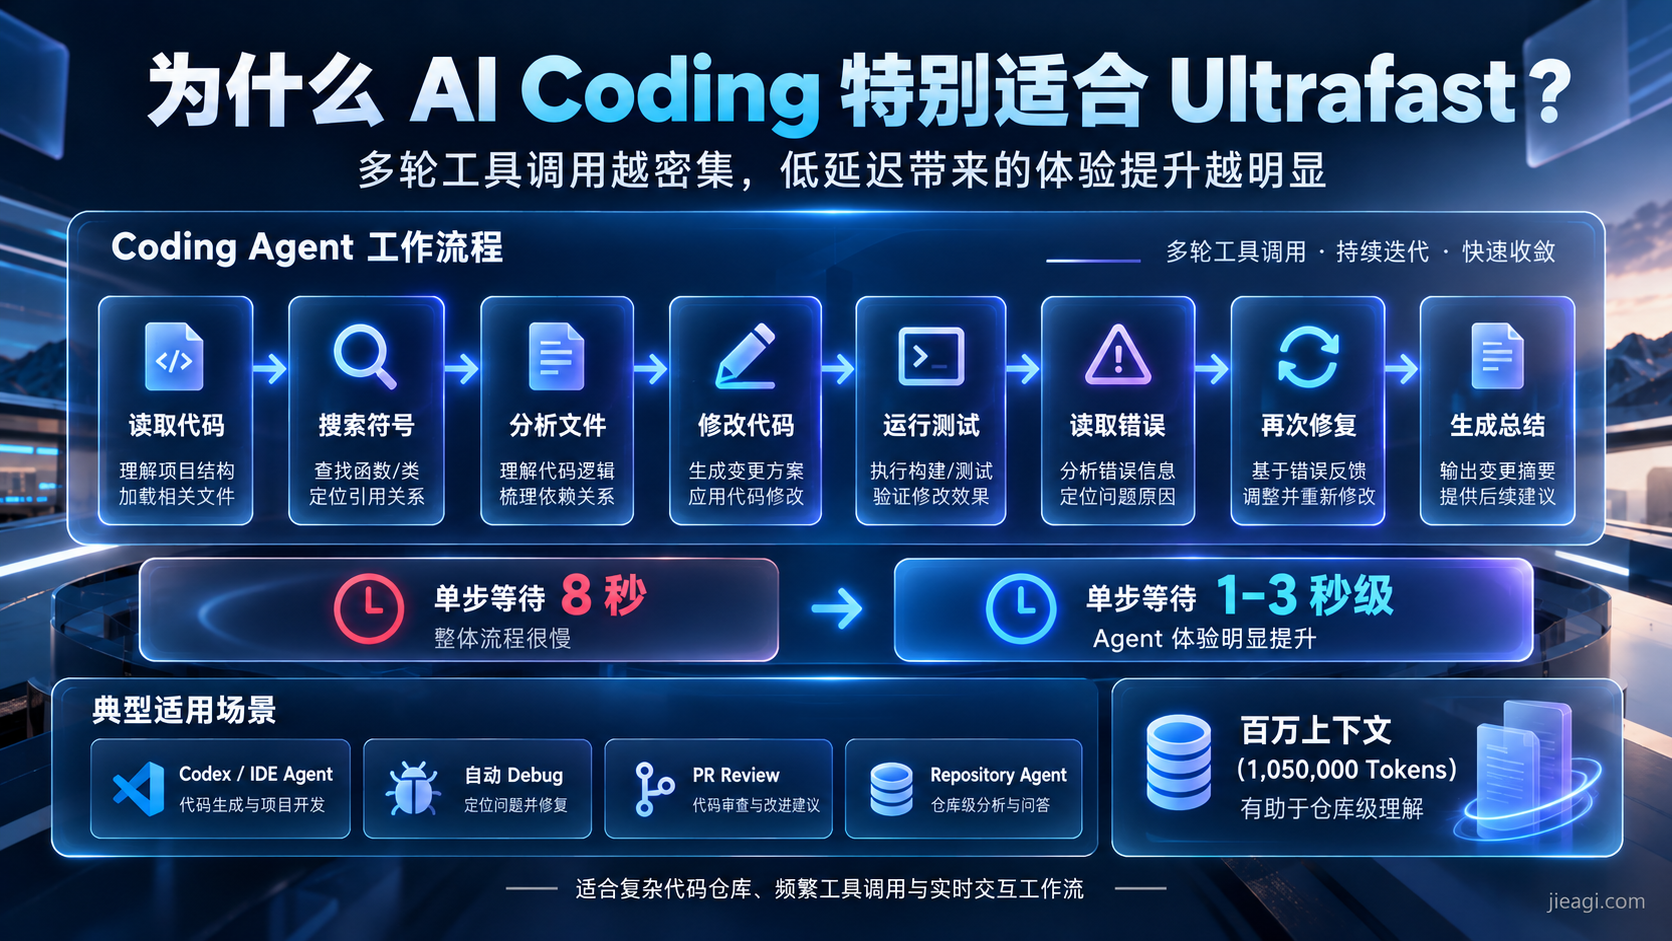
六、为什么 AI Coding 特别适合 Ultrafast?
AI Coding 有一个和普通聊天完全不同的特点:
交互次数特别多。
例如一次完整 Agent Coding 流程可能是:
读取代码
↓
分析文件
↓
搜索符号
↓
调用工具
↓
修改代码
↓
运行测试
↓
读取错误
↓
再次修改
↓
运行测试
↓
生成总结
一个任务可能触发几十次模型调用。
如果每一步等待:
8 秒整个流程就会非常慢。
但如果平均降低到:
1~3 秒级响应整个 Coding Agent 的体验会产生明显变化。
因此对于:
- Codex;
- IDE Agent;
- 自动 Debug;
- 自动测试;
- PR Review;
- Repository Agent;
这类场景来说,速度本身就是生产力。
七、Computer Use 为什么也需要高速模型?
Computer Use 与普通文本生成相比更加依赖实时交互。
例如:
读取屏幕
↓
判断按钮位置
↓
点击
↓
等待界面变化
↓
读取新界面
↓
再次判断
↓
输入内容
如果每一步都需要等待十几秒:
用户就会感觉:
AI 操作电脑非常迟钝。
而高速服务等级可以明显改善:
观察
→ 推理
→ 操作
→ 再观察
之间的循环速度。
这也是为什么 GPT-6.1 Sol 的官方定位中明确包含:
Computer Use。
八、Reasoning Effort 还能调吗?
可以。
GPT-6.1 Sol 支持:
low
medium
high
xhigh
max
多个 Reasoning Effort 等级。
因此可以组合:
Ultrafast
+
low reasoning
追求极低延迟。
也可以:
Ultrafast
+
high reasoning
在保留较高推理深度的情况下尽量提高响应速度。
例如:
response = client.responses.create(
    model="gpt-6.1-sol",
    service_tier="ultrafast",
    reasoning={
        "effort": "high"
    },
    input="分析这个复杂微服务架构的瓶颈,并给出重构方案"
)
这给开发者提供了非常多的组合空间。
九、GPT-6.1 Sol 的百万上下文有什么价值?
GPT-6.1 Sol 拥有:
1,050,000 Token Context Window。
这对 Coding 场景非常重要。
过去 AI 编程经常遇到:
文件太多
↓
上下文放不下
↓
必须截断
↓
AI 不知道项目全貌
而百万级上下文意味着:
模型有机会同时看到更多:
Source Code
README
API 文档
数据库 Schema
Issue
日志
测试
部署配置
于是 AI 可以从:
局部代码补全
逐渐升级到:
Repository Level Reasoning。
这也是未来 Coding Agent 的重要方向。
十、长上下文需要注意价格变化
这里有一个非常容易忽略的问题。
GPT-6.1 Sol 如果输入超过:
272K Tokens
官方会按照长上下文规则计费。
此时整次请求的:
Input
Cache
Output
费率都会进一步调整。
OpenAI 当前说明:
超过 272K 输入后:
- Input / Cache Rates 会增加;
- Output 价格也会提高。
因此不要因为模型支持百万上下文,就直接:
把整个仓库全部塞进去。更加合理的方法还是:
文件索引
+
搜索
+
上下文筛选
+
按需加载
也就是:
RAG + Repository Search + Long Context
一起使用。
十一、Ultrafast 支持哪些数据区域?
GPT-6.1 Sol Ultrafast 目前支持:
- Global Processing;
- US Data Residency;
- EU Data Residency。
这是 GPT-6.1 Sol 一个非常值得企业用户注意的优势。
OpenAI 官方明确表示:
GPT-6.1 Sol 在 Fast 和 Ultrafast 模式下也支持 US / EU Data Residency。
对于:
欧洲企业
金融
法律
企业数据
SaaS
这种存在数据驻留要求的业务尤其重要。
十二、Ultrafast Rate Limit 怎么算?
OpenAI 对 Ultrafast 采用独立 TPM 限制。
GPT-6.1 Sol 当前默认 Ultrafast Rate Limits 为:
Build
1,000,000 TPM

Launch
4,000,000 TPM

Grow
40,000,000 TPM
不同 API Usage Tier 对应不同额度。
因此对于大型 API 平台或者高并发业务来说,需要特别关注:
TPM
RPM
Concurrency
而不能只关注模型价格。
十三、什么时候应该使用 Ultrafast?
最适合:
1. AI Coding
例如:
Codex 类 Agent
IDE Agent
代码重构
自动 Debug
2. Computer Use
需要频繁:
观察
点击
输入
判断
的任务。
3. 实时企业 Agent
例如:
客服
内部工作助手
业务审批
数据分析
4. 低延迟 API 产品
例如:
聊天产品
搜索助手
智能 IDE
实时 Copilot
5. 高价值专业任务
如果:
用户每等待 1 秒
都有明显业务成本
那么更高的 Token 成本可能是值得的。
十四、什么时候不建议 Ultrafast?
如果任务属于:
夜间批处理
文章批量生成
Embedding
离线总结
数据清洗
后台分类
一般没必要使用 Ultrafast。
因为:
速度快,但价格明显更高。
这类任务优先使用:
Standard甚至:
Batch通常更加经济。
十五、GPT-6.1 Sol Ultrafast 对 API 平台意味着什么?
对 AI API 聚合平台来说,它实际上提供了新的产品分层机会。
例如:
普通线路
GPT-6.1 Sol Standard

高速线路
GPT-6.1 Sol Fast

极速线路
GPT-6.1 Sol Ultrafast
用户可以自己选择:
便宜
还是
速度
未来 AI API 的竞争,可能越来越像云计算:
同一个模型
不同服务等级
不同 SLA
不同价格
而不再只是:
这个平台有没有某个模型。
十六、总结
GPT-6.1 Sol Ultrafast 的意义,并不是 OpenAI 又发布了一个模型。
真正变化的是:
推理速度正在成为独立商品。
以前我们选择模型主要比较:
能力
价格
上下文
现在还必须增加:
延迟未来一个成熟 AI 系统很可能采用:
简单任务
→ Luna

普通复杂任务
→ Sol Standard

用户交互任务
→ Sol Fast

实时 Agent / Coding
→ Sol Ultrafast

最高难度任务
→ Astra
这种动态路由方式。
对于开发者而言,GPT-6.1 Sol Ultrafast 最值得关注的并不是“跑分更高”,而是它能否让:
Coding Agent、Computer Use 和实时 AI 产品真正变得足够快。
目前 GPT-6.1 Sol Ultrafast 已正式进入 OpenAI API GA,可以通过 Responses API 使用 service_tier: "ultrafast" 调用。
版权信息: 本文由界智通(jieagi)团队编写,图片、文本保留所有权利。未经授权,不得转载或用于商业用途。
转载请注明出处: 界智通
本文的链接地址: https://www.jieagi.com/aizixun/134.html
-

GPT-5-Codex保姆级教程:获取OpenAI APIKey与安装 Codex CLI使用教程全面指南
2025/09/17
-
2025最新:Claude Pro 与 Max 区别详解与订阅指南
2025/08/26
-
Gemini 报错 "Something went wrong" 终极解决指南
2025/11/27
-
Cursor权威指南:从注册入门到精通AI驱动编程工作流(含国内注册与验证说明)
2025/08/27
-
2025最新保姆级教程:如何获取Claude API Key?从注册到Python调用,一篇搞定!
还在为如何申请 Claude API Key 而头秃吗?随着 Claude 4.5 Sonnet 在编程能力上的强势崛起,越来越多的开发者开始转向 Anthropic 的阵营。本文将通过“保姆级”的图文实操,带你一步步解决账号注册、手机号验证、API Key 获取及额度充值等难题,并附带 Python 极简调用示例。无论你是想接入 LangChain 还是自己在这个强大的模型上跑 Demo,这篇文章都能帮你避开 99% 的坑!
2025/11/15
-
【实测有效】Gemini 3 / Google Antigravity 授权登录无反应、无权限?全平台解决办法汇总指南
2025/11/22
-
WorkBuddy 高阶进阶全解:获取OpenAI Key自定义 API + SKILL.md 封装,效率直接翻倍
2026/04/19
-
[2025最新] ChatGPT Plus 订阅终极指南:四种充值方案与深度解析:为什么它值$20?
2025/11/13
-
Google AI Pro 有什么功能?Google AI Pro 生态系统深度报告以及订阅会员权益功能全面分析
2025/11/29
-
Grok-4.1 深度拆解:马斯克的“叛逆”AI怎么接入?xAI Grok API Key 获取及开发攻略
想要体验马斯克旗下xAI的Grok大模型?本文详细拆解 Grok API Key 获取的全流程,从账号登录、控制台设置到API Key生成,并附带完整的Python调用代码示例。解决开发者在申请过程中遇到的支付、权限等常见问题,助你快速将“叛逆”的Grok集成到自己的应用中。
2025/11/18


暂无评论
太好看了,快点更新!
国内开发者玩转Claude:最新Claude 4模型解析与API Key获取攻略
这是系统生成的演示评论
国内开发者玩转Claude:最新Claude 4模型解析与API Key获取攻略