 界智通
NVIDIA DGX Spark 八节点完整解析:1TB 内存、GLM 5.3 753B、Qwen 3.8 推理、RoCEnante 与模型路由
 jieagi_Pan
一、八台 DGX Spark 可以运行多大的 AI 模型?
2026 年 10 月 22 日,NVIDIA 发布了 DGX Spark 八节点集群的详细技术文章。
根据官方介绍,开发者现在可以将多台 DGX Spark 连接为一个本地 AI 计算集群。
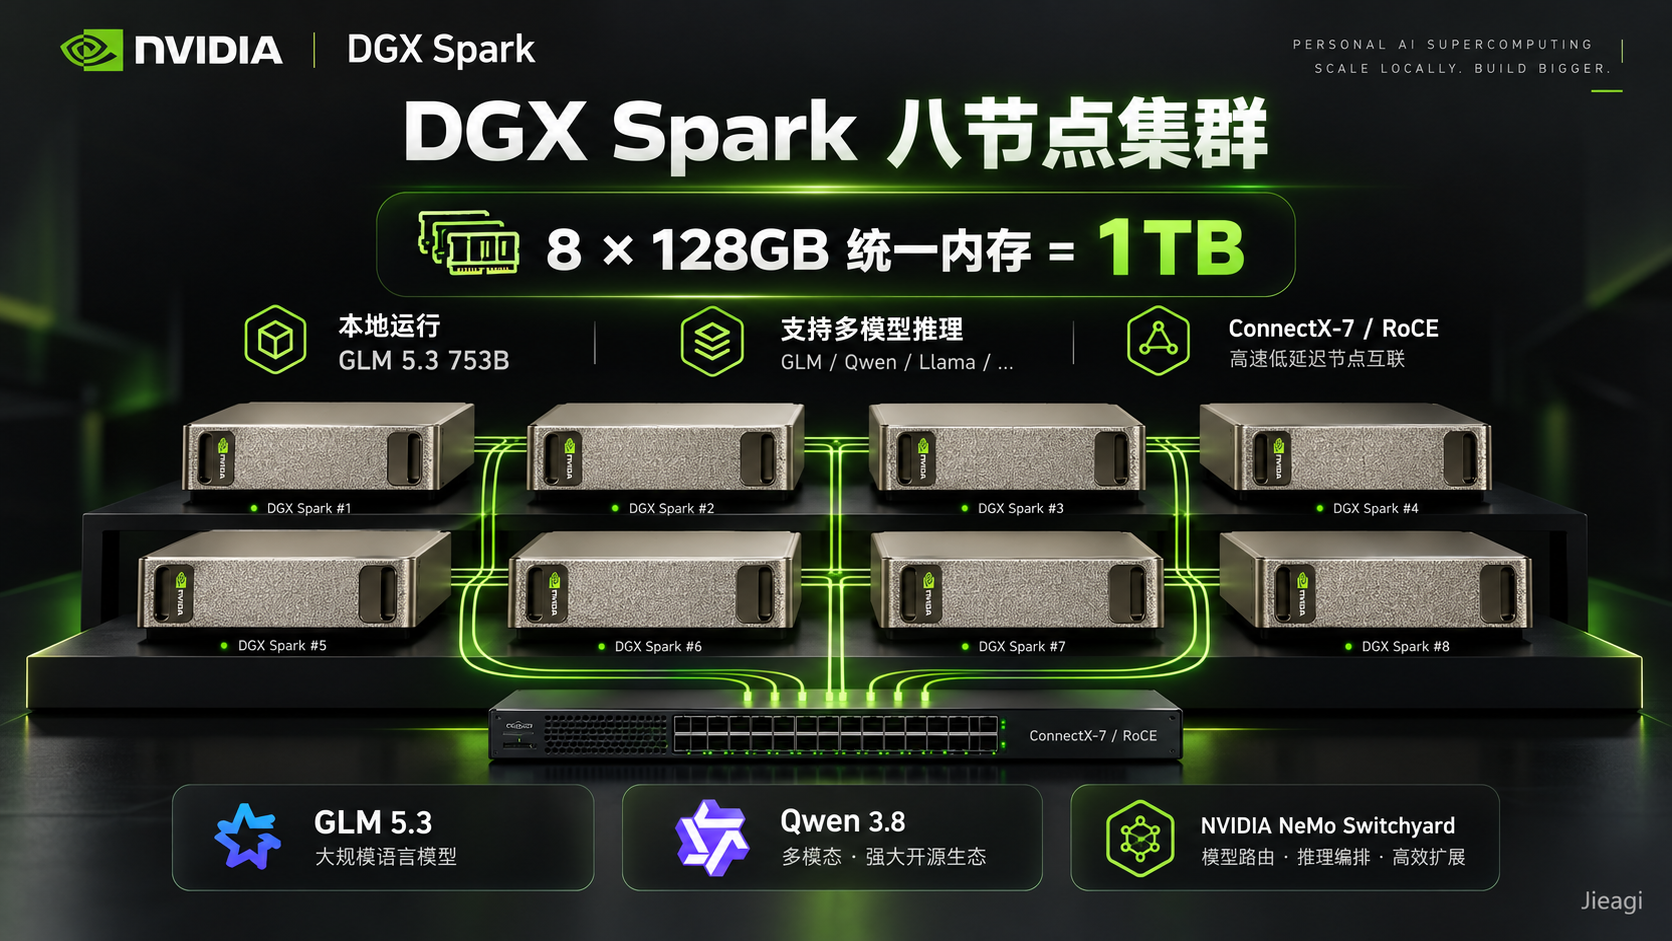
每台 DGX Spark 配备 128GB 统一内存。
八台设备合计达到 1TB 统一内存容量。
NVIDIA 展示了在该平台运行完整 GLM 5.3 753B 模型的案例,同时公布了 Qwen、模型路由和分布式训练的性能数据。
这代表个人和小型研究团队能够探索更大规模的本地模型工作流。
但需要明确,八台设备的统一内存并不是一块天然共享、可以被单个进程无条件使用的 1TB 内存。
数据实际分布在不同节点中,需要通过分布式推理和节点间通信机制协同运行。
因此,拥有足够总内存只是大型模型能够加载的前提之一。
真正的执行速度还受到网络拓扑、通信带宽、模型量化和推理框架影响。
二、DGX Spark 的定位是什么?
DGX Spark 是 NVIDIA 面向本地 AI 开发的计算平台。
它强调在相对紧凑的设备上提供 GPU 计算和统一内存能力。
对于开发者来说,传统高参数模型往往需要较大的服务器显存或云端 GPU 集群。
DGX Spark 的目标,是降低在本地研究、调试和部署部分 AI 模型的门槛。
但它并不是一台普通办公电脑的完全替代品。
大型 AI 推理仍需要额外配置软件、模型文件、网络和运行环境。
尤其是在多节点情况下,使用方式已经接近小型计算集群。
因此,购买多个节点之前,应明确自己希望解决的问题:
是为了容纳更大的模型?
是为了同时运行多个 Agent?
还是希望提高模型并发吞吐?
不同目标对应不同的集群架构。
三、为什么 1TB 内存具有意义?
大型模型的权重需要消耗大量存储和运行内存。
例如,753B 模型意味着拥有约 7530 亿参数。
如果采用较高精度保存,权重本身就可能需要巨大的空间。
量化能够降低部分权重占用。
NVIDIA 官方展示的 GLM 5.3 NVFP4 权重约为 470GB。
这已经超过少量 DGX Spark 节点能够轻松容纳的范围。
八节点集群提供约 1TB 总统一内存,因此有机会加载完整量化模型,并保留一部分空间用于运行时状态。
但还需要考虑 KV Cache、框架缓冲、通信内存及其他服务进程。
不能简单认为只要模型文件小于 1TB,就一定能够达到理想推理速度。
四、GLM 5.3 753B 的官方性能如何?
NVIDIA 公布了完整 GLM 5.3 模型在八节点配置中的推理结果。
使用 NVFP4 权重,并在指定输入长度与 MTP3 配置下,官方列出以下数据:
| 并发请求数 | 总 Decode TPS | 单用户 Decode TPS |
|---|---|---|
| 1 | 31 | 31 |
| 4 | 51 | 21 |
| 8 | 67 | 18 |
这组数据说明,并发增加时,整体系统吞吐量可能提升。
但每位用户实际获得的生成速度可能下降。
例如,八个请求同时运行时,模型需要在不同会话之间共享计算资源。
因此,单用户速度与整机总吞吐量不是同一个指标。
不能把总 Decode TPS 直接理解为每个用户都能获得的速度。
同时,这些数字来自 NVIDIA 的指定实验,不是普通用户购买设备后无条件能够复现的结果。
五、为什么节点越多,推理不一定同比例加速?
分布式推理需要在不同节点之间交换数据。
例如,张量并行会将同一模型的部分计算分散到多个设备。
每轮计算不仅涉及本地矩阵运算,还涉及不同节点之间的通信。
如果通信延迟较大,GPU 可能在等待数据时无法充分利用计算能力。
因此,多节点扩展效率受到网络和集合通信算法影响。
八台设备拥有八倍的节点数量,并不意味着单请求生成速度一定变成八倍。
模型大小、运行并发和拓扑结构都会改变最终结果。
尤其是大型模型,每个 Token 的生成可能包含多个需要同步的阶段。
这也是 NVIDIA 在本次技术文章中重点讨论 RoCEnante 的原因。
六、RoCEnante 是什么?
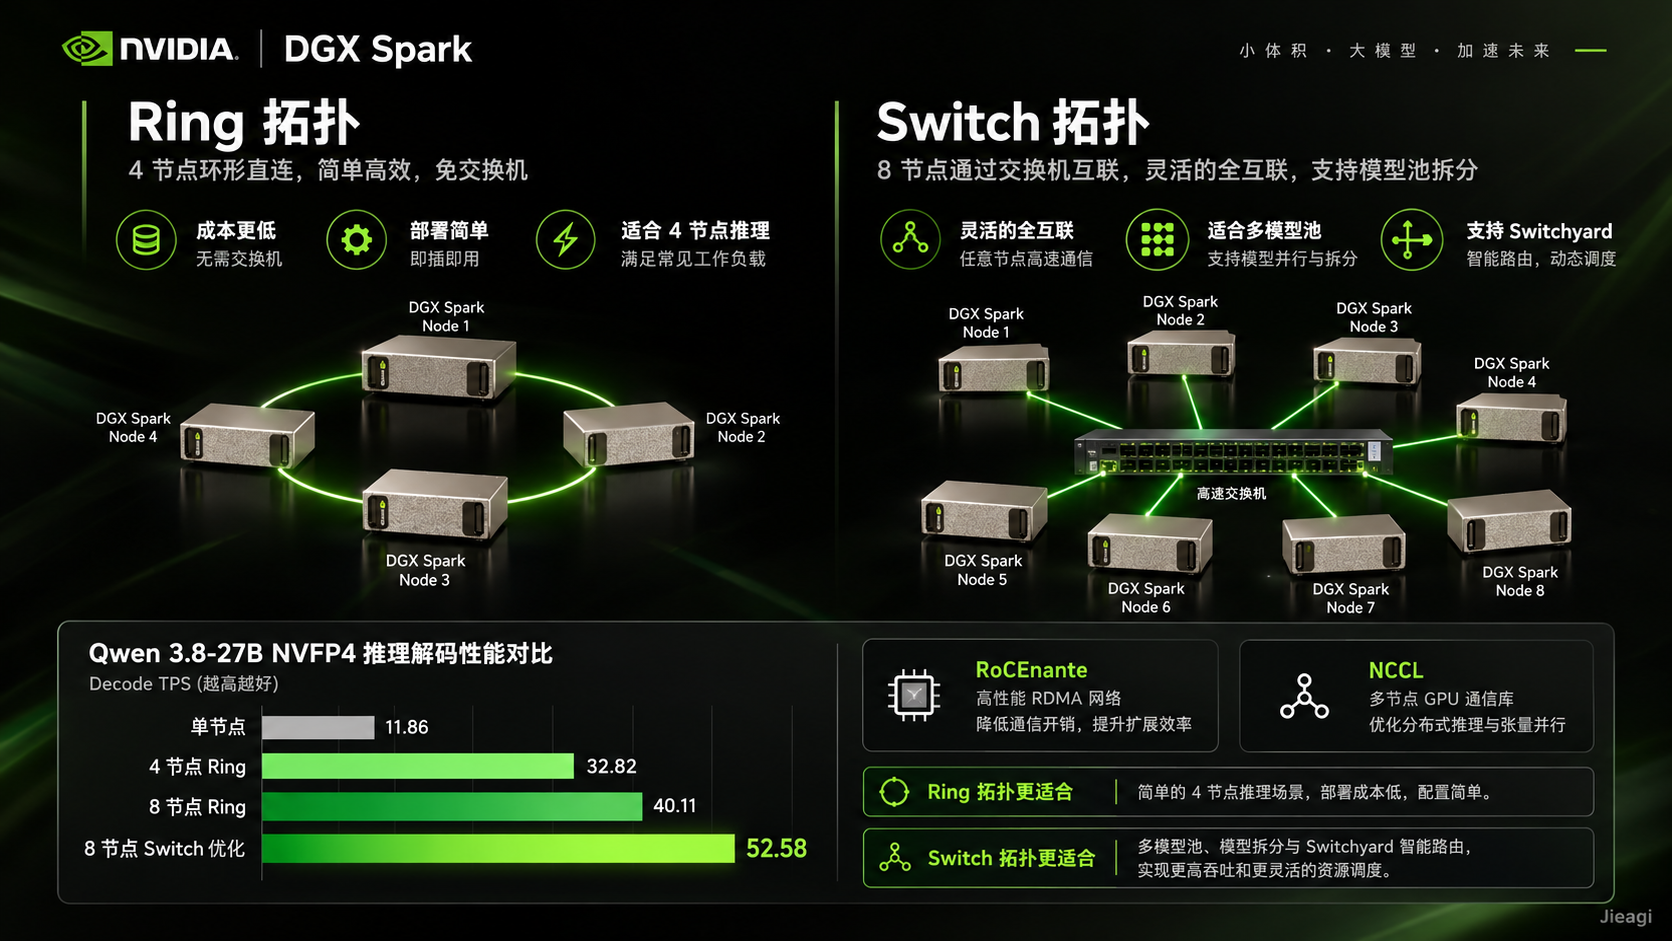
RoCEnante 是 NVIDIA 为 DGX Spark 本地集群探索的优化集合通信后端。
其目标是降低张量并行中的通信延迟。
在传统 Ring All-Reduce 中,部分数据需要沿节点构成的环逐步传递和归约。
对于节点数量有限、消息较小的场景,环状传递可能引入额外等待。
RoCEnante 则采用更直接的多节点数据交换方式。
节点向其他参与者发送需要的数据,再在本地完成归约。
这种方式能够减少某些通信阶段,但也可能增加总体数据传输量。
因此,它不是在任何集群规模下都优于 NCCL Ring。
当消息较大、并发较高或拓扑变化时,其他算法可能更合适。
七、Qwen 3.8-27B 的扩展结果如何?
NVIDIA 使用 Qwen 3.8-27B NVFP4 进行了多节点性能评估。
主要 Decode 数据如下:
| 节点与拓扑 | 官方 Decode TPS |
|---|---|
| 单节点 | 11.86 |
| 双节点直连 | 21.71 |
| 四节点 Ring | 32.82 |
| 四节点 Switch 优化 | 36.34 |
| 八节点 Ring | 40.11 |
| 八节点 Switch 优化 | 52.58 |
在这一实验中,八节点 Switch 配合优化后端,相对单节点获得了约 4.43 倍的 Decode 吞吐。
这一结果具有技术参考价值。
但它不表示所有 Qwen 模型、全部上下文长度和任何并发配置都能得到同样加速。
本次测量采用特定输入长度、输出长度和实验工具。
实际用户应根据自己的负载重新测试。
八、Ring 与 Switch 应该怎么选?
Ring 是一种将节点依次连接成环的网络拓扑。
对于数量较少、以单一模型张量并行为主要任务的集群,它可以减少额外网络设备投入。
NVIDIA 指出,四节点 Ring 在其测试场景中表现良好。
但当开发者希望将八个节点分成多个独立模型池时,就需要更加灵活的节点间通信。
例如,四个节点运行一个较大模型,另外四个节点运行多个轻量模型。
这样的架构可能更适合使用 Switch 网络。
对于需要任意节点之间直接通信的工作负载,Switch 也更加灵活。
因此,拓扑选择取决于未来的工作负载,而不仅取决于当前最便宜的连接方式。
九、NeMo Switchyard 解决什么问题?
NVIDIA 在技术文章中还展示了 NeMo Switchyard。
这是用于多模型推理路由的组件。
其基本思路是,根据请求复杂程度选择适当的模型池。
简单任务可以交给速度较快、成本较低的小模型。
复杂任务则交给更强的模型。
在官方案例中,研究团队使用 MiniCPM5 2B 处理简单任务,并将 Qwen 3.8 Flash Next 用于复杂任务。
模型路由并不直接增加某一模型的参数能力。
它利用任务分工提高整体资源使用效率。
例如,在实际业务中,大量请求可能只是信息分类和简短问答。
如果全部使用大模型,可能限制系统吞吐。
因此,模型路由可以成为提高集群有效容量的重要方法。
十、NeMo Switchyard 的吞吐提升是多少?
NVIDIA 公开了一个模型路由实验。
它将八节点集群分配给不同模型池,并根据任务类型进行选择。
在指定工具调用评测中,路由方案与全 Qwen 配置取得相同的测试得分。
当部分请求转向较小模型后,集群的总处理能力提高。
官方报告,在一半请求使用较大模型时,总吞吐约提升 1.5 倍。
当只有四分之一请求需要较大模型时,总吞吐可达到约三倍。
这说明路由收益高度依赖实际流量组成。
如果几乎所有请求都需要旗舰模型,小模型路由就难以产生同等收益。
同时,任务分类错误也可能降低结果质量。
因此,应结合生产业务的任务分布进行测试。
十一、八节点还能够进行模型训练吗?
可以,但训练与推理的扩展方式不同。
NVIDIA 使用 nanochat 模型开展了分布式预训练实验。
该模型约拥有 8.965 亿参数。
官方列出了以下扩展结果:
| 节点数量 | 训练 TPS | 相对单节点加速 |
|---|---|---|
| 1 | 8,741 | 1.00× |
| 2 | 17,202 | 1.97× |
| 4 | 33,640 | 3.85× |
| 8 | 68,079 | 7.79× |
八节点训练的扩展效率达到约 97.4%。
但这一结果来自参数规模相对较小的模型,以及特定的训练配置。
不能推断训练一个数千亿参数模型也会具有同样效率。
对于更大的模型,梯度同步、优化器状态和内存通信可能带来完全不同的瓶颈。
十二、NVIDIA Sync 八节点功能已经完全开放了吗?
这是本次公告最容易混淆的地方。
NVIDIA 已经公布并展示了八节点技术方案及相应实验。
但 NVIDIA Sync 的完整八节点集群管理支持,官方表示计划于 2026 年年底之前推出。
因此,不能把技术博客展示的八节点运行能力,直接写成所有用户在 NVIDIA Sync 中已经可以一键完成配置。
目前希望尝试多节点部署的开发者,应遵循官方网络配置和分布式推理教程。
对于希望依靠图形化工具简化集群管理的用户,还需要关注后续 NVIDIA Sync 更新。
十三、这是不是最便宜的 753B 模型部署方案?
不能直接这样判断。
八台 DGX Spark 的采购成本、网络设备、存储、供电、散热和维护都需要纳入预算。
此外,模型推理速度也可能与专业数据中心 GPU 集群不同。
对于请求量很低的开发者,云端 API 可能更具有经济性。
对于需要长期运行、管理敏感数据或进行本地模型研究的团队,八节点集群可能提供不同价值。
因此,应计算完整使用周期的成本。
包括硬件折旧、电力、人员维护以及升级费用。
不能只比较设备采购价与 API 每百万 Token 单价。
十四、本地部署与云端 API 如何选择?
可以围绕以下维度评估。
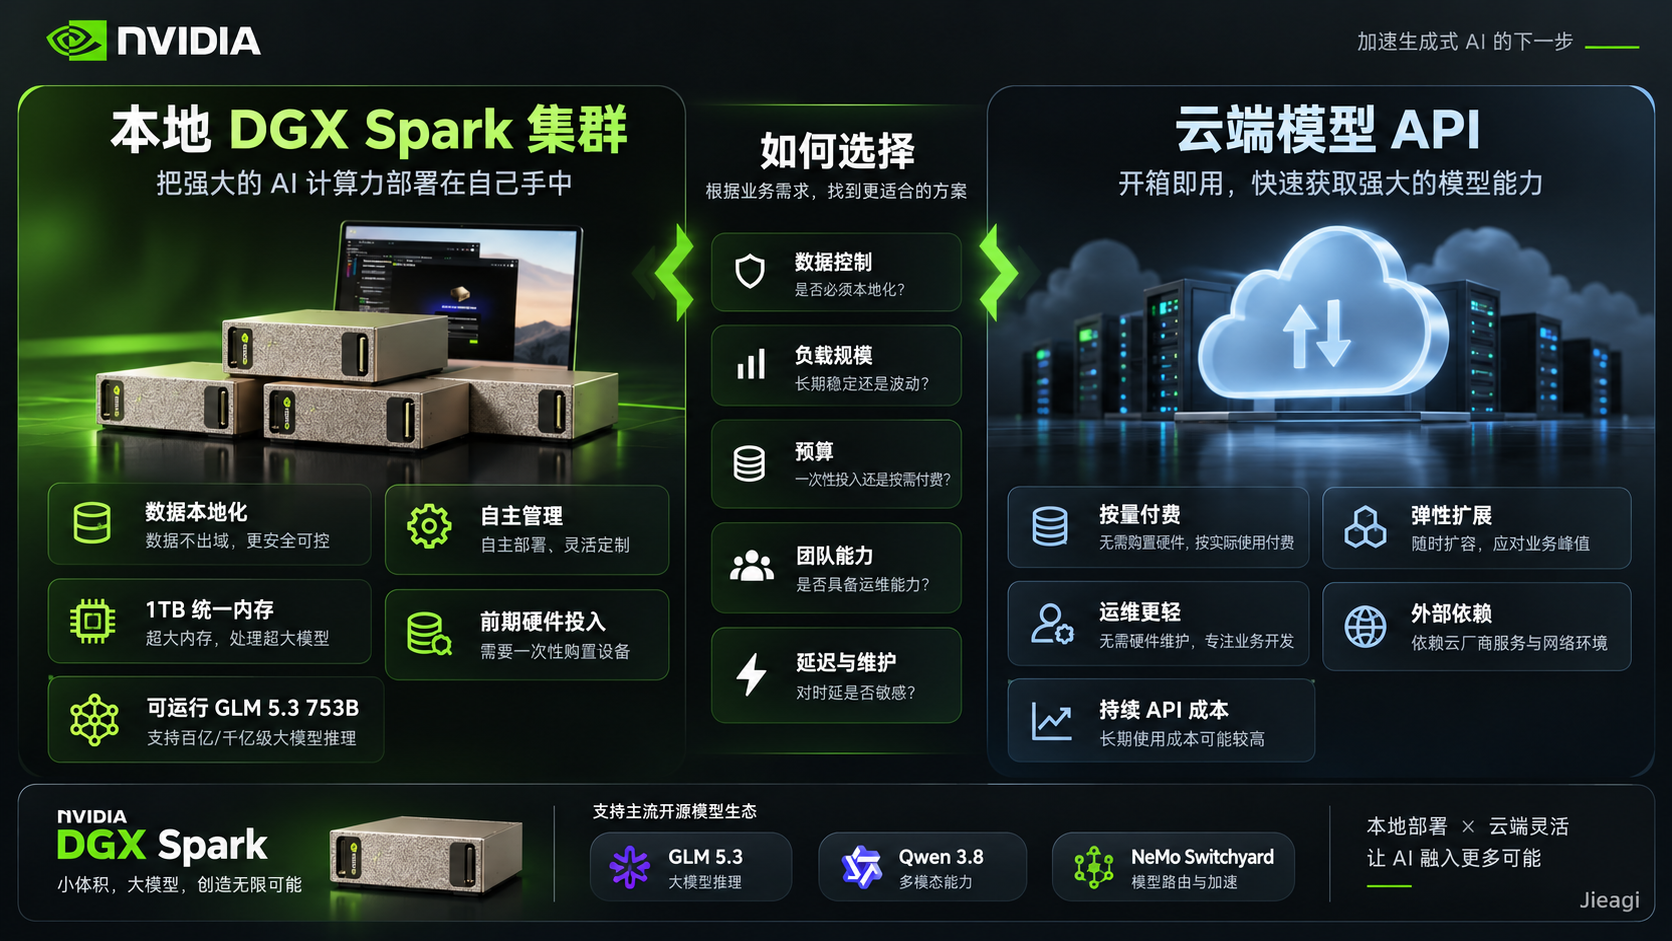
数据控制: 是否需要在本地处理敏感资料?
负载规模: 是否拥有长期稳定、较高的推理需求?
延迟: 用户和集群之间的网络是否可靠?
模型更新: 是否有足够能力维护权重与推理框架?
预算: 前期资本支出与持续 API 消费哪个更适合?
技术团队: 是否具备管理分布式计算和网络的能力?
对于多数只是偶尔使用旗舰模型的团队,云端 API 仍可能更方便。
对于研究机构和需要深入控制推理过程的开发者,本地集群则提供额外自主性。
十五、如何规划一个最小可行部署?
建议不要一开始直接采购八台设备。
首先,在单节点验证目标模型能否运行,以及实际内存占用和性能。
然后,评估双节点通信和工具链。
如果需要更大模型,再考虑四节点 Ring。
最后,根据模型池拆分和网络要求决定是否扩展到 Switch 互联的八节点。
每增加一层复杂度,都应记录实际性能和故障情况。
此外,生产系统应建立监控和备份机制。
因为多节点环境可能出现单个设备离线、网络异常或不同节点版本不一致的问题。
这些问题并不会因模型权重能够加载而自动解决。
十六、有哪些安全问题需要考虑?
本地部署减少了某些外部 API 数据传输,但也带来自己的安全责任。
例如,模型服务如果开放公网端口,就需要配置认证和访问限制。
如果多个团队共用集群,还需要隔离不同用户的数据和计算任务。
模型文件及容器镜像应从可信来源获取。
对于允许 Agent 执行代码的环境,需要使用独立沙箱,避免工具操作影响宿主机。
因此,本地模型与生产安全之间并不存在天然等号。
集群管理员仍然需要维护身份、网络、日志、备份和更新制度。
十七、常见问题 FAQ
八台 DGX Spark 总共拥有多少内存?
官方说明合计提供约 1TB 统一内存,每台为 128GB。
可以运行完整 GLM 5.3 753B 吗?
NVIDIA 已经展示了指定 NVFP4 权重和八节点配置下的运行结果。
1TB 是一块所有进程直接共享的内存吗?
不是,实际仍然需要分布式模型并行和节点通信。
Qwen 3.8-27B 在八节点上提升多少?
NVIDIA 指定 Switch 优化测试得到约 4.43 倍 Decode 吞吐提升,不是通用保证。
八节点 NVIDIA Sync 已经正式开放吗?
官方计划于年底前提供完整的八节点管理支持。
一定需要交换机吗?
不一定。四节点等部分场景可以采用 Ring;八节点模型池和特定通信任务更适合 Switch。
本地推理是否一定比云端便宜?
需要结合设备、负载、维护和电力等实际成本判断。
十八、结语
DGX Spark 八节点技术方案展示了本地 AI 计算的一种新可能。
通过集群化和模型量化,开发者能够在桌面级设备组合上探索超大规模模型。
但模型能够加载,不等于能够以理想速度、最低成本和生产级可靠性持续服务。
对于需要部署大模型的团队,真正值得研究的是统一内存、网络拓扑、通信算法和智能模型路由如何协同工作。
未来,本地 AI 集群可能会成为云端 API 之外的重要选择,但实际价值依然取决于明确的任务需求与完整的工程评估。
官方来源
1. NVIDIA — Running Frontier-Class AI Models Across 8 NVIDIA DGX Spark Nodes https://developer.nvidia.com/blog/running-frontier-class-ai-models-across-8-nvidia-dgx-spark-nodes/
2. NVIDIA DGX Spark 产品与开发资源 https://www.nvidia.com/en-us/products/workstations/dgx-spark/
3. NVIDIA 开发者教程 https://build.nvidia.com/
转载请注明出处: 界智通
本文的链接地址: https://www.jieagi.com/aizixun/190.html
-
GPT-5-Codex保姆级教程:获取OpenAI APIKey与安装 Codex CLI使用教程全面指南
2025/09/17
-
2025最新:Claude Pro 与 Max 区别详解与订阅指南
2025/08/26
-
Gemini 报错 "Something went wrong" 终极解决指南
2025/11/27
-
Cursor权威指南:从注册入门到精通AI驱动编程工作流(含国内注册与验证说明)
2025/08/27
-
【实测有效】Gemini 3 / Google Antigravity 授权登录无反应、无权限?全平台解决办法汇总指南
2025/11/22
-
2025最新保姆级教程:如何获取Claude API Key?从注册到Python调用,一篇搞定!
还在为如何申请 Claude API Key 而头秃吗?随着 Claude 4.5 Sonnet 在编程能力上的强势崛起,越来越多的开发者开始转向 Anthropic 的阵营。本文将通过“保姆级”的图文实操,带你一步步解决账号注册、手机号验证、API Key 获取及额度充值等难题,并附带 Python 极简调用示例。无论你是想接入 LangChain 还是自己在这个强大的模型上跑 Demo,这篇文章都能帮你避开 99% 的坑!
2025/11/15
-
WorkBuddy 高阶进阶全解:获取OpenAI Key自定义 API + SKILL.md 封装,效率直接翻倍
2026/04/19
-
[2025最新] ChatGPT Plus 订阅终极指南:四种充值方案与深度解析:为什么它值$20?
2025/11/13
-
Google AI Pro 有什么功能?Google AI Pro 生态系统深度报告以及订阅会员权益功能全面分析
2025/11/29
-
Grok-4.1 深度拆解:马斯克的“叛逆”AI怎么接入?xAI Grok API Key 获取及开发攻略
想要体验马斯克旗下xAI的Grok大模型?本文详细拆解 Grok API Key 获取的全流程,从账号登录、控制台设置到API Key生成,并附带完整的Python调用代码示例。解决开发者在申请过程中遇到的支付、权限等常见问题,助你快速将“叛逆”的Grok集成到自己的应用中。
2025/11/18

暂无评论
太好看了,快点更新!
国内开发者玩转Claude:最新Claude 4模型解析与API Key获取攻略
这是系统生成的演示评论
国内开发者玩转Claude:最新Claude 4模型解析与API Key获取攻略