 界智通
NVIDIA Nemotron 3.5 Bolt E4B 4GB 发布:4GB 级本地 AI Agent、64K 上下文与 Ollama 部署指南
 jieagi_Pan
一、NVIDIA 为什么发布 4GB 级 AI Agent 模型?
大语言模型的能力不断提升,但模型运行成本仍然是实际部署的重要障碍。
例如,在大型云端服务器运行旗舰模型,可以获得较强的复杂推理能力。
但本地机器人、游戏角色、汽车设备或智能家居应用,并不一定拥有同样的计算资源。
这些设备需要响应速度快、占用资源少,并能够与真实工具交互的模型。
2026 年 10 月 23 日,NVIDIA 正式发布 Nemotron 3.5 Bolt E4B 4GB。
它是一款面向低内存环境的开放小型语言模型。
官方把重点放在每 GB 内存能够提供多少实用 Agent 能力,而不是追求最大参数规模。
对于开发者来说,这意味着可以尝试在个人电脑、RTX 显卡或部分边缘设备上运行支持工具调用的对话模型。
但“4GB 模型”并不代表所有电脑只要剩余 4GB 内存就能保证顺畅运行。
实际需求取决于权重、运行框架和上下文配置。
二、Nemotron Bolt E4B 的核心参数
| 项目 | 官方信息 |
|---|---|
| 模型名称 | Nemotron 3.5 Bolt E4B 4GB |
| 基础模型 | Gemma 4 E4B |
| 总参数 | 8B |
| 有效参数 | 约 4B |
| 主要量化格式 | Q4_K_M |
| 上下文长度 | 最高 64K Token |
| 输入与输出 | 文本输入、文本输出 |
| 主要场景 | 本地助手、游戏 NPC、机器人接口 |
| 主要功能 | 多轮工具调用、可配置推理、会话模式 |
| 发布日期 | 2026 年 10 月 23 日 |
这里必须强调,虽然模型面向语音助手和机器人,但它本身是文本输入与文本输出模型。
如果希望实现完整语音交互,还需要语音识别和语音合成组件。
如果希望识别摄像头画面,也需要其他视觉模型提供相关信息。
不能仅根据“机器人助手”这一应用定位,把 Bolt E4B 宣传成原生实时音视频模型。
三、8B 总参数与 4B 有效参数是什么意思?
某些模型使用稀疏架构,不会在每次计算中激活所有参数。
因此,模型总参数量和参与某次计算的有效参数量可能不同。
Nemotron 3.5 Bolt E4B 的官方模型卡列出 8B 总参数、4B 有效参数。
这有助于理解为什么模型可以在保留一定能力的同时,控制推理开销。
但参数数量不能直接等同于显存消耗。
推理时还需要保存模型权重、KV Cache、运行时缓冲和其他状态。
此外,量化精度会明显影响权重占用。
因此,实际部署应使用官方模型卡和推理软件测量内存峰值,而不是只根据参数规模计算。
四、Q4_K_M 量化有什么作用?
Q4_K_M 是 llama.cpp 生态中常见的模型量化格式。
通过降低部分权重的表示精度,可以减少模型文件大小及运行内存。
这通常能够帮助更小的设备运行模型。
但量化可能带来一定准确性损失,具体影响依赖模型架构和任务类型。
例如,在普通聊天任务中,某种量化格式可能表现较稳定。
但在复杂推理或精确工具参数生成任务中,仍需检查是否出现额外错误。
因此,选择 Q4_K_M 的原因通常是内存和性能的工程折中,而不是它在所有情况下都优于 BF16。
NVIDIA 还提供对应的全精度版本,方便具有更多显存的用户评估。
五、4GB 显存到底能做什么?
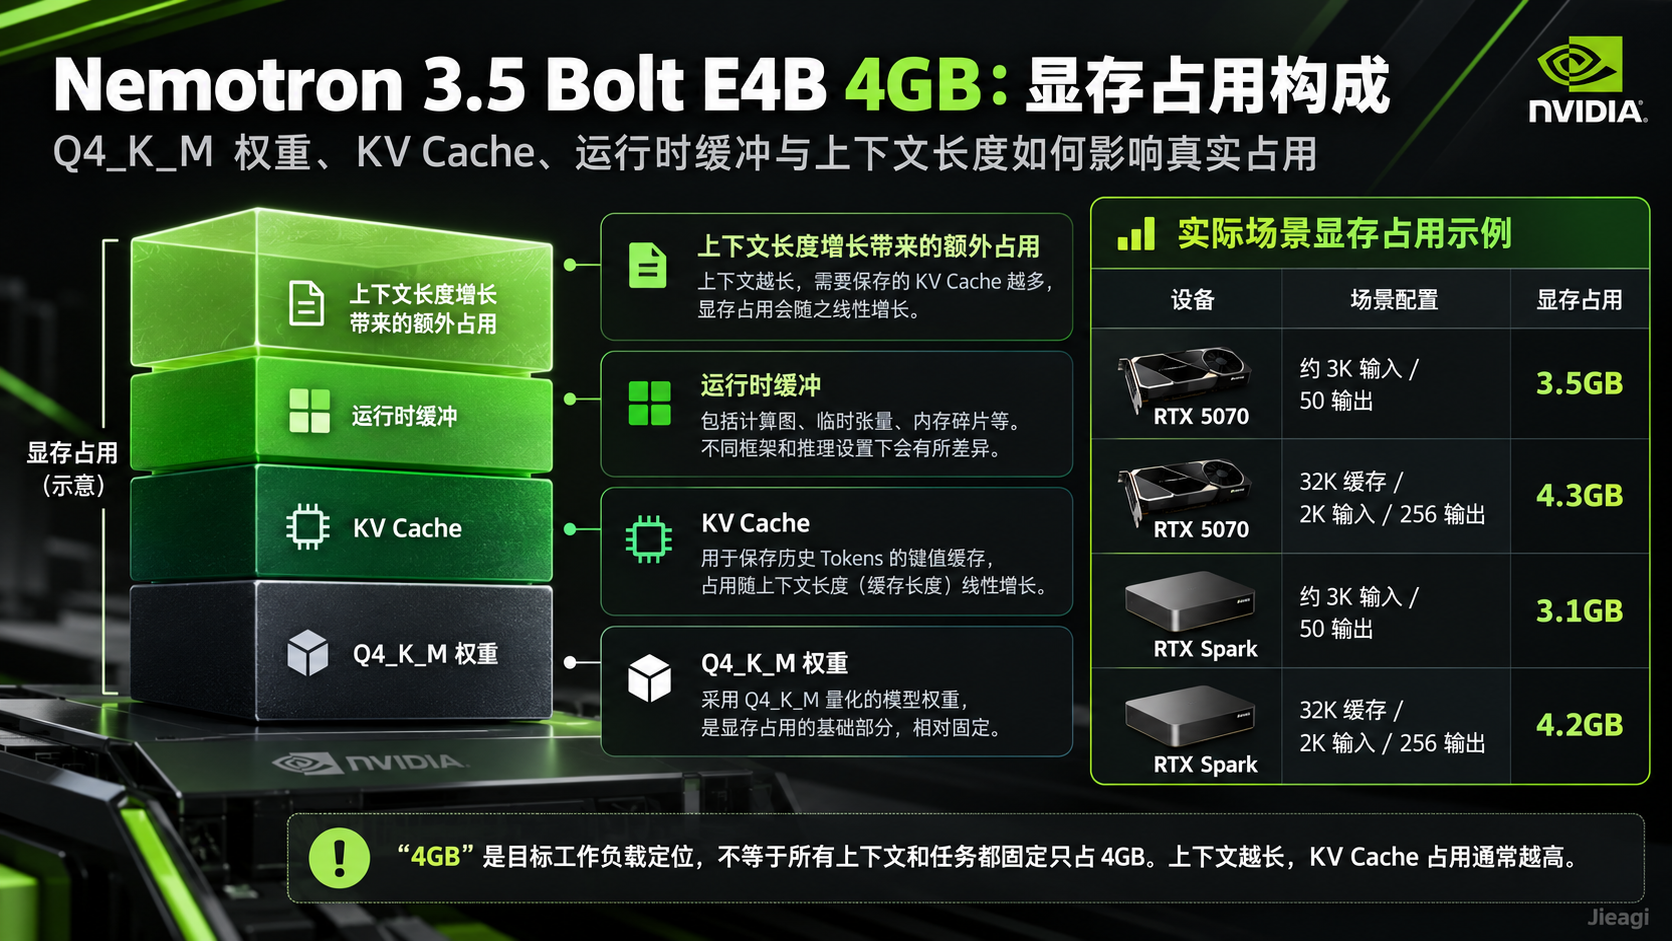
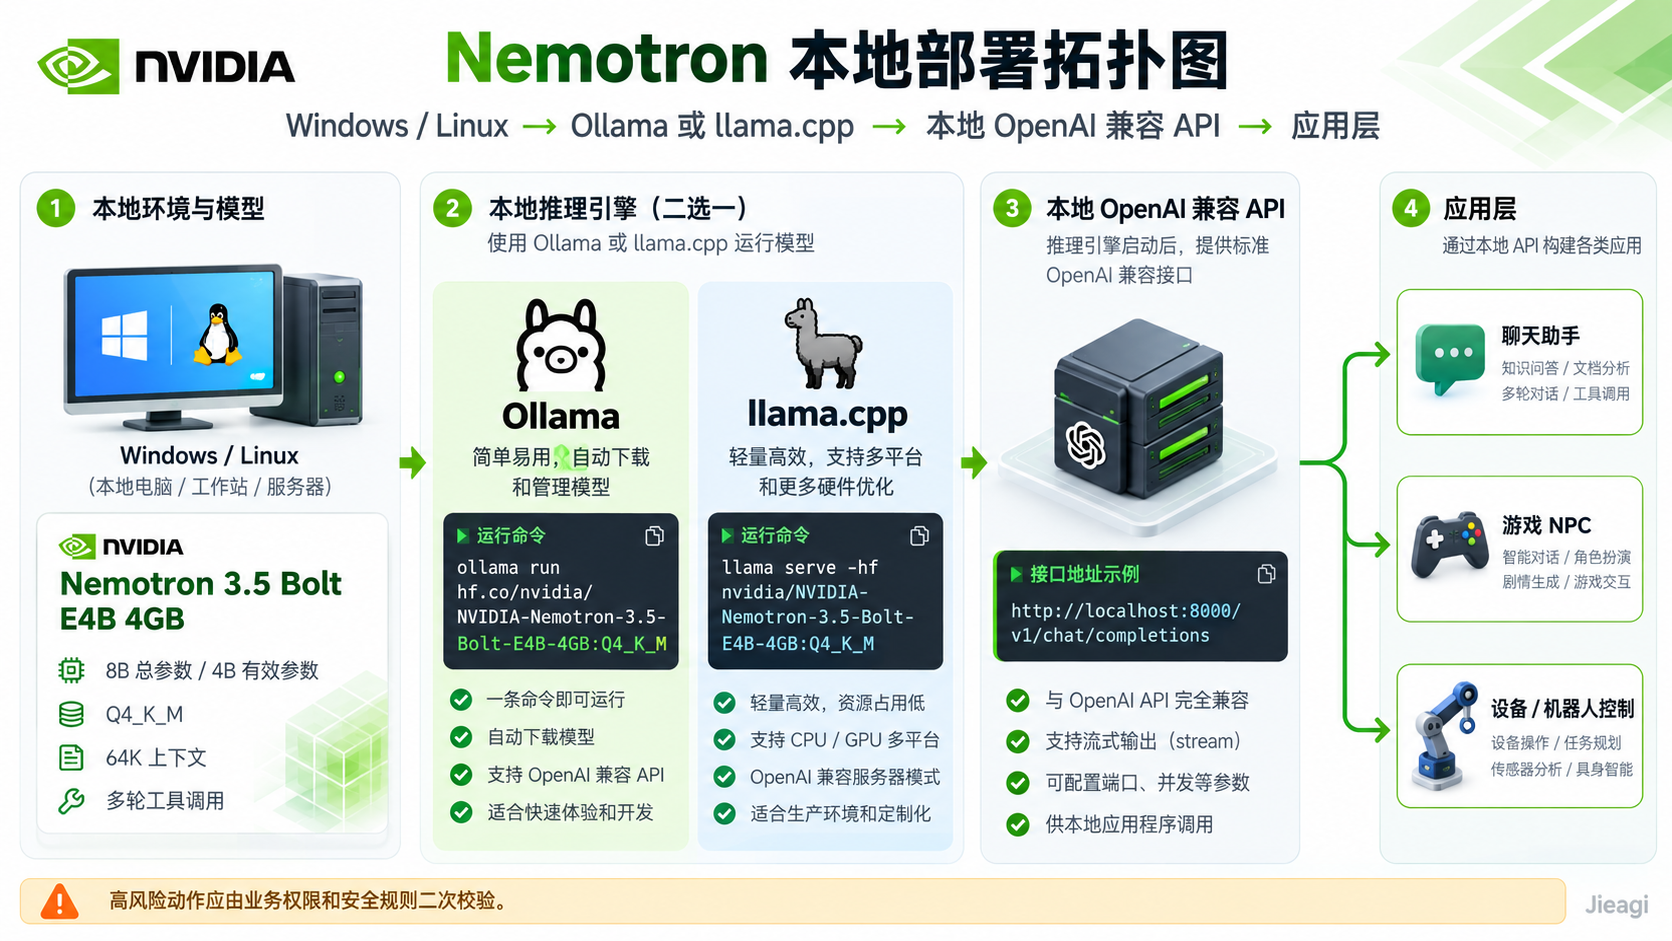
NVIDIA 在官方技术文章中说明,Bolt E4B 面向低内存推理,某些目标工作负载可以把资源需求控制在约 4GB。
但真实测试数据展示了不同上下文对显存占用的影响。
| NVIDIA 测试场景 | 显存占用 |
|---|---|
| RTX 5070,约 3K 输入、50 输出 | 3.5GB |
| RTX 5070,32K 缓存、2K 输入、256 输出 | 4.3GB |
| RTX Spark,约 3K 输入、50 输出 | 3.1GB |
| RTX Spark,32K 缓存、2K 输入、256 输出 | 4.2GB |
这组数据清楚说明,模型名称中的 4GB 是目标场景的近似定位。
不是固定最大值。
当上下文增长时,KV Cache 往往会占用更多内存。
因此,如果计划使用完整 64K 上下文,必须进一步测量实际运行资源。
六、NVIDIA 官方公布了哪些性能指标?
在指定 Q4_K_M、batch size 1 和 llama.cpp CUDA 环境中,NVIDIA 给出了不同硬件的测试结果。
例如,在 RTX 5070 上,约 3K 输入和 50 Token 输出的场景获得:
首 Token 时间约 548 毫秒。
生成速度约 133.4 Token/秒。
而在 RTX Spark 的对应测试中:
首 Token 时间约 930 毫秒。
生成速度约 67.0 Token/秒。
这些数字说明不同硬件对同一模型的性能影响明显。
但是,它们来自 NVIDIA 官方指定测试环境。
实际运行速度还会受到驱动、量化文件、上下文长度、并发数量和推理框架版本影响。
不能承诺普通用户安装后一定获得相同速度。
七、为什么它适合实时对话 Agent?
实时对话 Agent 不只是需要回答正确。
还需要在恰当时间回应用户。
例如,游戏 NPC 在玩家问话之后,如果每次需要十几秒才能回答,就可能破坏沉浸感。
车载助手或家居控制系统也希望减少等待时间。
因此,小型模型更重视首 Token 时间、输出长度和连续对话表现。
NVIDIA 为 Bolt E4B 增加了 Conversational Mode。
这个模式鼓励模型使用简洁、适合语音表达的回复。
同时,开发者可以关闭某些不必要的深度推理,减少简单任务的延迟。
但这种方式并不保证所有回答都正确,尤其是需要复杂计算或多步骤判断的任务。
八、多轮工具调用有什么意义?
对于 AI Agent,单纯生成一句话往往不够。
例如,智能家居助手收到“把书房灯调暗”之后,需要调用具体设备控制接口。
游戏 NPC 收到玩家购买商品的请求时,可能需要查询余额、检查商品库存,再更新交易记录。
这类工作需要模型在对话过程中正确选择工具,并提供符合 Schema 的参数。
NVIDIA 重点提升了 Bolt E4B 的多轮工具调用能力。
但工具调用成功率应与业务执行结果区分。
模型可能正确生成一个工具调用,却因为权限、网络或外部服务错误而无法完成任务。
因此,完整系统需要检查实际工具响应。
不能只根据模型表示“操作已完成”就更新业务状态。
九、为什么需要提供环境状态?
对于机器人或游戏 Agent,模型的输入不应只包含用户话语。
还可能需要提供环境状态。
例如,机器人当前所在位置、可用动作和电池信息。
游戏 NPC 需要知道玩家库存、游戏世界规则和任务状态。
如果这些信息缺失,模型就可能根据普通语言知识猜测结果。
这会产生严重的状态不一致问题。
例如,NPC 可能声称已经交付某件商品,但实际库存系统并没有完成记录。
因此,NVIDIA 强调输入 grounding,也就是让模型的回答和操作建立在真实工具和环境数据基础上。
这对边缘 Agent 尤其重要。
十、64K 上下文能解决什么问题?
官方公布 Bolt E4B 最多支持 64K Token 上下文。
这为多轮对话、系统指令和工具定义提供了较大空间。
例如,一个本地助手可以保留一定数量的历史会话和用户指定的操作规则。
但 64K 上下文不意味着设备可以在约 4GB 显存内无条件运行全部内容。
随着上下文增长,KV Cache 可能增加资源消耗。
此外,即使模型支持长上下文,也可能无法始终准确使用最早提供的信息。
因此,实际应用应该控制历史消息长度。
对于长期记忆,可以采用外部数据库保存结构化状态,而不是无限添加聊天记录。
十一、支持多少种语言?
NVIDIA 官方介绍,Bolt E4B 的主要多语言能力覆盖 35 种语言。
其基础模型的预训练涉及更多语言。
但“预训练语料覆盖 140 多种语言”不等于当前模型在 140 多种语言中都达到同等质量。
对于中文应用,建议准备真实的中文多轮任务进行评估。
例如,检查模型能否准确识别口语指令、保持角色风格,并生成正确的工具参数。
对语音助手而言,还需要评估语音识别系统的语言支持。
整个应用的语言能力不取决于语言模型一个组件。
十二、如何通过 Ollama 运行?
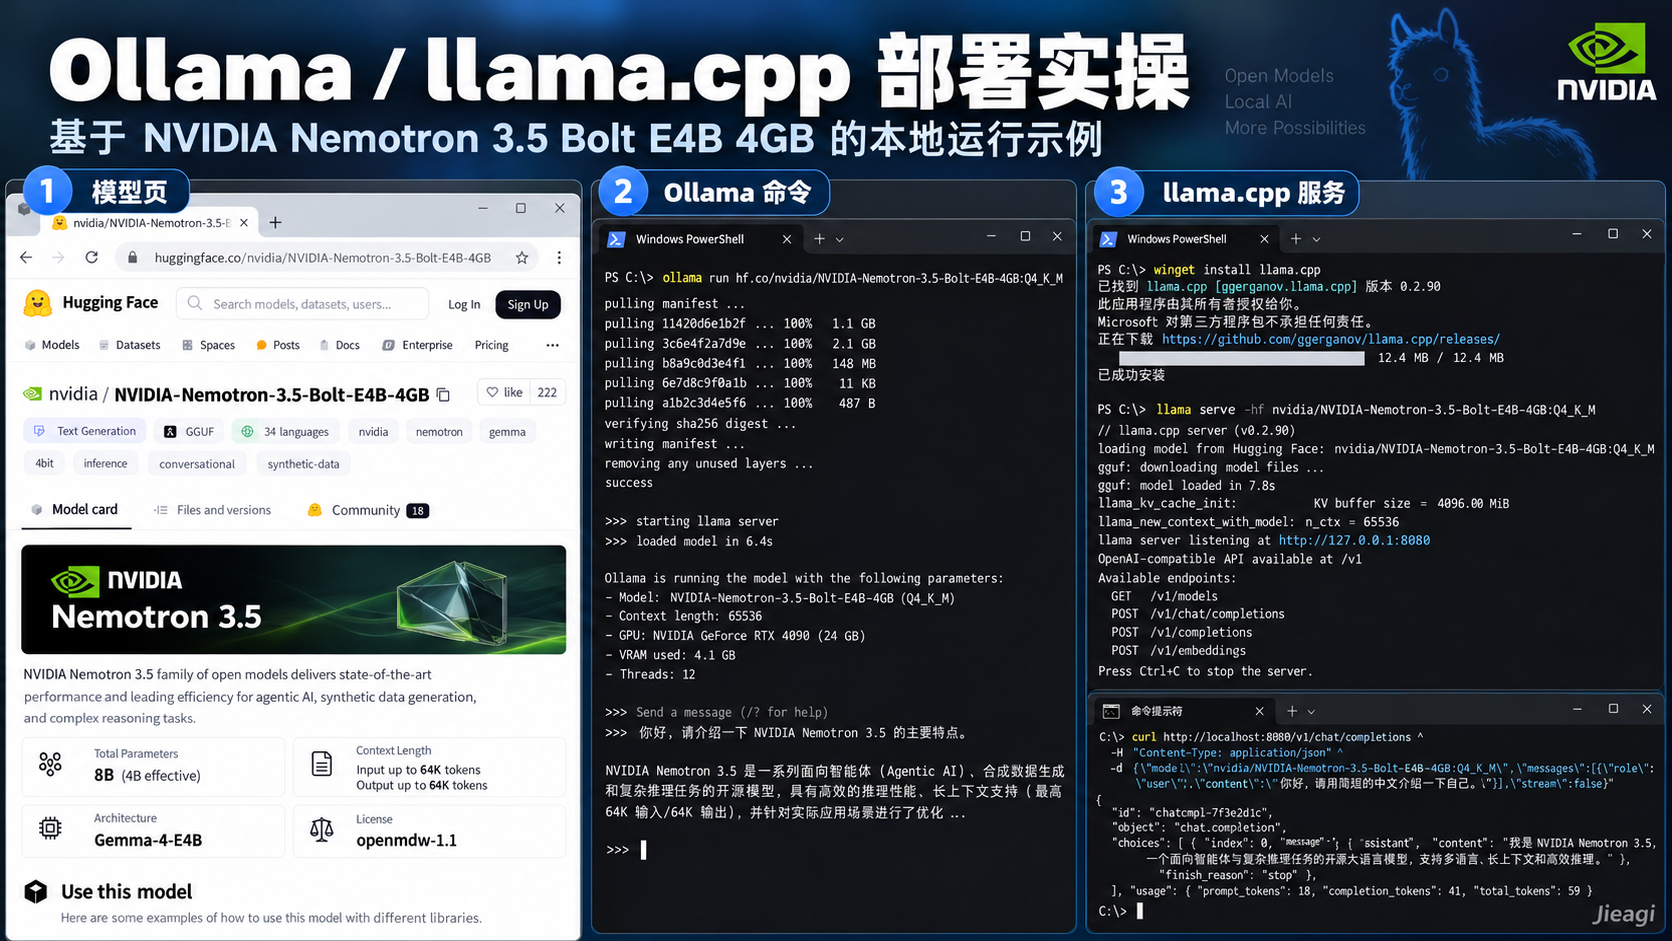
NVIDIA Hugging Face 模型页面提供了 Ollama 的使用方式。
在已经安装兼容版本 Ollama 的环境中,可以运行:
ollama run hf.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-E4B-4GB:Q4_K_M该命令会按照相应的模型资源下载和启动流程工作。
但实际执行前应确认:
本机已安装 Ollama。
当前版本支持对应 Hugging Face 模型格式。
网络能够正常访问模型仓库。
设备拥有足够磁盘和运行内存。
如果使用 Windows,可以根据 Ollama 官方发行说明安装适合本机的版本。
本文没有真实运行该命令,也没有测量下载速度或生成性能。
十三、如何使用 llama.cpp?
NVIDIA 模型卡还提供了 llama.cpp 相关说明。
Windows 用户可以通过官方支持的安装方式,例如:
winget install llama.cpp随后在支持的版本中启动本地模型服务:
llama serve -hf nvidia/NVIDIA-Nemotron-3.5-Bolt-E4B-4GB:Q4_K_M或者直接进入命令行交互模式:
llama cli -hf nvidia/NVIDIA-Nemotron-3.5-Bolt-E4B-4GB:Q4_K_M命令使用的模型标识来自 NVIDIA 模型页面。
真正的端口和运行参数需要按照本机环境配置。
如果希望在其他设备上通过网络访问,还需要设置绑定地址和身份认证。
不建议直接把没有访问控制的本地模型服务暴露到公网。
十四、能不能提供 OpenAI 兼容 API?
可以,前提是所选本地推理框架提供兼容接口。
例如,llama.cpp 的服务器模式可以提供 OpenAI 风格的聊天 API。
开发者可以把本地客户端指向自己的模型服务。
但 OpenAI 兼容协议不意味着支持所有 OpenAI 专有功能。
例如,工具调用、JSON Schema、推理参数和多模态输入可能存在差异。
因此,最好先验证普通文本生成,再检查工具调用。
对于长期运行的应用,还需要设置并发限制、超时和故障日志。
如果部署在个人电脑上,注意模型执行可能与游戏、设计软件或其他 GPU 任务争用资源。
十五、NVIDIA 是否支持更多部署方式?
官方模型页面提供了多个生态选项,包括 llama.cpp、Ollama、SGLang、vLLM 和其他本地运行工具。
此外,还展示了与部分 Agent 框架的集成说明。
但这些工具的适用硬件和运行格式存在差异。
例如,面向 CUDA 的部署与面向 CPU 或其他硬件的运行方法可能不同。
因此,不应将所有工具理解为可以使用完全相同命令启动。
尤其是 Windows 用户,应先选择一个兼容性较好的推理框架完成基础验证。
在此基础上再接入语音、工具和其他 Agent 系统。
十六、机器人如何使用 Bolt E4B?
NVIDIA 展示了 Reachy Mini 机器人应用场景。
在该示例中,其他视觉组件负责理解外部环境。
Bolt E4B 根据收到的状态信息进行对话和动作决策。
真正的动作则由机器人控制库执行。
这种架构体现了不同 AI 模型之间的任务分工。
视觉模型理解画面。
语言模型理解指令和工具。
底层控制系统执行动作。
这种方式比让语言模型直接控制全部硬件细节更加容易管理。
但机器人操作涉及现实物理安全。
因此,关键动作需要由确定性控制器和安全限制负责。
不能直接把模型生成的任意控制指令发送到高风险设备。
十七、游戏 NPC 有哪些实际场景?
例如,一个游戏中的商人 NPC,需要帮助玩家购买装备。
语言模型可以理解玩家提出的购买要求。
但交易金额、库存数量和物品交付必须通过游戏自身的业务系统执行。
NVIDIA 官方展示的示例包含确认付款、查询配方、准备材料和转移物品。
这类工作适合多轮工具调用。
但应避免让 NPC 仅根据语言模型回答就修改游戏资产。
如果模型出错,玩家可能获得重复物品,或发生不正确扣款。
因此,即使 NPC 的对话由 AI 生成,交易规则也应该保持确定性。
十八、官方 40% 质量提升应如何理解?
NVIDIA 表示,在其选择的对话 Agent 基准中,Bolt E4B 相比前代模型的平均表现提高约 40%。
但不同基准测量的能力并不相同。
例如,MultiChallenge 关注多轮一致性。
BFCL 关注工具选择和参数。
其他评测可能关注角色身份、结构化输出和指令遵守。
将这些指标汇总后形成的平均结果,不代表所有指标都提升 40%。
事实上,官方表格中某些具体任务,其他模型仍有更高成绩。
因此,选型时应该关注与实际应用最接近的评测,而不是只看汇总提升数字。
十九、模型的安全与权限应该怎样管理?
本地运行不代表 Agent 天然安全。
即使模型完全离线,也可能错误执行系统命令。
如果连接智能家居或工业设备,更需要明确工具权限。
建议将设备操作分为只读查询、低风险修改和高风险控制三类。
对于删除数据、支付、门锁和机械运动等操作,应设置额外验证。
另外,模型输出需要经过参数校验。
例如,温度设置不能超出设备允许范围。
这些规则应由业务程序执行,而不是只写在系统提示词中。
二十、如何评估是否值得本地部署?
可以从四个方面判断。
第一,隐私需求。是否需要尽量减少对外发送数据?
第二,硬件条件。是否有足够显存和内存?
第三,实际延迟。模型在本机能否满足业务需求?
第四,维护成本。是否有人负责更新模型、处理依赖和解决故障?
如果应用每天只有少量请求,云端 API 可能更省事。
如果设备需要离线运行,或长期持续处理大量本地交互,本地模型可能具有明显价值。
但不应只依据模型文件大小就作出决定。
二十一、FAQ:常见问题
Nemotron 3.5 Bolt E4B 已经开放下载了吗?
是的,官方于 2026 年 10 月 23 日发布相关模型资源。
只有 4GB 显存就能运行任何任务吗?
不能保证。官方数据显示较长上下文配置可能超过 4GB。
它是 4B 还是 8B 模型?
官方模型卡列出 8B 总参数和约 4B 有效参数。
它支持图片输入吗?
该模型卡明确列出文本输入与文本输出。视觉应用需要组合其他组件。
上下文窗口是多少?
最高 64K Token,实际运行内存随上下文变化。
可以通过 Ollama 使用吗?
NVIDIA 已提供对应的 Ollama 使用说明。
能在 Windows 上运行吗?
可通过支持 Windows 的推理框架尝试,实际硬件兼容性和性能需要验证。
能直接控制家居设备吗?
模型可以参与工具调用,但实际设备操作需要授权的业务接口和独立安全机制。
二十二、结语
Nemotron 3.5 Bolt E4B 4GB 展示了本地 AI Agent 的另一条发展方向。
它没有追求最大参数规模,而是强调在较少内存中提供多轮对话、工具调用和环境理解能力。
对于本地助手、机器人界面和游戏 NPC,这类模型可能比大型通用模型更加容易部署。
但开发者必须理解 4GB 是特定运行场景的资源定位,而不是通用硬件保证。
真正可靠的本地 Agent,还需要合理控制上下文、部署权限、工具调用和运行环境。
未来,随着小模型和边缘设备不断发展,越来越多 AI 功能有机会在用户自己的硬件上完成。
官方参考资料
1. NVIDIA — Nemotron 3.5 Bolt E4B 4GB 技术介绍 https://research.nvidia.com/labs/nemotron/Nemotron-3.5-Bolt-E4B-4GB/
2. NVIDIA Hugging Face 官方模型卡 https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-E4B-4GB
3. NVIDIA Nemotron 官方项目 https://research.nvidia.com/labs/nemotron/
4. Ollama https://ollama.com/
5. llama.cpp https://github.com/ggml-org/llama.cpp
转载请注明出处: 界智通
本文的链接地址: https://www.jieagi.com/aizixun/204.html
-
GPT-5-Codex保姆级教程:获取OpenAI APIKey与安装 Codex CLI使用教程全面指南
2025/09/17
-
2025最新:Claude Pro 与 Max 区别详解与订阅指南
2025/08/26
-
Gemini 报错 "Something went wrong" 终极解决指南
2025/11/27
-
Cursor权威指南:从注册入门到精通AI驱动编程工作流(含国内注册与验证说明)
2025/08/27
-
【实测有效】Gemini 3 / Google Antigravity 授权登录无反应、无权限?全平台解决办法汇总指南
2025/11/22
-
2025最新保姆级教程:如何获取Claude API Key?从注册到Python调用,一篇搞定!
还在为如何申请 Claude API Key 而头秃吗?随着 Claude 4.5 Sonnet 在编程能力上的强势崛起,越来越多的开发者开始转向 Anthropic 的阵营。本文将通过“保姆级”的图文实操,带你一步步解决账号注册、手机号验证、API Key 获取及额度充值等难题,并附带 Python 极简调用示例。无论你是想接入 LangChain 还是自己在这个强大的模型上跑 Demo,这篇文章都能帮你避开 99% 的坑!
2025/11/15
-
WorkBuddy 高阶进阶全解:获取OpenAI Key自定义 API + SKILL.md 封装,效率直接翻倍
2026/04/19
-
[2025最新] ChatGPT Plus 订阅终极指南:四种充值方案与深度解析:为什么它值$20?
2025/11/13
-
Google AI Pro 有什么功能?Google AI Pro 生态系统深度报告以及订阅会员权益功能全面分析
2025/11/29
-
Grok-4.1 深度拆解:马斯克的“叛逆”AI怎么接入?xAI Grok API Key 获取及开发攻略
想要体验马斯克旗下xAI的Grok大模型?本文详细拆解 Grok API Key 获取的全流程,从账号登录、控制台设置到API Key生成,并附带完整的Python调用代码示例。解决开发者在申请过程中遇到的支付、权限等常见问题,助你快速将“叛逆”的Grok集成到自己的应用中。
2025/11/18

暂无评论
太好看了,快点更新!
国内开发者玩转Claude:最新Claude 4模型解析与API Key获取攻略
这是系统生成的演示评论
国内开发者玩转Claude:最新Claude 4模型解析与API Key获取攻略