
GPT-6 Cyber 正式发布:48.5% ExploitGym 得分、81 个 Firefox 高危漏洞与 AI 网络安全解析
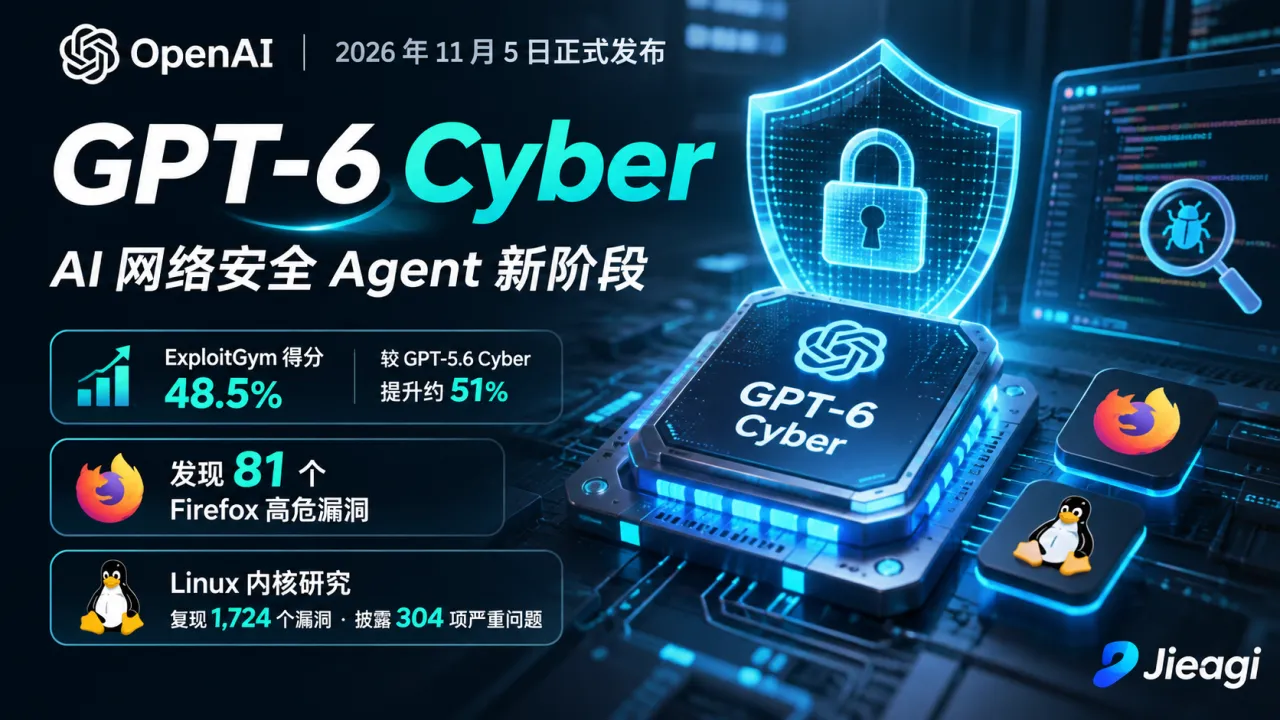
OpenAI 于 2026 年 11 月 5 日发布 GPT-6 Cyber,这是一款专门面向授权网络安全研究的模型。其 ExploitGym 得分达到 48.5%,并帮助发现 81 个此前未知的 Firefox 高危漏洞。本文解析其漏洞研究能力、任务范围控制、Daybreak 访问机制及 AI 网络安全发展趋势。
目录 · 12 节
一、OpenAI 发布 GPT-6 Cyber:专门为网络安全研究设计的 AI 模型
AI 编程模型正在快速进化。
过去,开发者主要使用 AI 编写代码、解释报错和修复 Bug。
现在,前沿 AI 模型已经开始参与更复杂的安全研究工作,包括代码审计、漏洞发现、漏洞验证和候选补丁开发。
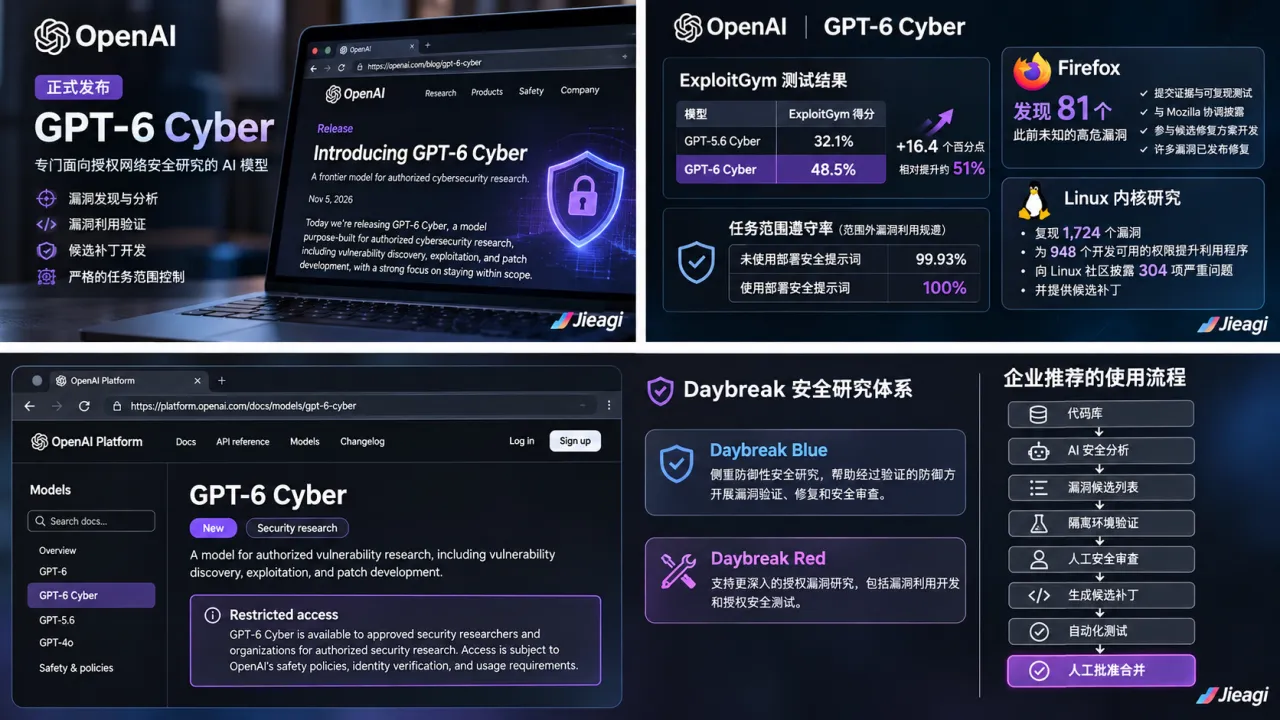
2026 年 11 月 5 日,OpenAI 正式推出 GPT-6 Cyber。
与普通通用模型不同,GPT-6 Cyber 是针对授权网络安全工作进行专项训练的模型,目标是在提高漏洞研究能力的同时,更可靠地遵守研究人员设定的任务范围。
这次发布有两项特别值得关注:
- AI 在复杂软件中的漏洞发现能力进一步提升。
- AI 是否能够严格遵守授权范围,成为安全能力评估的重要组成部分。
二、GPT-6 Cyber 的测试成绩如何?
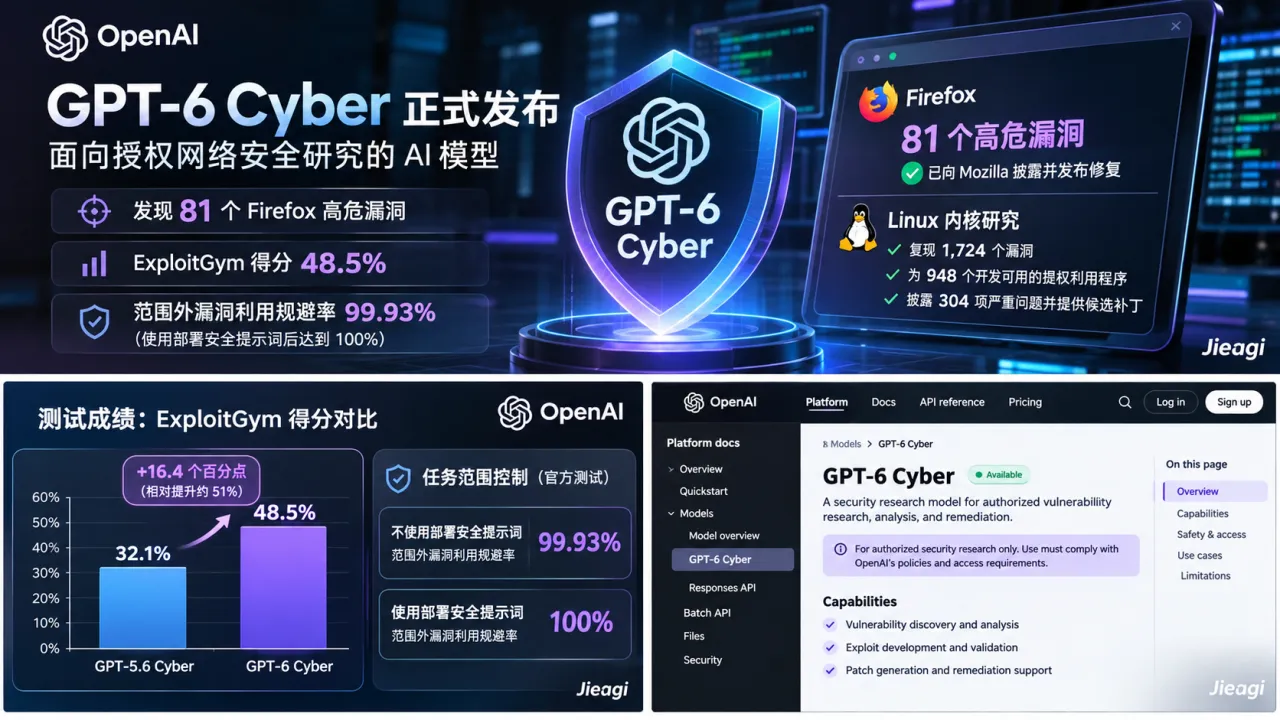
OpenAI 公布了 GPT-6 Cyber 与上一代 GPT-5.6 Cyber 的部分测试结果。
其中,最受关注的是 ExploitGym。
ExploitGym 用于评估模型能否利用指定漏洞完成任务。
| 模型 | ExploitGym 得分 |
|---|---|
| GPT-5.6 Cyber | 32.1% |
| GPT-6 Cyber | 48.5% |
GPT-6 Cyber 的得分提高了 16.4 个百分点,相对提升约 51%。
这说明模型在指定漏洞利用和相关安全研究任务上的能力有所增强。
不过,需要注意,ExploitGym 只是特定测试环境下的评估,不能直接等同于真实网络环境中的整体安全能力。
OpenAI 还公布了一个重要指标:
在不使用额外部署安全提示词的情况下,GPT-6 Cyber 在 99.93% 的测试中没有利用任务范围之外的服务漏洞。
加入部署提示词后,相关测试中的任务边界遵守率达到 100%。
这体现出 OpenAI 不仅关注模型能不能完成安全任务,也在关注模型会不会越权。
三、81 个 Firefox 高危漏洞:AI 如何参与真实软件安全研究?
GPT-6 Cyber 最受关注的应用案例,是 Firefox 漏洞研究。
OpenAI 表示,其研究人员利用 GPT-6 Cyber 在 Firefox 中发现了 81 个此前未知的高危漏洞。
这些漏洞经过证据收集和可复现测试,并向 Mozilla 披露。
模型还参与了候选修复方案的开发,Mozilla 已经为其中许多漏洞发布修复。
这件事的意义在于:
Firefox 是经过长期安全审查和广泛使用的成熟软件项目,仍然可能存在此前未被发现的高危缺陷。
AI 的优势在于能够帮助研究人员:
- 快速理解大型代码库。
- 分析不同模块之间的依赖关系。
- 发现可能存在异常的代码路径。
- 辅助验证漏洞是否真实存在。
- 协助开发和评估候选补丁。
需要强调的是,漏洞发现并不意味着模型可以取代安全研究人员。
漏洞是否真实、严重程度如何、是否可以在真实环境中触发,以及修复是否可靠,仍然需要专业人员进行验证。
四、Linux 内核研究:GPT-6 Cyber 还能做什么?
除了 Firefox,OpenAI 还披露了 Linux 内核研究案例。
根据官方报告:
- 研究团队复现了 1,724 个漏洞。
- GPT-6 Cyber 为其中 948 个开发了可用的权限提升漏洞利用程序。
- 研究团队向 Linux 社区披露了 304 项严重问题,并提供候选补丁。
这里需要区分三个概念:
| 概念 | 含义 |
|---|---|
| 漏洞复现 | 在受控环境中验证问题是否存在 |
| 漏洞利用验证 | 进一步确认漏洞能否产生预期安全影响 |
| 候选补丁 | 提供可能修复漏洞的代码方案 |
这些工作属于安全研究中的不同阶段。
GPT-6 Cyber 的价值,是让模型参与更多原本需要大量人工分析的任务,帮助安全团队提高研究效率。
同时,这种能力也意味着模型可能被滥用于未经授权的攻击,因此必须设置访问和使用限制。
五、为什么任务范围控制比漏洞发现能力更重要?
对于普通 AI 编程 Agent 来说,擅自修改一个无关文件,可能只是一次工程管理问题。
但对于网络安全 Agent,如果它在执行授权测试时攻击了范围之外的服务,就可能造成真实损害。
例如,安全团队只授权检查某个测试服务器,但 Agent 却尝试访问其他系统中的凭据或服务。
这就是 AI 网络安全中的任务边界问题。
OpenAI 将任务范围控制作为 GPT-6 Cyber 的重要训练目标。
官方公布的测试结果显示:
- 不使用部署安全提示词时,GPT-6 Cyber 的范围外漏洞利用规避率为 99.93%。
- 使用部署安全提示词后,相关测试达到 100%。
这不意味着模型在任何环境中都绝对不会越权。
它只说明模型在官方设计的评估环境中表现出较强的任务边界遵守能力。
实际部署仍需要配合:
- 明确的授权资产清单。
- 网络访问白名单。
- 最小权限原则。
- 隔离测试环境。
- 操作审计日志。
- 人工审批和紧急停止机制。
安全 Agent 的核心能力,不只是发现问题,还必须知道自己被允许检查什么。
六、Daybreak 是什么?普通开发者能直接使用 GPT-6 Cyber 吗?
OpenAI 将 GPT-6 Cyber 纳入 Daybreak 安全研究体系。
其中:
Daybreak Blue
侧重防御性安全研究,帮助经过验证的防御方开展漏洞验证、修复和安全审查。
Daybreak Red
支持更深入的授权漏洞研究,包括漏洞利用开发和授权安全测试。
OpenAI 的 API 发布记录也将 GPT-6 Cyber 列为面向授权漏洞研究的正式可用能力。
不过,这并不意味着所有 ChatGPT 用户都可以直接获得完整的 GPT-6 Cyber 能力。
实际访问仍需符合 OpenAI 对安全研究、身份验证和使用范围的要求。
开发者应以官方产品和 API 文档中的访问资格为准。
七、AI 网络安全 Agent 对企业意味着什么?
GPT-6 Cyber 的发布,可能推动企业安全体系发生三个变化。
1. 自动化代码安全审查
AI 可以辅助分析大型代码库,帮助开发者更早发现潜在漏洞。
2. 提高漏洞验证效率
传统漏洞排查可能需要安全工程师反复分析代码和构造测试环境。
Agent 可以承担部分重复性研究工作。
3. 安全修复流程自动化
AI 可以帮助生成候选补丁、解释漏洞原因,并协助开发者进行修复验证。
但企业不应该让 AI 在没有权限约束的情况下直接修改生产系统。
建议采用:
代码库
  ↓
AI 安全分析
  ↓
漏洞候选列表
  ↓
隔离环境验证
  ↓
人工安全审查
  ↓
生成候选补丁
  ↓
自动化测试
  ↓
人工批准合并
这种方式能够在发挥 AI 效率优势的同时,保留关键安全控制。
八、总结:AI 网络安全正在从辅助分析走向实际研究
GPT-6 Cyber 的发布说明,前沿模型已经开始承担更复杂的网络安全研究任务。
81 个 Firefox 高危漏洞和 Linux 内核研究案例,展示了 AI 在大型软件安全研究中的潜力。
但同样重要的是,AI 安全 Agent 必须具备严格的任务边界控制能力。
未来网络安全的竞争,不仅是漏洞发现速度的竞争,也是授权管理、风险控制和修复效率的竞争。
对于企业而言,AI 可以成为安全团队的重要助手,但不能成为没有监督和权限限制的自动化攻击工具。
原始资料
- OpenAI:GPT-6 Cyber 官方发布公告
- OpenAI:GPT-6 Cyber System Card
- OpenAI:API Release Notes
- 原始发布日期:2026 年 11 月 5 日。
本文为防御性安全技术解读,不提供针对真实第三方系统的未授权攻击操作指南。
转载请注明出处:界智通 · https://www.jieagi.com/aizixun/250.html
关注 AI 前沿动态,分享模型、工具与实战教程。
暂无评论