
阿里Qwen4-Max正式版横评:2.4T架构、价格与对比Opus 5.5
深度评测阿里巴巴2026年11月16日发布的Qwen4-Max正式版(qwen4-max):全面拆解2.4万亿参数Gated DeltaNet架构、$1.50/$4.50 API价格,横向对比Claude Opus 5.5、GPT-6.1 Sol与Kimi K3.1在16项基准上的真实表现。
目录 · 14 节
- 阿里 Qwen4-Max 正式版全面横评:2.4T 架构、$1.50/$4.50 定价与对比 Opus 5.5、GPT-6.1 Sol 及 Kimi K3.1 实测
- 一、对比对象与基础信息全景表(价格、上下文、架构与可用性)
- 二、分维度深度对比:16 项基准跑分、架构革新与真实任务成本
- 1. 架构革新:3:1 Gated DeltaNet + 四分支门控残差 + 328B N-gram 嵌入
- 2. 16 项基准硬碰硬:法律与 SWE 编程夺冠,但终端操作与视觉理解存在短板
- 3. 成本与话痨度实测:单价极低但“非常啰嗦”,缓存命中是省钱核心
- 三、API 迁移避坑与开源插件 Qwen-Live-Delivery-Plugin 解析
- 四、适用场景推荐与最终选型建议
- 常见问题
- 1. Qwen4-Max 正式版开源模型权重了吗?可以本地私有化部署吗?
- 2. 之前的预览版 qwen4-max-preview 还能用多久?升级到 qwen4-max 需要改什么代码?
- 3. Qwen4-Max 按量付费(Pay-as-you-go)和 Token Plan 订阅怎么选更划算?
- 4. 为什么用 Qwen4-Max 跑红队渗透测试或漏洞利用脚本会被拒绝?
- 参考来源
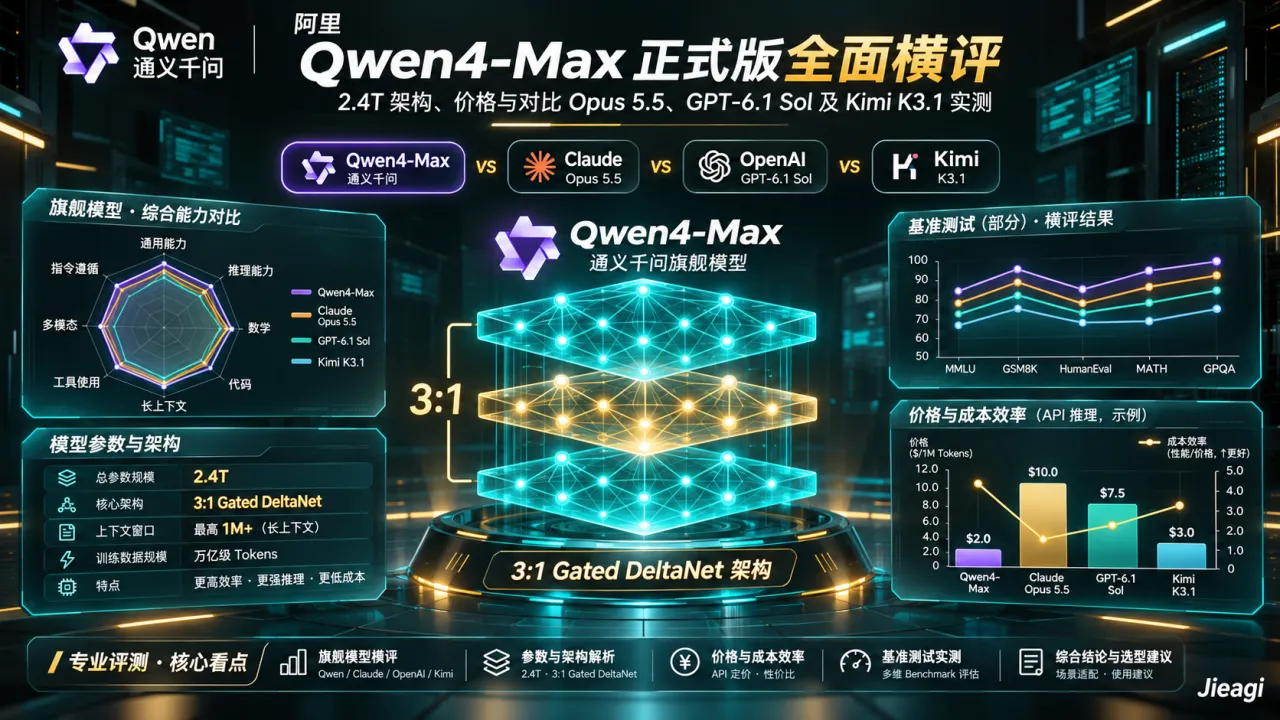
阿里 Qwen4-Max 正式版全面横评:2.4T 架构、$1.50/$4.50 定价与对比 Opus 5.5、GPT-6.1 Sol 及 Kimi K3.1 实测
2026 年 11 月 16 日,阿里巴巴通义千问团队正式将 Qwen4-Max 从仅限订阅制的预览通道推向全面可用(GA),在阿里云百炼(Model Studio)、国际版 QwenCloud 及 OpenRouter 同步上线按量付费生产接口(模型 ID 为 qwen4-max)。与 5 天前仅在 Token Plan 中低调测试、未公布参数与单价的预览版不同,此次正式版一口气揭晓了 2.4 万亿(2.4T)底层架构参数、100 万 Token 多模态上下文、$1.50 / $4.50 每百万 Token 的官方定价以及涵盖 16 项权威基准的正面横评表(Yotta Labs 规格与定价拆解、AgentsPulse 16 项基准横评)。
对于正在评估国产旗舰模型能否替代海外闭源模型的架构师而言,最核心的问题是:Qwen4-Max 相比上一代 Qwen 3.8-Max 到底强在哪?面对 Claude Opus 5.5、GPT-6.1 Sol、GPT-6 Astra 和 Kimi K3.1 Pro,哪些任务该切流给它,哪些任务仍需保留海外闭源模型? 本文将基于官方发布数据与 Artificial Analysis、Arena 等独立第三方榜单给出完整评测。
一、对比对象与基础信息全景表(价格、上下文、架构与可用性)
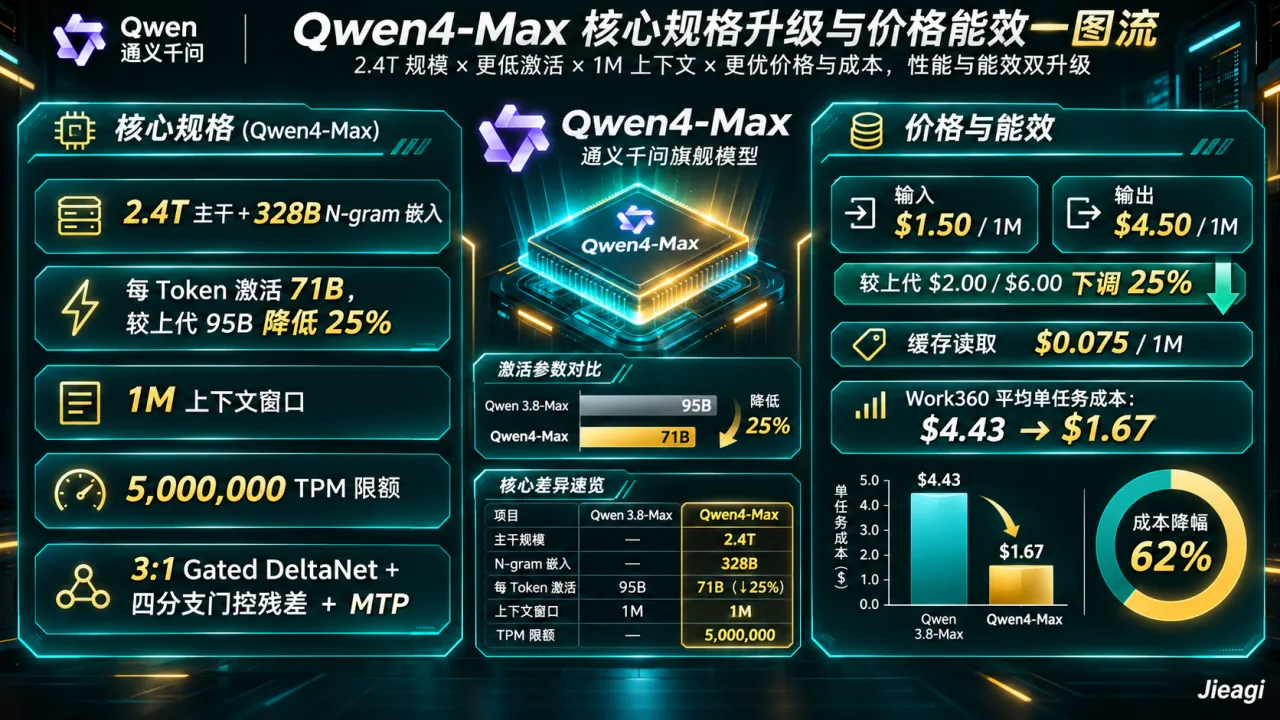
为了客观衡量 Qwen4-Max 在 2026 年 11 月旗舰阵营中的坐标,我们将其与上一代开源权重旗舰 Qwen 3.8-Max(0902 快照)、Anthropic 主力旗舰 Claude Opus 5.5、OpenAI 主力推理模型 GPT-6.1 Sol、OpenAI 科研级重型旗舰 GPT-6 Astra 以及月之暗面 Kimi K3.1 Pro 进行同维度拉齐(价格与功能以官方最新公布为准,数据核实自 Yotta Labs 与 AgentsPulse):
| 对比维度 | Qwen4-Max(正式版) |
Qwen 3.8-Max(0902) |
Claude Opus 5.5 |
GPT-6.1 Sol |
Kimi K3.1 Pro |
|---|---|---|---|---|---|
| 发布日期 | 2026-11-16 | 2026-08-03(0902 更新) | 2026 年秋季 | 2026 年秋季 | 2026-10-23(11-04 开源) |
| 模型架构与参数量 | 2.4T MoE(激活 71B)+ 328B N-gram 嵌入 | 2.4T MoE(激活约 95B) | 闭源未公布 | 闭源未公布 | MoE 架构(开源权重) |
| 上下文窗口 | 1,000,000 tokens(最大输入 991,808) | 1,000,000 tokens | 200K–1M(视层级) | 高上下文支持 | 长上下文支持 |
| 最大输出上限 | 非思考 131,072 / 思考+回答合计 262,144 | 131,072 tokens | 高输出上限 | 高输出上限 | 高输出上限 |
| 输入模态 | 文本、图像、视频、PDF | 文本为主 | 文本、图像、PDF | 文本、图像 | 文本、多模态 |
| API 列表价格(输入 / 输出 每百万) | $1.50 / $4.50(国际站 QwenCloud) | $2.00 / $6.00(国际站) | $4.00 / $20.00 | $2.00 / $10.00 | $2.00 / $10.00 |
| 缓存读取价格(每百万 Token) | $0.075(享 95% 折扣,写 5m $1.875 / 1h $3.00) | $0.20(视渠道) | $0.20 | $0.10 | 支持上下文缓存 |
| Artificial Analysis 综合指数 / 单任务成本 | 43 分 / $3.27 每任务(第 2 低成本) | 低于 Qwen4-Max | 59 分 / $10.04 每任务 | 55 分(中推理 46)/ $1.27 | 46 分 / $3.68 每任务 |
| 是否开源权重 | 否(仅 API,承诺后续开源小尺寸 Qwen4) | 是(8月12-13日已发权重) | 否 | 否 | 是(Kimi K3.1 Pro License) |
| 兼容 API 格式與速率限制 | OpenAI Chat/Responses、Anthropic Messages、DashScope(5M TPM) | OpenAI 兼容、DashScope | Anthropic Messages、Bedrock/Vertex | OpenAI Responses / Chat | OpenAI / Anthropic 兼容 |
二、分维度深度对比:16 项基准跑分、架构革新与真实任务成本
1. 架构革新:3:1 Gated DeltaNet + 四分支门控残差 + 328B N-gram 嵌入
为什么 Qwen4-Max 能在保持 2.4 万亿总参数的同时,把每个 Token 的激活参数从 Qwen 3.8-Max 的 95B 砍掉 25% 降至 71B,且基础模型(Qwen4-Max-Base)在知识、代码、问答与 STEM 内部评测中的每字节比特数(Bits per byte,越低越好)反而降低了 5% 至 13%?
根据 SiliconANGLE 与 AgentsPulse 对官方架构图的拆解,阿里对 Transformer 进行了三处核心手术:
- 3:1 混合注意力层(Gated DeltaNet + Qwen Sparse Attention):模型每 4 层为一组——其中 3 层采用 Gated DeltaNet(GDN),将长历史上下文压缩进固定大小的状态中,无需对每个历史 Token 做全量计算;剩余 1 层采用 Qwen Sparse Attention(QSA,稀疏注意力),通过轻量级索引器按微块(Micro-block)粒度挑出相关上下文。这直接大幅削减了百万级长序列的显存与计算开销。
- 四通道门控残差流(Gated Residual):传统大模型只有一条残差连接通道传输梯度,而
Qwen4-Max将残差流拓宽为 4 条并行分支,并配备可学习的读写门控(Read/Write Gates),实现了 2.4T 超大规模预训练全程零 Loss 尖峰(No Loss Spikes)。 - 328B N-gram Embedding 缓存表与 MTP:在第 2 层挂载了高达 3280 亿参数的 N-gram 嵌入查找表,直接缓存高频局部词元组合的计算结果,并配合预测头旁的多词元预测(MTP)模块加速生成(关于此前预览版背景可参考
[内链:阿里Qwen4-Max-Preview上线Token Plan与早期评测])。
2. 16 项基准硬碰硬:法律与 SWE 编程夺冠,但终端操作与视觉理解存在短板
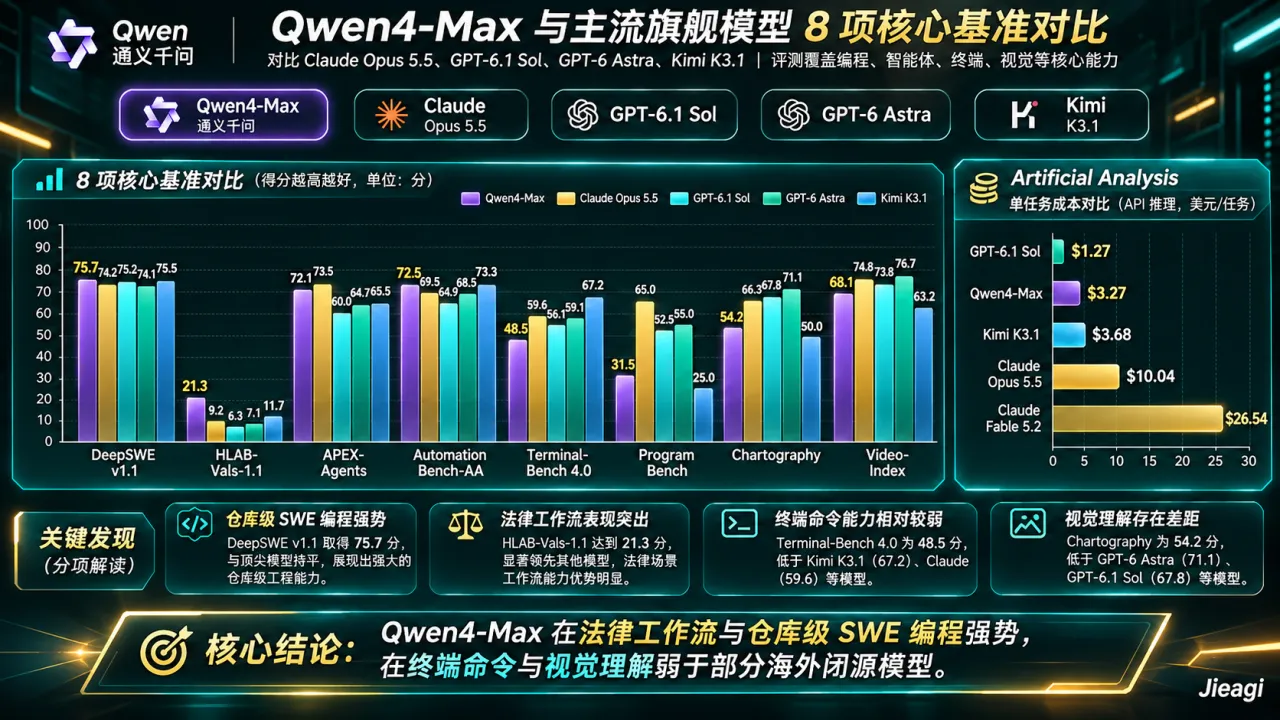
在阿里官方发布的 16 项基准横评表(部分数据引自 Artificial Analysis、Arena、Mercor 与 Vals Index 第三方榜单)中,Qwen4-Max 在所有 15 个可比项目上全面超越前代 Qwen 3.8-Max,并在 4 个项目上拿下全场第一;但与海外闭源模型及 Kimi K3.1 相比,呈现出非常鲜明的“偏科”特征(数据引自 AgentsPulse 与 Yotta Labs):
| 评测基准(测试方向) | Qwen4-Max |
Qwen 3.8-Max |
Claude Opus 5.5 |
GPT-6.1 Sol |
GPT-6 Astra |
Kimi K3.1 |
单项冠军 |
|---|---|---|---|---|---|---|---|
| DeepSWE v1.1(Agent 级软件工程) | 75.7 | 69.3 | 74.2 | 75.2 | 74.1 | 75.5 | Qwen4-Max (75.7) |
| HLAB-Vals-1.1(法律智能体工作流) | 21.3 | 15.4 | 9.2 | 6.3 | 7.1 | 11.7 | Qwen4-Max (21.3,超 Opus 两倍) |
| Agents' Last Exam v1.1(长程复杂任务) | 46.7 | 27.9 | — | — | — | — | Qwen4-Max (46.7) |
| BioMysteryBench(生物信息学科研) | 85.0 | 84.1 | — | — | — | — | Qwen4-Max (85.0) |
| APEX-Agents v1.1(专业咨询服务) | 72.1 | 63.3 | 73.5 | 60.0 | 64.7 | 65.5 | Claude Opus 5.5 (73.5) |
| AutomationBench-AA(SaaS 自动化) | 72.5 | 56.2 | 69.5 | 64.9 | 68.5 | 73.3 | Kimi K3.1 (73.3) |
| CodeArena Elo(Web 前端与全栈开发) | 1750 | 1676 | 1816 | 1742 | 1763 | 1686 | Claude Opus 5.5 (1816) |
| Terminal-Bench 4.0(终端命令行编码) | 48.5 | 38.9 | 59.6 | 56.1 | 59.1 | 67.2 | Kimi K3.1 (67.2) |
| ProgramBench(黑盒软件复刻) | 31.5 | 28.0 | 65.0 | 52.5 | 55.0 | 25.0 | Claude Opus 5.5 (65.0) |
| Humanity's Last Exam(跨学科极限推理) | 51.7 | 43.9 | 59.8 | 54.0 | 53.6 | 51.1 | Claude Opus 5.5 (59.8) |
| Chartography(复杂图表视觉理解) | 54.2 | 42.0 | 66.3 | 67.8 | 71.1 | 50.0 | GPT-6 Astra (71.1) |
| Video-Index(长视频理解) | 68.1 | 63.2 | 74.8 | 73.8 | 76.7 | 63.2 | GPT-6 Astra (76.7) |
此外,在社区盲测榜单 DesignArena 的首日对决中,Qwen4-Max 在办公文档自动化赛道表现亮眼:在 Python-PPTX(幻灯片生成)榜单以 1302 Elo 位列全球第 4,在 Spreadsheet(电子表格处理)榜单以 1336 Elo 位列全球第 5(ExplainX)。
3. 成本与话痨度实测:单价极低但“非常啰嗦”,缓存命中是省钱核心
在独立评测机构 Artificial Analysis Intelligence Index v5.0.1 中,Qwen4-Max 综合得分为 43 分(在 81 款模型中排第 38,高于类别中位数 41,但低于 Claude Fable 5.2 的 65 分、Gemini 4 Carbon 的 60 分、Claude Opus 5.5 的 59 分、GPT-6 Astra 的 57 分、GPT-6.1 Sol 的 55 分及 Kimi K3.1 Pro 的 46 分)。
值得开发者高度关注的是其 Token 消耗习惯:
- 阿里内部基准(Work360):阿里表示在涵盖 26 个大类、721 个专业领域的自建基准 Work360 上,
Qwen4-Max得分从 47.74 升至 52.69,同时消耗的 Token 减少 24%(xhigh)至 35%(high),在 Terminal-Bench 4.0 上减少 48%–49%,叠加单价下调,Work360 平均单任务成本从 $4.43 降至 $1.67(下降 62%)。 - 第三方独立实测(Artificial Analysis & OpenRouter):Artificial Analysis 指出
Qwen4-Max在整套测试中输出了高达 1.27 亿(127M)Token(远高于行业中位数 7860 万 Token),被评定为 “Very Verbose(非常啰嗦)”;但由于其单价仅$1.50/$4.50且缓存读取仅$0.075/M(OpenRouter 首日统计高达 85.9% 的输入命中了缓存,加权平均输入成本仅$0.277/M),其完成单个 Index 任务的综合账单仅为 $3.27——不到Claude Opus 5.5($10.04)的三分之一,更只有Claude Fable 5.2($26.54)的八分之一!
三、API 迁移避坑与开源插件 Qwen-Live-Delivery-Plugin 解析
如果你在 11 月 11 日至 15 日期间接入了预览版 qwen4-max-preview 或从 qwen3.8-max 升级,必须在北京时间 2026 年 11 月 25 日 24:00 前完成以下代码与配置迁移(届时 qwen4-max-preview 将正式停服,详见 Yotta Labs):
- 默认开启
high强度思考且共享输出上限:qwen4-max默认开启思考模式(reasoning_effort="high",可选low/high/xhigh,而在预览版中默认为xhigh;如需关闭可在 Chat Completions 中设置enable_thinking: false)。注意:max_tokens现在等同于max_completion_tokens,同时计入思考 Token 与最终回答 Token(上限 262,144)!如果你沿用旧版仅按回答长度设置的max_tokens=4096,思考过程会把配额吃光导致正文被截断。 - 多轮工具调用必须回传
reasoning_content与CoT Summary:preserve_thinking默认开启,多轮对话回传 Tool 结果时,必须将上一轮助手的推理内容放在reasoning_content字段中(不可拼接到content里),或启用加密推理摘要 CoT Summary。此外,严禁同时传入reasoning_effort与thinking_budget,否则接口直接报错。 - 开源
Qwen-Live-Delivery-Plugin解决长任务干等痛点:针对长程 Agent 任务动辄运行几分钟用户看不到反馈的问题,阿里随本次发布同步开源了Qwen-Live-Delivery-Plugin(SiliconANGLE),支持模型先快速交付一份初始草稿,再在后台持续迭代打磨并实时接收用户中途干预反馈。 - 网络安全与 CBRN 语料过滤:据《南华早报》与 ExplainX 报道,阿里在
Qwen4-Max训练阶段主动剥离了攻击性网络攻击(Offensive Cyberattack)语料,仅保留漏洞检测等防御性安全能力,并增加了针对生化放核(CBRN)风险的后训练拦截。
import os
from openai import OpenAI

# 使用 QwenCloud 新加坡国际站 OpenAI 兼容端点调用正式版 qwen4-max
client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1",
)

response = client.chat.completions.create(
    model="qwen4-max",  # 请在 11月25日 24:00 (UTC+8) 前从 qwen4-max-preview 切换至此 ID
    messages=[
        {"role": "system", "content": "你是一名资深系统架构师,请输出结构化交付方案。"},
        {"role": "user", "content": "设计一套多租户 AI 网关的熔断与缓存降级架构,附各阶段验收测试标准。"}
    ],
    reasoning_effort="high",        # 正式版默认 high(可选 low / high / xhigh,切勿与 thinking_budget 混用)
    max_completion_tokens=32768,    # 重要:必须留足思考 + 最终回答的合计 Token 空间(最高支持 262,144)
)

print(response.choices[0].message.content)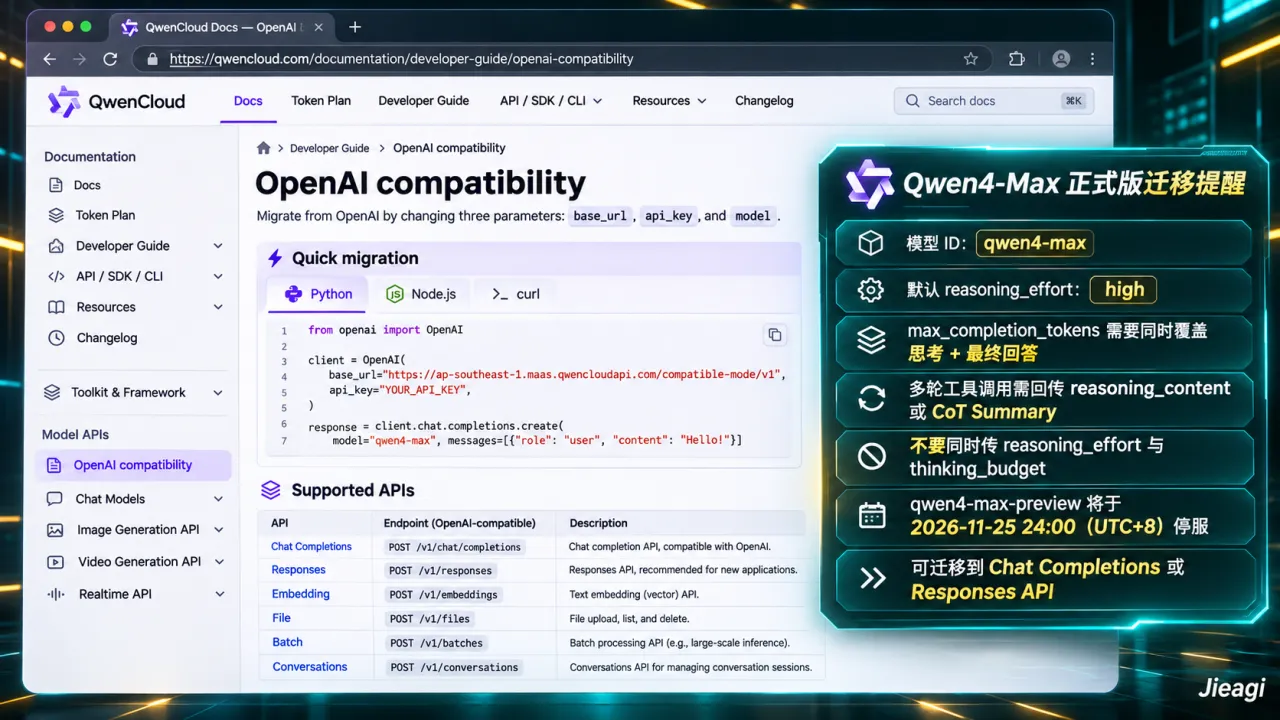
四、适用场景推荐与最终选型建议
综合官方 16 项基准、独立评测机构数据及 API 定价,我们给出明确的场景路由建议(更多多模型横评可参考 [内链:JetBrains 12款前沿大模型1200次盲测横评] 与 [内链:Claude Fable 5.2与Mythos 5.2全面评测与API迁移指南]):
- 强烈推荐切流至
Qwen4-Max的三大场景:- 法律合同审阅、专业咨询与 SaaS 办公流自动化:在 HLAB-Vals 法律基准(21.3 vs Opus 9.2)、APEX-Agents(72.1)与 AutomationBench-AA(72.5)上,
Qwen4-Max处于绝对第一梯队,且单任务成本仅为Claude Opus 5.5的约 1/3。 - PPT 幻灯片与 Excel 表格生成 Agent:结合 DesignArena 首日排名前五的表现及开源的
Qwen-Live-Delivery-Plugin,非常适合接入企业内部报告生成与数据看板助手。 - 高缓存命中率的仓库级代码补全与 PR 审查(DeepSWE 75.7):固定 System Prompt 与代码库上下文后,高达 95% 折扣的缓存读取价(
$0.075/M)能将平均输入成本压至$0.28/M以下。
- 法律合同审阅、专业咨询与 SaaS 办公流自动化:在 HLAB-Vals 法律基准(21.3 vs Opus 9.2)、APEX-Agents(72.1)与 AutomationBench-AA(72.5)上,
- 建议暂不切换、保留替代模型的场景:
- 重度终端命令行运维与自主 Shell 调试(Terminal-Bench 4.0):优先选用
Kimi K3.1 Pro(67.2 分) 或Claude Opus 5.5(59.6 分)。 - 黑盒软件复刻与复杂视觉图表/视频深度解析:
Claude Opus 5.5(ProgramBench 65.0)与GPT-6 Astra(Chartography 71.1 / Video-Index 76.7)仍保持明显代差优势。 - 必须私有化本地部署权重的涉密环境:由于
Qwen4-Max暂未开源权重,自托管团队目前仍应使用已开源权重的Qwen 3.8-Max或DeepSeek V4.1 Flash 1017。
- 重度终端命令行运维与自主 Shell 调试(Terminal-Bench 4.0):优先选用
常见问题
1. Qwen4-Max 正式版开源模型权重了吗?可以本地私有化部署吗?
没有开源。阿里巴巴此次发布的 Qwen4-Max 仅通过 QwenCloud / 阿里云百炼 API、Token Plan 订阅、自有应用(QwenWork、Qoder、QwenStudio)及 OpenRouter 提供云端调用。官方在发布公告中承诺后续会开源基于同代架构的小尺寸 Qwen 4 模型(如社区期待的 27B 级别),但截至 2026 年 11 月 17 日尚未公布具体型号与开源日期;如需本地部署千问旗舰权重,目前请使用 Qwen 3.8-Max 或 Qwen 3.8 27B。
2. 之前的预览版 qwen4-max-preview 还能用多久?升级到 qwen4-max 需要改什么代码?
qwen4-max-preview 仅在 Token Plan 中保留至 北京时间 2026 年 11 月 25 日 24:00(美东时间当日 11:00),随后将彻底下线停服。迁移至正式版 qwen4-max 时需注意三点:① 默认推理强度从预览版的 xhigh 改为了 high;② 思考 + 回答的合计最大输出上限从预览版文档的 393,216 调整为 262,144 tokens;③ max_tokens 会同时限制思考过程和最终答案,务必调大该参数以防回答被截断。
3. Qwen4-Max 按量付费(Pay-as-you-go)和 Token Plan 订阅怎么选更划算?
如果你是个人开发者在小团队中使用 Claude Code、Codex 或 OpenCode 写代码,Token Plan 订阅(Lite 首月活动价 $3/月含 20,000 Credits、Essential $5/月含 45,000 Credits、Standard $18/月、Pro $43/月支持 6–8 个并发 Agent)无需担心单次长思考爆账单;但如果你在开发面向外部客户的 SaaS 产品、需要按租户计量成本,或依赖 5 分钟/1 小时显式缓存降低长上下文开销,则应直接调用 QwenCloud 按量付费 API(新加坡区还赠送 100 万免费体验 Token)。
4. 为什么用 Qwen4-Max 跑红队渗透测试或漏洞利用脚本会被拒绝?
据《南华早报》与 ExplainX 报道,阿里在 Qwen4-Max 的预训练数据清洗与后训练对齐阶段,专门过滤了攻击性网络攻击(Offensive Cyber)语料并强化了 CBRN(生化放核)拦截,仅保留了代码漏洞检测与修复等防御性安全能力。
参考来源
[Qwen 4 Max: Specs, Benchmarks, Pricing, and How to Access It - Yotta Labs](https://www.yottalabs.ai/post/qwen-4-max-specs-benchmarks-pricing-how-to-access)(2026-11-16)
[Qwen4 Max Benchmarks vs Opus 5.5, GPT-6.1 and Kimi K3.1 - AgentsPulse](https://agentspulse.github.io/tutorials/qwen4-max-benchmarks/)(2026-11-16)
[Qwen4-Max Launch: Alibaba GA, API Pricing, and Cyber plus CBRN Guardrails - ExplainX](https://explainx.ai/blog/alibaba-qwen4-max-launch-api-cyber-cbrn-guardrails-november-2026)(2026-11-16)
[Alibaba launches Qwen4-Max with training, attention optimizations - SiliconANGLE](https://siliconangle.com/2026/11/16/alibaba-launches-qwen4-max-with-training-attention-optimizations/)(2026-11-16)
转载请注明出处:界智通 · https://www.jieagi.com/aizixun/645.html

关注 AI 前沿动态,分享模型、工具与实战教程。
暂无评论