
Gemini语音API今日停服5款模型:升级Gemini 3.8 Live与TTS教程
Google Gemini API于2026年11月17日正式关停gemini-3.1-flash-live-preview与gemini-3.1-flash-tts-preview等5款语音模型且无自动重定向。本文详解迁移至gemini-3.8-live与gemini-3.8-flash-tts的代码改造、WAV格式变更与避坑指南。
目录 · 18 节
- Gemini API 11 月 17 日关停 5 款语音模型迁移教程:升级 gemini-3.8-live 与 gemini-3.8-flash-tts 避坑指南
- 一、本教程能帮你解决什么问题与前置准备
- 前置环境要求
- 二、分步骤操作:Live API 与 TTS 接口代码迁移实战
- 步骤 1:改造 Live API 会话配置,平滑升级至 gemini-3.8-live
- 步骤 2:改造 TTS 语音合成代码,升级至 gemini-3.8-flash-tts / lite-tts
- 三、常见报错和解决方法(Troubleshooting)
- 报错 1:调用 gemini-3.8-live 时返回 400 INVALID_ARGUMENT: thinking_level is not supported 或 proactive_audio: false is not allowed
- 报错 2:升级 gemini-3.8-flash-tts 后,生成的音频开头有一声刺耳的“啪/爆音”,或者 Go/Python 音频解析器报错文件长度异常
- 报错 3:在 Python SDK(google-genai 2.31.0)的 GenerateContentConfig 中传入 response_format={"mime_type": "audio/mulaw"} 抛出字段校验错误
- 报错 4:枚举回调状态时写了 INTERRUPTED 导致 SDK 校验失败
- 四、费用估算、2027 年元旦涨价预警与使用建议
- 五、总结与同日 Gemini Gems 自动转 Skills 提醒
- 常见问题
- 1. 我们是在 Google Cloud Vertex AI 上调用 gemini-live-2.5-flash-native-audio,今天(11 月 17 日)也会停服吗?
- 2. gemini-3.8-flash-tts 和 gemini-3.8-flash-lite-tts 接口格式一样吗?该如何选择?
- 3. 为什么升级到 gemini-3.8-live 后,工具还没执行完模型就开始自顾自说话了?
- 参考来源
Gemini API 11 月 17 日关停 5 款语音模型迁移教程:升级 gemini-3.8-live 与 gemini-3.8-flash-tts 避坑指南
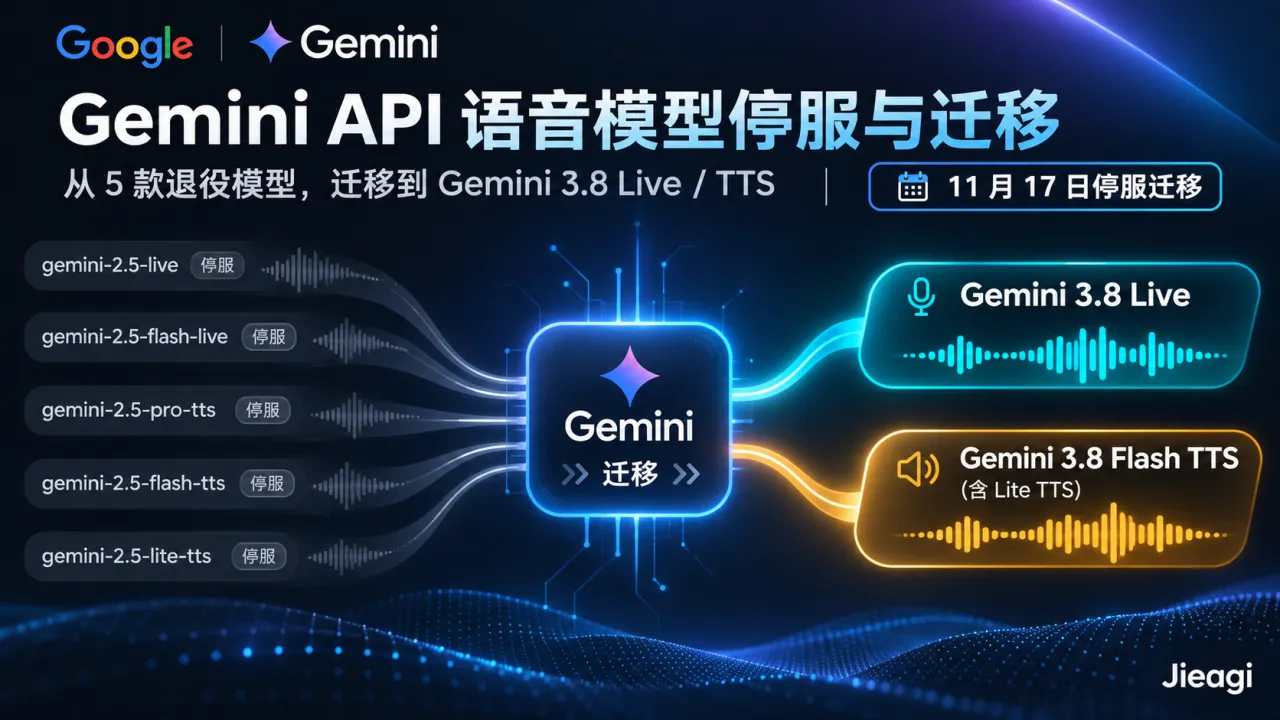
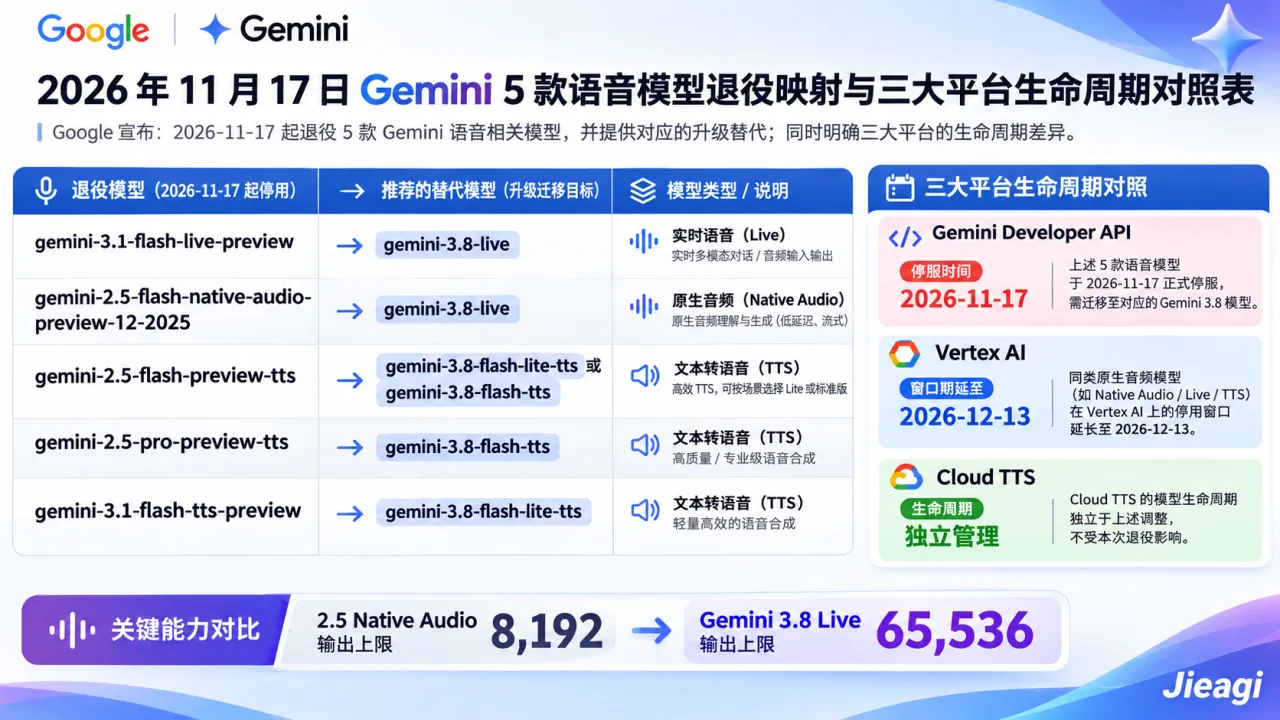
今天(2026 年 11 月 17 日),Google Gemini API(generativelanguage.googleapis.com) 正式迎来语音与实时音频产品线最大规模的一次停服切换:包括 gemini-3.1-flash-live-preview 与 gemini-2.5-flash-native-audio-preview-12-2025 在内的 2 款实时语音(Live API)模型,以及 gemini-2.5-flash-preview-tts、gemini-2.5-pro-preview-tts 与 gemini-3.1-flash-tts-preview 在内的 3 款语音合成(TTS)预览模型于今日同日关停(Developers Digest 迁移详解、goclaw GitHub Issue #1642)。
更关键的是,与此前 gemini-3.7-flash 自动路由至 3.8 不同,这 5 款语音模型关停后不提供任何自动重定向(Endpoint 直接关闭报错),且官方替代模型 gemini-3.8-live 与 gemini-3.8-flash-tts / gemini-3.8-flash-lite-tts 存在多处破坏性行为变更(Breaking Changes)——如果只改模型名称而不改配置与音频解析逻辑,线上服务会出现建连失败、把语气提示词直接念出来,或者生成带有双层 WAV 头的损坏音频文件!此外,Google Gemini 个人版也从今日(11 月 17 日)起正式开始将自定义的 Gems 自动迁移转换为 Skills(Notebookcheck)。本教程将手把手带你完成全套代码改造与成本核算。
一、本教程能帮你解决什么问题与前置准备
通过本教程(预计操作时间 15–20 分钟),你将完成:
- 准确区分 Gemini Developer API(AI Studio Key,今日 11 月 17 日停服)、Vertex AI(12 月 13 日停服) 与 Cloud Text-to-Speech 的生命周期差异。
- 将实时语音 WebSocket 会话安全迁移至
gemini-3.8-live,清理已废弃的thinking_config与enable_affective_dialog字段,并适配默认异步(NON_BLOCKING)工具调用。 - 将 TTS 语音合成代码迁移至
gemini-3.8-flash-tts或gemini-3.8-flash-lite-tts,将内联语气提示剥离至speech_metadata,并修复单次请求返回标准 RIFF WAV 导致的音频头冲突(若倾向于自建开源全双工语音方案,可参考[内链:开源32B全双工语音模型Sophon-Realtime v1部署教程])。
前置环境要求
- 账号与凭据:有效的 Google AI Studio API Key(环境变量
GEMINI_API_KEY) - SDK 版本要求:
- Python 环境:
pip install -U "google-genai>=2.31.0"(若需调用全新扩展音色库client.voices.list(),最低要求google-genai>=2.25.0) - Node.js / TypeScript 环境:
npm install @google/genai@^2.24.0
- Python 环境:
| 退役模型 ID(2026-11-17 停服) | 接口类型 | 官方指定替代模型 ID | 适用平台边界说明 |
|---|---|---|---|
gemini-3.1-flash-live-preview |
Live API | gemini-3.8-live |
Gemini API 今日停服;无自动重定向 |
gemini-2.5-flash-native-audio-preview-12-2025 |
Live API | gemini-3.8-live |
Gemini API 今日停服;Vertex AI 同类模型 gemini-live-2.5-flash-native-audio 延至 2026-12-13 停服 |
gemini-2.5-flash-preview-tts |
TTS | gemini-3.8-flash-lite-tts 或 gemini-3.8-flash-tts |
仅限 Gemini API;Cloud TTS 同名接口暂无停服期 |
gemini-2.5-pro-preview-tts |
TTS | gemini-3.8-flash-tts(高表现力旗舰) |
支持超 130 种语言、有声书与多角色对话 |
gemini-3.1-flash-tts-preview |
TTS | gemini-3.8-flash-lite-tts(高吞吐主力) |
支持超 100 种语言,适合语音 Agent 级联与高并发朗读 |
二、分步骤操作:Live API 与 TTS 接口代码迁移实战
步骤 1:改造 Live API 会话配置,平滑升级至 gemini-3.8-live
根据 Developers Digest 对 Google 官方文档的交叉核验,从 gemini-3.1-flash-live-preview 升级到 gemini-3.8-live 绝不是改个字符串那么简单,共有 6 项关键行为变更必须同步修改:
- 必须移除
thinking_level/thinking_config:gemini-3.8-live不支持thinking_level参数(如果你强行保留原 3.1 默认的minimal会报错;若确实需要深度思考,必须单独改用gemini-3.8-live-extended-thinking模型,且该模型仅接受low/medium/high并通过interaction_status判断空闲)。 - 必须移除
enable_affective_dialog与proactive_audio: false:在新版中,情感对话(Affective Dialogue)配置项已被移除,而主动音频(Proactive Audio)已变为永久默认开启——传入proactive_audio: false会直接返回错误! - 工具调用默认变为异步非阻塞(
NON_BLOCKING):在 3.1 Flash Live 中,模型调用工具后会暂停说话等待结果(Sequential);而在gemini-3.8-live中,默认模式翻转为behavior: "NON_BLOCKING"(模型边执行工具边继续说话)。对于支付、扣款、预订等必须拿到结果才能回答的工具,必须在函数声明中显式加上"behavior": "BLOCKING"! - 默认仅输出音频(Audio Only):如果你需要同时获取助手回复的文字转录稿,必须在
config中显式加上"output_audio_transcription": {}。
Live API 完整可运行迁移代码(Python,google-genai==2.31.0)
import asyncio
import os
from google import genai
from google.genai import types

# 依赖版本:pip install "google-genai>=2.31.0"
client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])

# 1. 切换为正式版模型 ID(输入上限 131,072 tokens,输出上限 65,536 tokens)
MODEL_ID = "gemini-3.8-live"

# 2. 声明工具:对必须等待执行结果才能回复的操作,显式声明 BLOCKING(覆盖默认的 NON_BLOCKING)
create_order_tool = {
    "name": "create_order",
    "description": "创建客户订单并返回订单号,必须在拿到结果后再向用户播报",
    "behavior": "BLOCKING",  # 关键!不加此项默认按异步 NON_BLOCKING 执行
    "parameters": {
        "type": "OBJECT",
        "properties": {
            "sku_id": {"type": "STRING"},
            "quantity": {"type": "INTEGER"}
        },
        "required": ["sku_id", "quantity"]
    }
}

# 3. 清理已废弃字段后的标准会话配置
live_config = {
    "response_modalities": ["AUDIO"],
    # 已移除 thinking_config、enable_affective_dialog 与 proactive_audio
    "output_audio_transcription": {},  # 显式开启输出音频的实时文本转录
    "tools": [{"function_declarations": [create_order_tool]}],
}

async def run_live_session():
    async with client.aio.live.connect(model=MODEL_ID, config=live_config) as session:
        print(f"Connected to {MODEL_ID} successfully!")
        # 发送一条带明确角色的用户消息;turn_complete=True 会无条件打断当前模型播报
        await session.send_client_content(
            turns=types.Content(
                role="user",
                parts=[types.Part(text="请帮我查询并下单 2 件 SKU-9001 商品。")]
            ),
            turn_complete=True
        )
        async for message in session.receive():
            if message.server_content and message.server_content.output_transcription:
                print("Transcript:", message.server_content.output_transcription.text)

if __name__ == "__main__":
    asyncio.run(run_live_session())
步骤 2:改造 TTS 语音合成代码,升级至 gemini-3.8-flash-tts / lite-tts
在 TTS 侧,从旧版 2.5 或 3.1 预览模型切换到 gemini-3.8-flash-tts(或高性价比的 gemini-3.8-flash-lite-tts)有两大必改代码点(Developers Digest、goclaw Issue #1642):
- 输入文本被严格当作“逐字逐句的台词(Verbatim Transcript)”:旧版允许你在正文里写
"Say cheerfully: 欢迎光临!"或"Speaker 1: 你好";但在 3.8 TTS 中,模型会把"Say cheerfully"直接大声念出来!你必须将语气风格移入speech_metadata.style,将多说话人标签移入speech_metadata.speaker(仅支持<laugh>、<sigh>、<short pause>等尖括号瞬时副语言标签)。 - 非流式(Unary)请求现在直接返回带标准 RIFF 头的 WAV 文件(24 kHz、单声道、16-bit),不再是无头裸 PCM(
audio/l16):如果你旧代码里自己用 Pythonwave模块或ffmpeg给返回字节包了一层 WAV Header,必须立即删掉那段封装代码,否则会写出双层 WAV 头导致播放器开头爆音或解析失败!(注:流式 Streaming 响应仍默认返回无头 PCM 分块)。
写法 A:cURL(REST API,支持直接指定电话语音 AUDIO_MULAW / 8000Hz)
目前 Python / JS SDK 的 GenerateContentConfig 尚未合入 response_format 采样率覆盖字段(google-genai 2.31.0 会报错拒绝),如需为呼叫中心输出 8kHz AUDIO_MULAW 格式,推荐使用 REST cURL 或 Interactions API:
curl -X POST "https://generativelanguage.googleapis.com/v1beta/models/gemini-3.8-flash-lite-tts:generateContent?key=${GEMINI_API_KEY}" \
  -H "Content-Type: application/json" \
  -d '{
    "contents": [{
      "role": "user",
      "parts": [{
        "text": "您好!您的订单已发货,<short pause> 预计明天下午送达。",
        "speech_metadata": {
          "style": "warm, professional customer service tone"
        }
      }]
    }],
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "voice": "Kore"
        }
      }
    }
  }'
写法 B:Python SDK 标准写法(直接落盘 WAV,无需二次封装 Header)
import os
from google import genai

# 依赖版本:pip install "google-genai>=2.31.0"
client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])

# 高质量有声书/多角色选 gemini-3.8-flash-tts;高并发客服选 gemini-3.8-flash-lite-tts
response = client.models.generate_content(
    model="gemini-3.8-flash-tts",
    contents=[{
        "role": "user",
        "parts": [{
            "text": "Have a wonderful day! <laugh> Everything is migrated.",
            # 关键改动 1:将语气指令放入 speech_metadata.style,切勿塞进 text 正文
            "speech_metadata": {"style": "cheerful and friendly"},
        }],
    }],
    config={
        "response_modalities": ["AUDIO"],
        "speech_config": {
            "voice_config": {"voice": "Kore"}
        },
    },
)

# 关键改动 2:3.8 TTS 非流式直接返回带 RIFF 头的完整 WAV(24kHz, mono, 16-bit)
# 直接写入 .wav 文件即可,切勿再用 wave.open() 手动添加 WAV 头!
audio_bytes = response.candidates[0].content.parts[0].inline_data.data
with open("output_3_8.wav", "wb") as f:
    f.write(audio_bytes)
print("Saved valid WAV file:", len(audio_bytes), "bytes")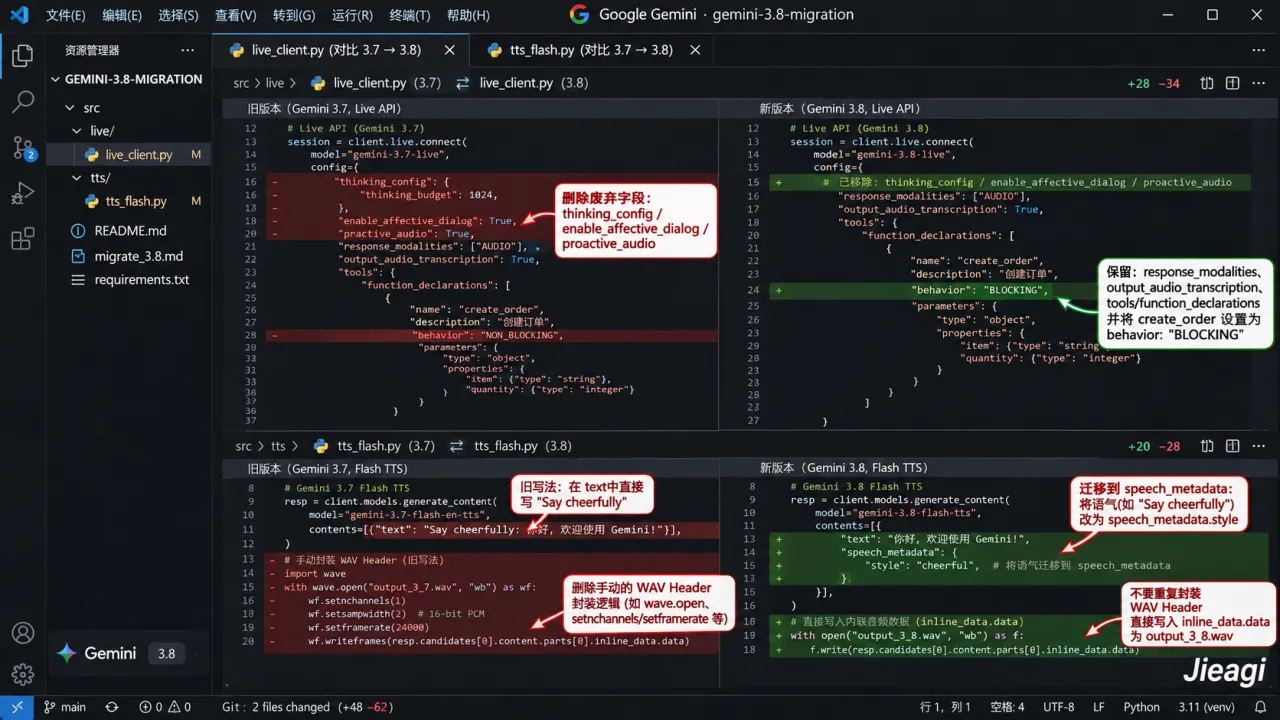
三、常见报错和解决方法(Troubleshooting)
报错 1:调用 gemini-3.8-live 时返回 400 INVALID_ARGUMENT: thinking_level is not supported 或 proactive_audio: false is not allowed
- 触发原因:沿用了
gemini-3.1-flash-live-preview的会话初始化字典。在gemini-3.8-live中,thinking_level与enable_affective_dialog已被移除,且主动音频永久开启(传proactive_audio: false会直接报错)。 - 解决方法:从
LiveConnectConfig中彻底删掉thinking_config、enable_affective_dialog和proactivity三个字段;如确需推理分级,请将模型 ID 更换为gemini-3.8-live-extended-thinking(仅支持low/medium/high)。
报错 2:升级 gemini-3.8-flash-tts 后,生成的音频开头有一声刺耳的“啪/爆音”,或者 Go/Python 音频解析器报错文件长度异常
- 触发原因:旧版 TTS 默认返回无头裸 PCM(
audio/l16),许多项目(如开源项目goclaw的wav.go)会在收到响应后手动拼接 44 字节的 RIFF WAV Header。而gemini-3.8-flash-tts的非流式(Unary)请求已经原生自带了 RIFF WAV Header,二次封装会导致文件拥有两个 WAV 头,前 44 字节的 Header 元数据被当作音频采样播放从而产生爆音(goclaw Issue #1642)。 - 解决方法:移除针对非流式 TTS 响应的手动 WAV 封装函数,直接将
inline_data.data作为完整的.wav文件消费或首先检查前 4 个字节是否为b"RIFF"。
报错 3:在 Python SDK(google-genai 2.31.0)的 GenerateContentConfig 中传入 response_format={"mime_type": "audio/mulaw"} 抛出字段校验错误
- 触发原因:虽然 Gemini 3.8 TTS 服务端已支持输出
AUDIO_L16、AUDIO_MULAW、AUDIO_ALAW及 8000Hz / 16000Hz 电话采样率,但截至google-genai 2.31.0,Python 与 JS SDK 的GenerateContentConfig尚未开放response_format字段。 - 解决方法:改用官方推荐的 Interactions API(调用
client.interactions.create(...)并传入response_format={"type": "audio", "mime_type": "audio/l16"}),或者直接通过 REST API 发起请求。
报错 4:枚举回调状态时写了 INTERRUPTED 导致 SDK 校验失败
- 触发原因:Google 官方文档存在一处拼写不一致——
3.8 Live模型介绍页将异步函数调度枚举写成了INTERRUPTED,但工具调用指南与google-genai 2.31.0SDK 源码中实际定义的合法枚举值是INTERRUPT(Developers Digest)。 - 解决方法:在代码中统一使用
"INTERRUPT"(配合"SILENT"与"WHEN_IDLE")。
四、费用估算、2027 年元旦涨价预警与使用建议
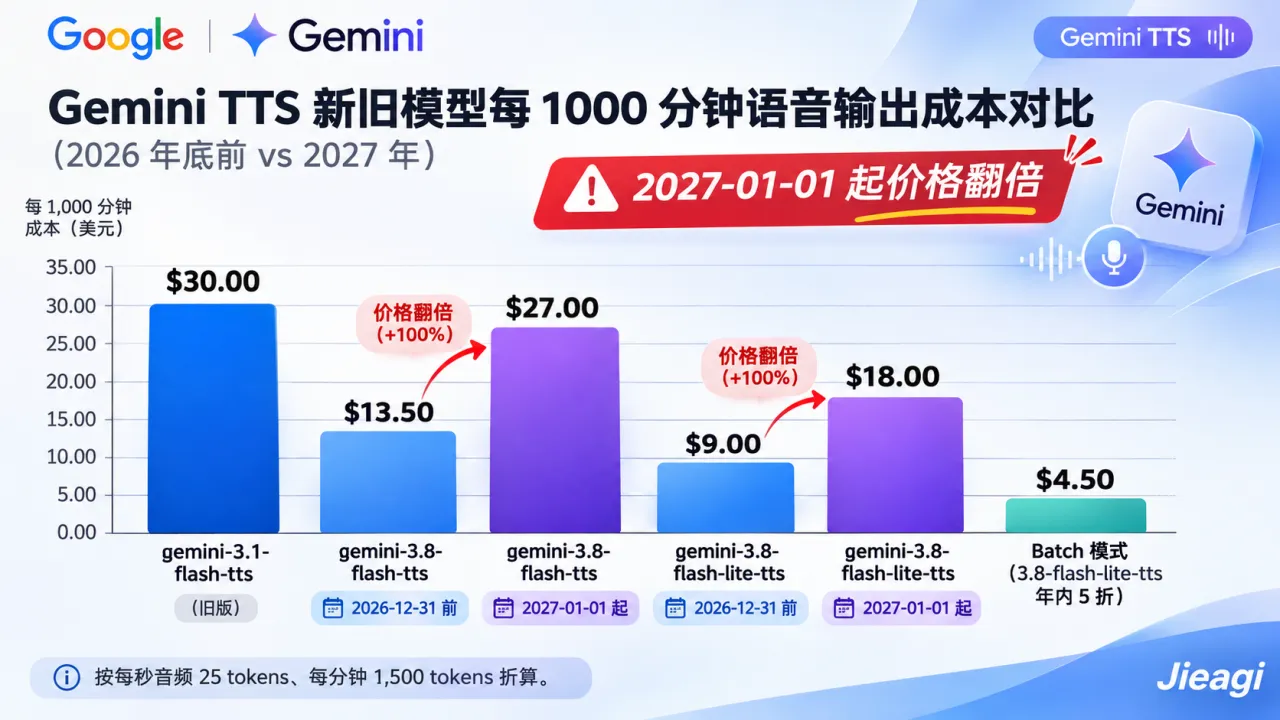
在做年度预算规划时,请务必注意 Google 定价页上的一项重要阶梯条款:gemini-3.8-flash-tts 与 gemini-3.8-flash-lite-tts 在 2026 年 12 月 31 日前享受年内优惠价,但从 2027 年 1 月 1 日起,输入与音频输出价格将直接翻倍(价格以官方最新公布为准,按官方每秒音频折算 25 Tokens、即每分钟 1,500 Tokens 计算,数据核实自 Developers Digest):
| 模型 ID | 文本输入单价(每 1M Tokens) | 音频输入单价(每 1M / 每分钟) | 文本输出单价(每 1M Tokens) | 音频输出单价(每 1M Tokens) | 折合每分钟音频输出成本 |
|---|---|---|---|---|---|
gemini-3.1-flash-live-preview(今日退役) |
$0.75 | $3.00($0.005/分) | $4.50 | $12.00 | $0.0180 / 分钟 |
gemini-3.8-live(正式替代) |
$0.75 | $3.00($0.005/分) | $4.50 | $12.00 | $0.0180 / 分钟(完全平替) |
gemini-2.5-flash-preview-tts(今日退役) |
$0.50 | — | — | $10.00 | $0.0150 / 分钟 |
gemini-2.5-pro / 3.1-flash-tts(今日退役) |
$1.00 | — | — | $20.00 | $0.0300 / 分钟 |
gemini-3.8-flash-tts(2026-12-31 前) |
$0.50 | — | — | $9.00 | $0.0135 / 分钟(Batch 减半) |
gemini-3.8-flash-tts(2027-01-01 起) |
$1.00 | — | — | $18.00 | $0.0270 / 分钟(仍比旧 Pro 便宜 10%) |
gemini-3.8-flash-lite-tts(2026-12-31 前) |
$0.50 | — | — | $6.00 | $0.0090 / 分钟(Batch 减半) |
gemini-3.8-flash-lite-tts(2027-01-01 起) |
$1.00 | — | — | $12.00 | $0.0180 / 分钟(比旧 3.1 便宜 40%) |
成本控制与使用建议:
- 视频流按需发送:
gemini-3.8-live的轮次覆盖策略默认为TURN_INCLUDES_AUDIO_ACTIVITY_AND_ALL_VIDEO(所有视频帧均计入上下文 Token 账单,单价 $1.00/M),切忌在无需画面理解时全天候推流摄像头帧。 - 善用 Batch / Flex 5 折通道与
Voice designID 复用:对于有声书、课程配音等非实时任务,启用 Batch 或 Flex 模式可直接砍半成本(年内3.8 Flash-Lite TTSBatch 仅需 $0.0045/分钟);同时不要在每次请求里塞入冗长的音色描述 Prompt(这不仅浪费输入 Token,还是导致音色漂移 Voice Drift 的主因),应使用 3.8 新增的Voice design生成固定voice_...ID(每个项目最多免费保存 200 个自定义音色,1 年未调用才过期)。
五、总结与同日 Gemini Gems 自动转 Skills 提醒
除了 API 侧的 5 款语音模型关停,今天(2026 年 11 月 17 日)也是 Google Gemini 消费端将自定义助手 Gems(自 2024 年 8 月推出)自动转换迁移为 Skills 的正式启动日(个人账号于 2026 年 11 月 17 日起自动迁移,需开启 Keep Activity 且年满 18 岁;Workspace 商业与企业账号将于 2027 年 3 月迁移,教育账号于 2027 年 6 月迁移,见 Notebookcheck)。建议开发团队今天立即全局搜索代码库中的上述 5 个旧模型字符串,按照本文清单完成配置清理与 WAV 音频头适配(全行业跨年弃用日历可查阅 [内链:2026年11月至2027年1月主流大模型API弃用与迁移全景指南])。
常见问题
1. 我们是在 Google Cloud Vertex AI 上调用 gemini-live-2.5-flash-native-audio,今天(11 月 17 日)也会停服吗?
不会今天停服,但只剩不到一个月窗口期。根据 Developers Digest 核实的生命周期表,11 月 17 日的停服仅适用于使用 AI Studio Key 调用的 Gemini Developer API(generativelanguage.googleapis.com)。Vertex AI 上的原生音频模型 ID 为 gemini-live-2.5-flash-native-audio,其停服日期定于 2026 年 12 月 13 日(而 Vertex 上的 gemini-3.8-live 将至少支持到 2027 年 9 月 25 日)。至于 Google Cloud Text-to-Speech 服务中的同名 gemini-3.1-flash-tts-preview,目前尚未列出退役日期。
2. gemini-3.8-flash-tts 和 gemini-3.8-flash-lite-tts 接口格式一样吗?该如何选择?
两者的请求与响应 Schema 100% 完全一致,切换只需修改 model 字符串。如果你的业务是有声书制作、播客旁白、多角色情感对话或需要方言表现力(支持超 130 种语言),选旗舰版 gemini-3.8-flash-tts;如果你的业务是高并发客服语音 Agent 级联、网页朗读或对首包延迟与成本敏感(支持超 100 种语言,音频输出便宜 33%),选 gemini-3.8-flash-lite-tts。
3. 为什么升级到 gemini-3.8-live 后,工具还没执行完模型就开始自顾自说话了?
因为 gemini-3.8-live 将工具调用的默认行为从顺序阻塞改为了异步非阻塞(behavior: "NON_BLOCKING")。如果某个工具(如查库、扣款、改预约)必须等拿到返回结果才能让模型开口回答,请在函数声明 JSON 中显式加上 "behavior": "BLOCKING"。
参考来源
[Gemini Live and TTS Preview Models Retire November 17: Moving to Gemini 3.8 Live and 3.8 Flash TTS - Developers Digest](https://www.developersdigest.tech/blog/gemini-live-tts-retirement-november-2026)(2026-10-18 / 2026-11-17 生效)
[Gemini TTS: default and selector models shut down on 2026-11-17 - goclaw GitHub Issue #1642](https://github.com/nextlevelbuilder/goclaw/issues/1642)(2026-10-28)
[Google Gemini starts turning your Gems into skills on November 17 - Notebookcheck](https://www.notebookcheck.net/Google-Gemini-starts-turning-your-Gems-into-skills-on-November-17.1411044.0.html)(2026-09-29 / 2026-11-17 生效)
[Gemini model deprecation: dates, replacements and a migration checklist - EvalShift](https://www.evalshift.dev/blog/gemini-model-deprecation-migration-checklist)(2026-10-21)
转载请注明出处:界智通 · https://www.jieagi.com/aizixun/646.html

关注 AI 前沿动态,分享模型、工具与实战教程。
暂无评论