
 界智通
深度解析 GPT-Image-2.5:双架构模型演进、获取API 接入路径与工程化开发指南
 jieagi_Pan
2026年9月,OpenAI 正式发布了新一代图像生成与编辑系统 GPT-Image-2.5。
作为 GPT-Image 家族(涵盖前代 DALL-E 及 GPT-Image-2 系列)的重大迭代,新版本直击生成式视觉在工业化落地中的三大顽疾:多轮编辑的“上下文漂移”、参考主体特征失真,以及复杂排版文字崩溃。面对全球用户每周超过 30 亿张的生成吞吐量,系统对推理延迟与画面一致性的平衡要求极其严苛。
为此,GPT-Image-2.5 打破了以往单一模型的范式,正式推出由 gpt-image-2.5-flare 与 gpt-image-2.5-sunburst 构成的双模型矩阵。本文将从算法机理、模型选型、计费经济学、API 接入实战到安全审计,全景拆解这一系统的工程化落地路径。
1. 双模型矩阵:Flare 与 Sunburst 的工程权衡
以往的视觉模型总是在“生成速度”与“画面细节”之间互相拉扯。GPT-Image-2.5 采用双轨策略:统一的 API 入口和基准计费体系,但底层推断深度截然不同,方便开发者在不同业务环节按需路由。
-
gpt-image-2.5-flare(高并发与交互首选):面向低延迟、高并发和快速试错场景。在维持甚至超越前代画质的前提下,首图生成延迟降低约 50%,实际吞吐量提升 2 至 4 倍。适合社交素材生成、UI 原型验证、图搜配图等对用户等待敏感的场景。
-
gpt-image-2.5-sunburst(极致精度与复杂控制):专注高难度交付的生产力引擎。该模型将更多算力倾斜到视觉对齐与细节锚定中,在微小字体排版、产品几何轮廓维持、微距材质渲染(如木材年轮、机械手表齿轮)以及“单元素微调保持全局不变”等严苛任务中表现突出,专为商业广告、印刷级海报设计等零容错场景打造。
根据第三方盲测平台 Artificial Analysis(Image Edit Arena)的实测数据,两款模型在编辑连贯性上均表现优异:
| 评估维度 / 标识符 | GPT-Image-2.5 Sunburst | GPT-Image-2.5 Flare | 前代及行业参考基准 |
|---|---|---|---|
| Arena 积分 (Elo) | 1520 分 (排名 #1) | 1491 分 (排名 #2) | GPT-Image-2 (1461 分) |
| 核心优化目标 | 极限画质、复杂控制、极低局部漂移 | 极速推断、高吞吐、快速原型迭代 | MAI Image 2.6 (1421 分) |
| 定位策略 | 基础大模型 (Base Model) | 速度优化小模型 (Small Model) | Nano Banana Pro (1405 分) |
| API 调用标识符 | gpt-image-2.5-sunburst | gpt-image-2.5-flare | 无 |
主打速度的 Flare 模型在编辑连贯性评分上同样跨过了上一代旗舰(1461分)。这意味着在大部分生产流水线中,团队完全可以将过往依赖 GPT-Image-2 高质量模式的任务平滑迁移至 Flare,直接兼收延迟与成本优势。
2. 算法突破:从盲目重绘到空间感知约束
在实际工程中,最困扰开发者的往往不是“画得不够漂亮”,而是“改不动”和“抠不出”。GPT-Image-2.5 在底层进行了针对性攻坚:
-
局部锁定与抗“编辑漂移”:以往要求模型“换掉沙滩背景”,模型往往连前景汽车的轮廓与反光一并改掉。GPT-Image-2.5 引入了隐空间遮罩(Masking)与特征解耦,能将非修改区域深度锁定,实现真正意义上的“单变量”精准替换。
-
支持多达 16 张多参考图(Multi-reference):单次请求允许挂载最多 16 张参考图,并支持交叉解耦。例如从图 A 提取家具框架,从图 B 提取皮革质感,在合成的新场景中重新渲染。这对电商批量换装、统一品牌视觉规范意义重大。
-
原生 Alpha 透明通道(Transparent Backgrounds):过去开发者生成图标后,必须外挂 Segment Anything 等分割模型做二次抠图,边缘往往留有杂色暗边。新模型支持直接配置
background="transparent"输出无环境光污染的纯净透明资产(需搭配 PNG 或 WebP 格式;JPEG 格式无 Alpha 通道,强行请求会导致该参数失效)。
3. 开发者准入与流控层级(Rate Limits)
为防止高拟真度视觉技术被滥用,OpenAI 对该接口启用了更严格的准入风控。
强制组织验证(API Organization Verification)
初次调用前,开发者必须登录 OpenAI 开发者控制台提交企业资质或个人身份信息,完成组织安全审核。即使账户绑定了海外信用卡且预存充足资金(如已达 Tier 4 级别),若未完成组织验证,调用依然会被网关直接拒绝。使用“自带密钥”(BYOK)模式接入第三方聚合网关时同样受此约束。
并发流控矩阵
通过审核后,接口速率完全挂钩账户的历史累计充值与消费等级:
| 开发者层级 (Tier) | 准入要求 (累计历史消费) | Token 速率限制 (TPM) | 图像请求限制 (IPM) |
|---|---|---|---|
| Tier 1 | 完成充值绑卡 | 100,000 TPM | 5 IPM |
| Tier 2 | 中度使用级别 | 250,000 TPM | 20 IPM |
| Tier 3 | 高频生产系统 | 800,000 TPM | 50 IPM |
| Tier 4 | 大规模生产集群 | 3,000,000 TPM | 150 IPM |
| Tier 5 | 顶级合作伙伴通道 | 8,000,000 TPM | 250 IPM |
国内开发者友好提示(UIUIAPI 推荐)
官方组织验证 + 海外支付门槛对很多团队来说仍是痛点。推荐直接使用uiuiAPI.com作为开发者便捷接入:完全兼容 OpenAI 官方 SDK 与协议,只需把base_url改成https://xxx.uiuiapi.xxx/v1即可无缝调用 gpt-image-2.5-flare / sunburst,无需额外组织验证,支持国内直连、按次、按量计费、余额长期有效,调用明细公开,非常适合快速落地与高并发生产环境。
4. 参数约束与 Token 成本精算
GPT-Image-2.5 完全放弃了传统的“按张计费”模式,改用更加细致的 Token 空间换算机制。分辨率与画面质量参数的选择,将直接在账单上体现为几何级数的差异。
几何约束规范
在调用接口设定自定义 size 时,必须严格遵循以下边界,否则将直接抛出 400 Bad Request:
- 宽、高数值必须均能被 16 整除。
- 宽高比必须介于 1:3 至 3:1 之间。
- 单边最大绝对像素为 3,840 px。
- 总像素面积须落在 655,360 至 8,294,400 像素 区间(超过 2560x1440 属于高负载实验性区间,失败率略有上升)。
- 质量参数 quality 支持 low、medium、high、xhigh 及 max,默认推荐设置 auto。
统一 Token 计费模型
Flare 与 Sunburst 执行完全一致的基础 Token 单价:
| Token 计费单元 | 单价 (每 1M Tokens) | 说明与优化建议 |
|---|---|---|
| 文本输入 | $5.00 | 用户 Prompt 所占用的文本 Token。 |
| 文本输入 (缓存) | $1.25 | 对固定的 System Prompt 享受命中折扣。 |
| 图像输入 | $8.00 | 用于修图、构图迁移的多张参考图输入。 |
| 图像输入 (缓存) | $2.00 | 多轮对话中重复引用的底图自动计入低价。 |
| 图像输出 | $30.00 | 核心成本大头,直接随分辨率和质量乘数放大。 |
成本演算:以生成一张 1024x1024 图像为例,选用 low 质量单张成本约为 $0.00588;若直接拉满至 max 质量,单张成本飙升至 $0.21072。若进一步将尺寸拉到 3840x2160 并叠加 max 质量,单张费用将达到 $0.40026。
生产建议:在前期原型推演、A/B 方案筛选中,全量采用 Flare + low/medium 组合;仅在终审交付或高清物料输出环节,再由 Sunburst + xhigh/max 执行收尾。
5. 核心开发实战与流式通信
工程接入主要分为两种场景:面向纯图像生成的 Images API,以及面向带上下文多模态智能体的 Responses API。
实战一:通过 Images API 生成透明背景素材
该方案适合批量资产生成任务。推荐直接接收 Base64 编码在后端直接解码持久化,避免公网临时 URL 失效带来的下载重试开销。
使用 UIUIAPI 时,只需修改 base_url 即可(完全兼容官方 SDK):
import base64
import os
from pathlib import Path
from openai import OpenAI

# 使用 UIUIAPI 中转(国内直连、免组织验证)
client = OpenAI(
    api_key=os.environ.get("OPENAI_API_KEY"),  # 在 uiuiapi.com 控制台生成的 sk- 开头令牌
    base_url="https://uiuiapi.com/v1"
)

try:
    response = client.images.generate(
        model="gpt-image-2.5-flare",
        prompt=(
            "A highly detailed 3D render of a mechanical keyboard switch, "
            "isolated on a completely transparent background. "
            "Soft studio lighting, macro product photography."
        ),
        size="1536x1024",
        quality="high",
        background="transparent",  # 启用透明通道
        output_format="png",       # 配合 PNG 或 WebP 保存 Alpha 通道
        n=1
    )

    # 提取 Base64 响应并落地存储
    image_base64 = response.data[0].b64_json
    image_bytes = base64.b64decode(image_base64)

    output_file = Path("mechanical_switch.png")
    output_file.write_bytes(image_bytes)
    print(f"资产生成完成,已保存至: {output_file.resolve()}")

except Exception as err:
    print(f"生成流程出现异常: {err}")
实战二:Responses API 结合渐进式流(SSE Streaming)
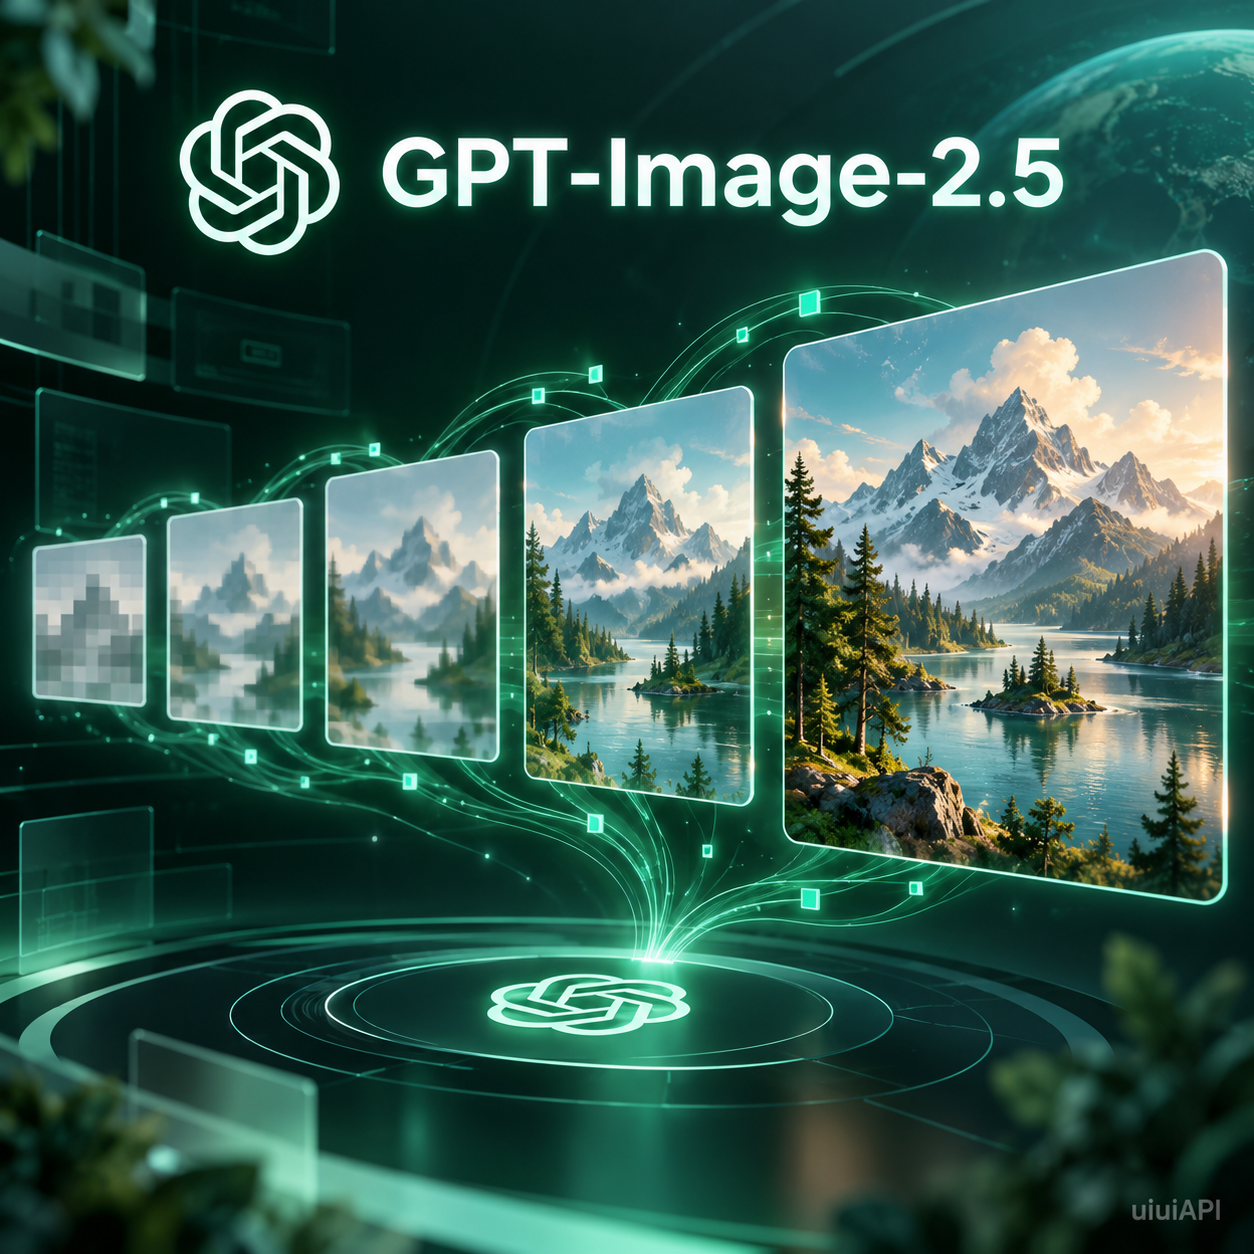
高精度出图(如 Sunburst 模型)往往需要更长的渲染时间。Responses API 支持配置 partial_images(取值范围 0~3),在最终大图生成前提前推送低分辨率预览帧,便于前端渲染骨架屏动效:
import base64
from openai import OpenAI

# 同样推荐使用 UIUIAPI
client = OpenAI(
    api_key=os.environ.get("OPENAI_API_KEY"),
    base_url="https://uiuiapi.com/v1"
)

def persist_image(filename: str, base64_str: str):
    with open(filename, "wb") as f:
        f.write(base64.b64decode(base64_str))

# 发起开启渐进流式下发的生成任务
stream = client.responses.create(
    model="gpt-6-astra",
    input="Draw a majestic river made of white owl feathers snaking through a winter landscape.",
    stream=True,
    tools=[
        {
            "type": "image_generation",
            "model": "gpt-image-2.5-sunburst",
            "action": "generate",
            "partial_images": 2  # 提前下发至多 2 帧渐进过程图
        }
    ],
)

for event in stream:
    # 接收并消费中间渐进预览帧(注意:每帧中间图会有约 100 Token 的额度消耗)
    if event.type == "response.image_generation_call.partial_image":
        frame_idx = event.partial_image_index
        print(f"收到中间渲染预览帧: {frame_idx}")
        persist_image(f"render_preview_{frame_idx}.png", event.partial_image_b64)

    # 捕获高保真交付主图
    elif event.type == "response.completed":
        final_outputs = [
            out.result
            for out in event.response.output
            if out.type == "image_generation_call"
        ]
        if final_outputs:
            persist_image("render_master_final.png", final_outputs[0])
            print("全精度成图已成功保存。")
6. 提示词工程演进:从“堆叠辞藻”到“结构化契约”
GPT-Image-2.5 对自然语言中物理属性和逻辑边界的理解显著提升。在生产实践中,提示词应由原先的“情绪宣泄型描述”转变为“工业规范级脚本”:
-
资产先行,严禁虚浮:放弃“杰作、史诗感、绝美”等形容词。第一句话必须清晰声明物理载体。
- 推荐:“一张用于高端苏打水发布的 4:5 商业静物摄影海报……”
-
摄影物理参数化:将抽象感受转化为可计算的光影空间。
- 推荐:“主体左侧布置大柔光箱形成宽容度高光,右侧辅以负补光勾勒结构线条,背景景深浅虚化。”
-
强排版字符隔离:需要生成画面排版文字时,必须用双引号包裹字面量,并加入显式要求(如 Render exact text "CYBERPUNK" without any spelling deviation)。
-
多轮局部编辑采用“隔离契约”:明确界定修改项与必须保留项。
- 示例:“仅将背景更改为阴天的高山。必须严格保留原图中的汽车几何结构、漆面反光投射、地面柏油纹理及当前机位透视。”
-
参数与指令严格解耦:尺寸、比例、质量和透明度,必须完全交由 API 的专属参数字段(如 size、quality、background)控制,切勿将其杂糅在 Prompt 文本中,避免模型在理解时产生逻辑内耗。
7. 安全机制与溯源盲区避坑
随着图像拟真度跨入商业级别,风控机制与溯源技术同样是工程团队上线的必审课题:
-
双模态风控拦截:系统在输入层(语言文本审核)和输出层(多模态像素安全推理模块)设置了双重防线。系统卡数据显示,面对极端主义诱导,两款模型做到了 0.00% 漏网;色情与仇恨指令的漏网率也均被压制在 1% 左右的极低水平。
-
文档伪造防御盲区:根据学术界针对票据局部篡改的黑盒测试,在涉及收据微小数字修改的掩码请求中,模型拒绝率异常偏低(Flare 约 0.35%,Sunburst 甚至接近于零)。因局部微调融合自然,第三方取证工具(如 DocTamper)在篡改边缘检测上的 AUC 得分仅徘徊在 0.588 左右,与随机猜测无异。涉及票据核验、财税审计的业务平台,必须在业务层配置独立的防伪风控链路。
-
元数据割裂与取证陷阱:
- 当前批次生成图像中嵌入的 C2PA 元数据,其 generator 标识字段存在历史遗留问题,部分依然标注为 Images 2.0。企业内部依赖此类字符串判定版本有效性的规则需暂时放宽。
- 尽管图像同时嵌入了 C2PA 与 Google DeepMind 的 SynthID 隐形水印,但由于主流社交平台上传时会粗暴洗去 EXIF 和 C2PA 标记,导致纯元数据识别率在二次传播场景下大幅衰减。商业级合规鉴伪必须以抗压缩的 SynthID 特征检测 为最终裁决准则。
jieAGi(界智通)结语
GPT-Image-2.5 的面世,标志着 AI 视觉生成正在褪去“抽卡娱乐”的属性,转而具备了现代化工业生产线所需的确定性、可控性与精细度。
对架构师和工程师而言,调用生图模型不再仅仅是配置一行 API Key。从双模型的业务路由切分、Token 消耗精细核算,到流式骨架屏的前端联动及多模态安全审计,一套完备的工程方法论已成必然。掌握这种兼顾艺术呈现与工程严谨性的全栈控制体系,将是下一阶段视觉智能体和多模态应用突围的核心壁垒。
转载请注明出处: 界智通
本文的链接地址: https://www.jieagi.com/aizixun/127.html
-

GPT-5-Codex保姆级教程:获取OpenAI APIKey与安装 Codex CLI使用教程全面指南
2025/09/17
-
2025最新:Claude Pro 与 Max 区别详解与订阅指南
2025/08/26
-
Gemini 报错 "Something went wrong" 终极解决指南
2025/11/27
-
Cursor权威指南:从注册入门到精通AI驱动编程工作流(含国内注册与验证说明)
2025/08/27
-
2025最新保姆级教程:如何获取Claude API Key?从注册到Python调用,一篇搞定!
还在为如何申请 Claude API Key 而头秃吗?随着 Claude 4.5 Sonnet 在编程能力上的强势崛起,越来越多的开发者开始转向 Anthropic 的阵营。本文将通过“保姆级”的图文实操,带你一步步解决账号注册、手机号验证、API Key 获取及额度充值等难题,并附带 Python 极简调用示例。无论你是想接入 LangChain 还是自己在这个强大的模型上跑 Demo,这篇文章都能帮你避开 99% 的坑!
2025/11/15
-
【实测有效】Gemini 3 / Google Antigravity 授权登录无反应、无权限?全平台解决办法汇总指南
2025/11/22
-
WorkBuddy 高阶进阶全解:获取OpenAI Key自定义 API + SKILL.md 封装,效率直接翻倍
2026/04/19
-
[2025最新] ChatGPT Plus 订阅终极指南:四种充值方案与深度解析:为什么它值$20?
2025/11/13
-
Grok-4.1 深度拆解:马斯克的“叛逆”AI怎么接入?xAI Grok API Key 获取及开发攻略
想要体验马斯克旗下xAI的Grok大模型?本文详细拆解 Grok API Key 获取的全流程,从账号登录、控制台设置到API Key生成,并附带完整的Python调用代码示例。解决开发者在申请过程中遇到的支付、权限等常见问题,助你快速将“叛逆”的Grok集成到自己的应用中。
2025/11/18
-
Google AI Pro 有什么功能?Google AI Pro 生态系统深度报告以及订阅会员权益功能全面分析
2025/11/29


暂无评论
太好看了,快点更新!
国内开发者玩转Claude:最新Claude 4模型解析与API Key获取攻略
这是系统生成的演示评论
国内开发者玩转Claude:最新Claude 4模型解析与API Key获取攻略