
 界智通
Mellum2.1 是什么?JetBrains 12B 开源编程模型、强化学习、Hugging Face 下载与本地部署教程
 jieagi_Pan
一、JetBrains 也开始认真做开源 Coding Agent 模型了
提到 JetBrains,大多数程序员首先想到的是 IntelliJ IDEA、PyCharm、WebStorm 和 GoLand。
作为长期深耕开发者工具的公司,JetBrains 对真实软件开发场景有着比较深入的理解。
现在,JetBrains 正将这种经验进一步应用到开源大语言模型中。
2026 年 10 月 8 日,JetBrains 发布新一代 Mellum2.1。
它并不是一个追求数千亿参数的超大型模型。
相反,JetBrains 选择了一条不同的路线:
让一个相对紧凑的开源模型真正学会在代码仓库中工作。
Mellum2.1 总参数约为 12B,单次推理激活约 2.5B 参数。
通过混合专家架构和强化学习训练,它希望在保持高响应速度的同时,完成真实的软件开发任务。
二、Mellum2.1 是什么?
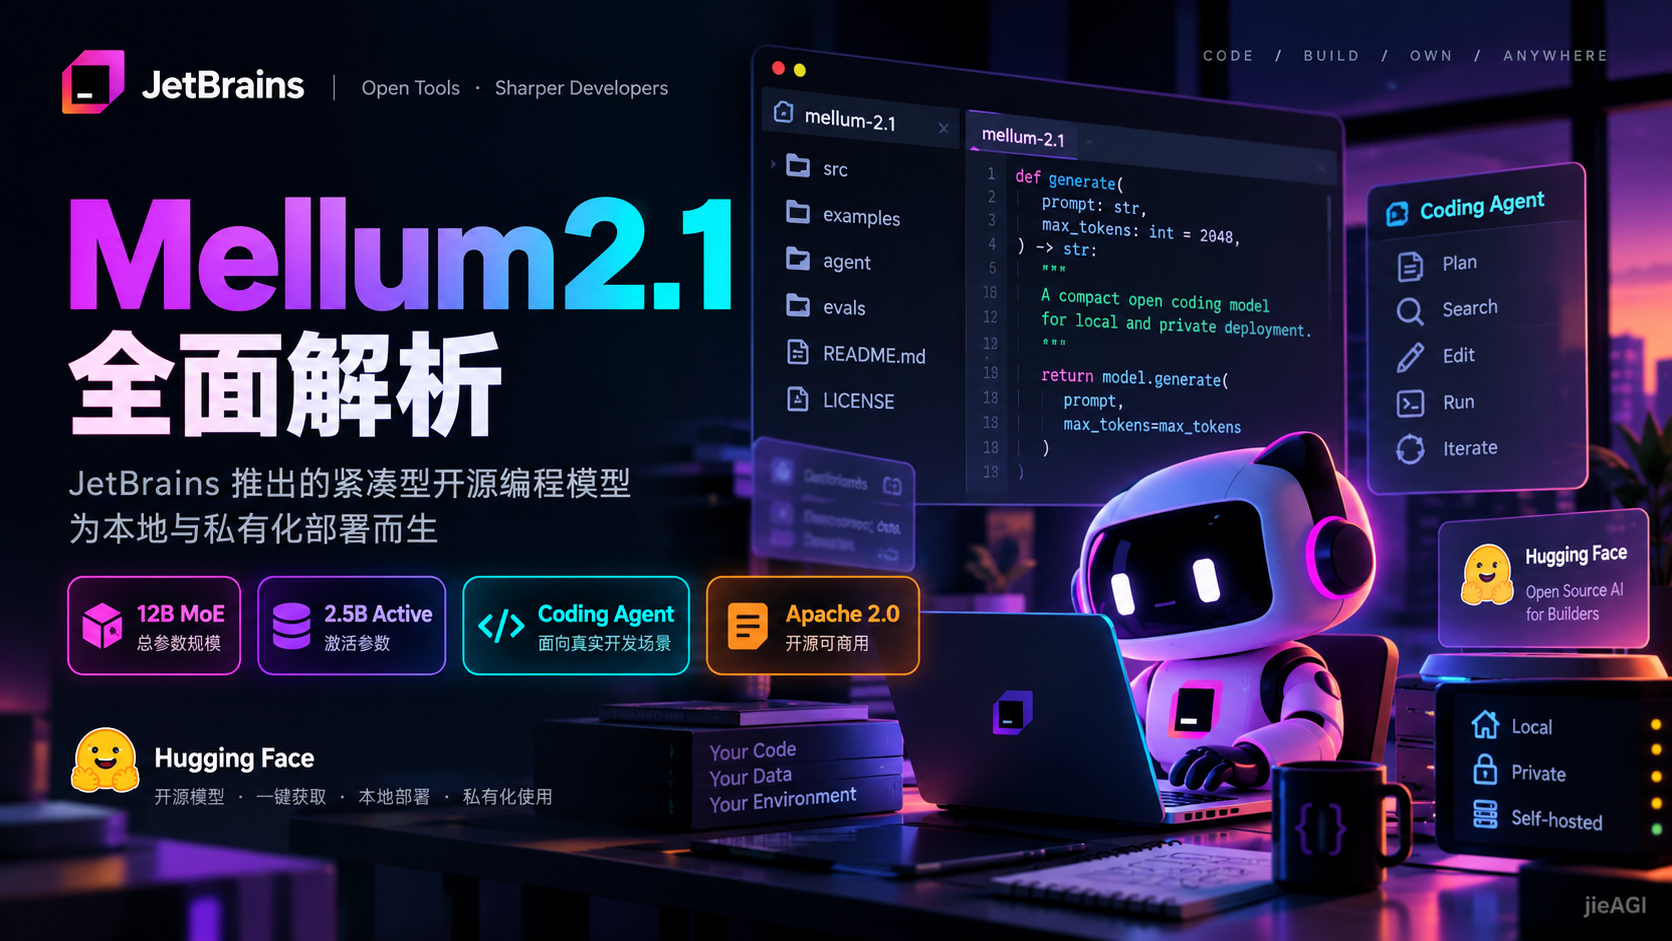
Mellum2.1 是 JetBrains 推出的开放权重语言模型,重点服务于 AI Coding 和 Agent 工作流。
它采用 MoE(Mixture of Experts,混合专家)架构。
其主要规格为:
| 项目 | 信息 |
|---|---|
| 模型名称 | Mellum2.1 |
| 开发团队 | JetBrains |
| 总参数量 | 12B |
| 激活参数量 | 约 2.5B |
| 架构 | MoE |
| 开源许可证 | Apache 2.0 |
| 核心方向 | Coding Agent、子 Agent、通用推理 |
| 发布渠道 | Hugging Face |
JetBrains 表示,Mellum2.1 与上一代 Mellum2 的主要架构保持一致。
真正变化最大的部分是:
后训练(Post-training)。
这意味着 JetBrains 不是简单增加模型参数,而是把更多工作投入到强化学习和真实软件任务训练中。
三、12B 总参数、2.5B 激活参数是什么意思?
很多开发者看到这组数字可能会感到困惑。
既然模型有 12B 参数,为什么单次只激活约 2.5B?
原因就在于 MoE 架构。
传统稠密模型通常会在推理过程中使用其主要网络参数。
MoE 则将一部分模型网络组织成多个专家模块。
当模型处理输入时,系统会选择部分专家参与计算。
可以将其简化理解为:
输入代码问题 → 路由器判断任务 → 选择相关专家 → 执行计算 → 输出结果。
因此,Mellum2.1 的特点是:
拥有较大的总参数容量,但单次推理不需要激活全部参数。
这有助于降低计算量,提高推理吞吐。
但这里有一个非常重要的区别:
激活参数少,不代表只需要存储 2.5B 参数。
部署模型时,仍然需要加载模型权重、管理缓存和运行框架资源。
因此不能直接按照普通 2.5B 稠密模型估算完整显存需求。
四、Mellum2.1 最大的升级:真实环境强化学习
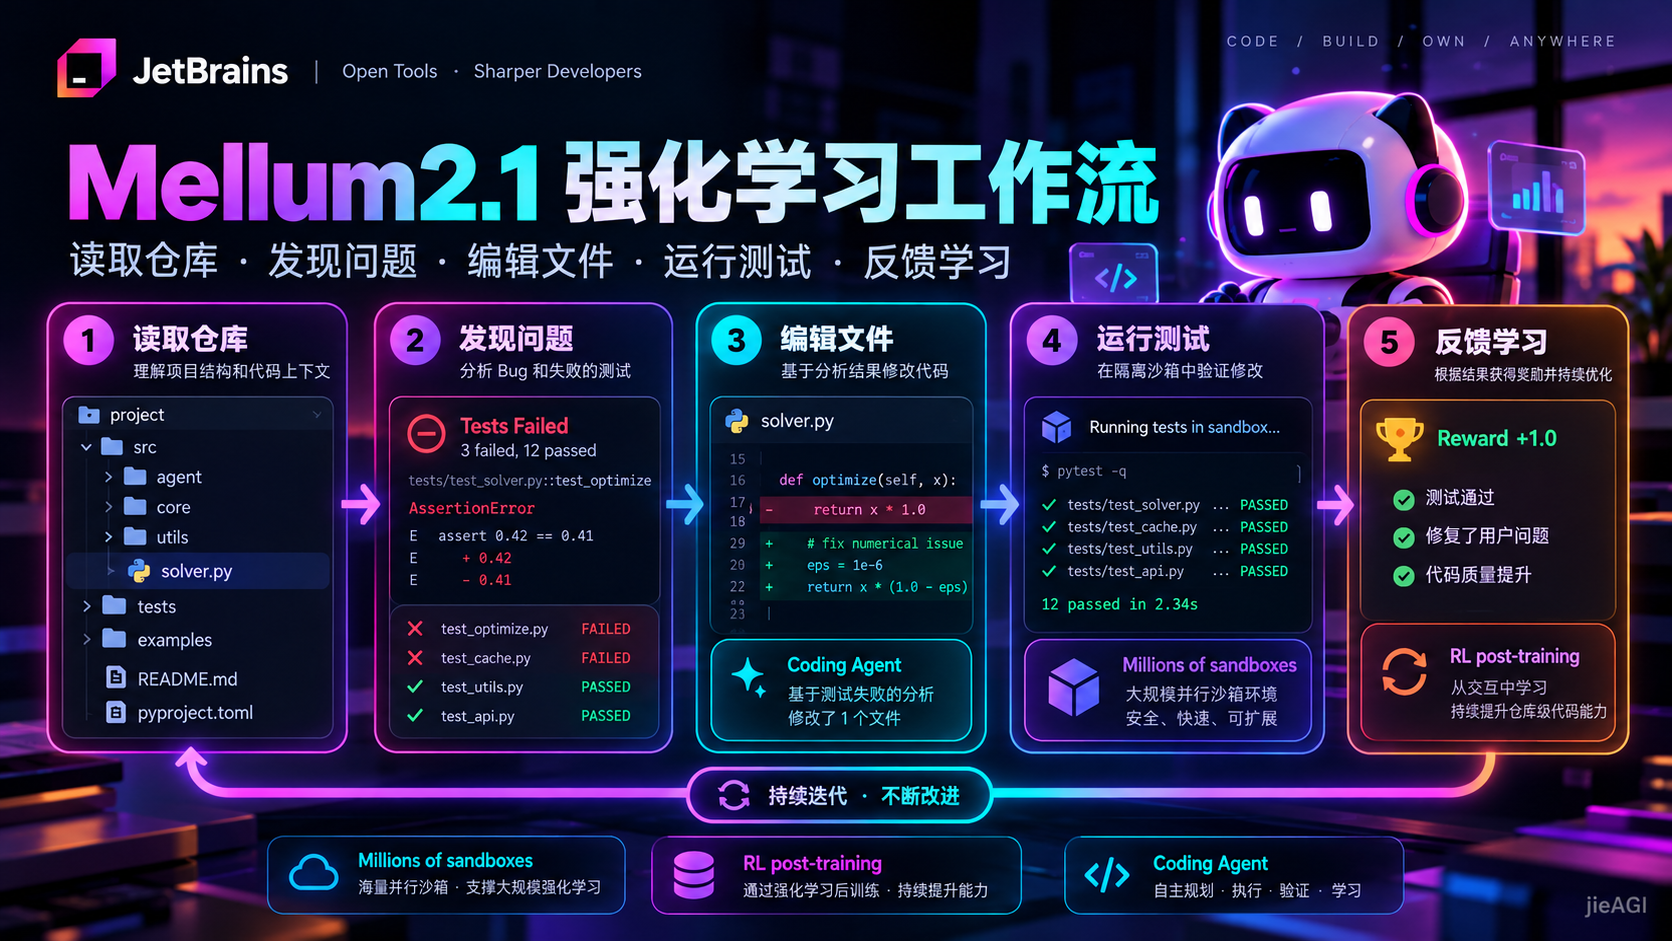
JetBrains 官方特别强调,这一版本最重要的变化是大规模强化学习训练。
相比只通过静态代码或问答数据训练模型,真实环境强化学习希望让模型学会:
- 探索代码仓库;
- 理解项目结构;
- 分析测试失败原因;
- 修改源文件;
- 执行验证;
- 根据反馈调整方案。
JetBrains 表示,其训练基础设施支持大量沙箱环境,并在训练过程中执行了数百万次沙箱运行。
这些环境包含数学、竞赛编程、科学、工具调用和真实软件工程任务。
这种训练方式更接近真实开发工作,而不是单纯预测下一段代码。
例如:
传统代码生成模型可能擅长回答:
“请写一个快速排序算法。”
而 Coding Agent 更需要解决:
“这个大型 Python 项目中有一个测试持续失败,请分析原因并修复,而且不要影响其他功能。”
这两类任务的难度与工作流程完全不同。
五、Mellum2.1 能够做哪些编程任务?
根据 JetBrains 官方介绍,Mellum2.1 主要针对真实 Coding Agent 场景进行了优化。
1. 代码仓库探索
阅读项目目录,了解模块关系,找到可能相关的源文件。
2. Bug 定位
结合测试失败日志,分析导致错误的代码路径。
3. 修改代码
在已有工程结构中修改函数或文件,而不只是从零生成代码。
4. 测试与验证
使用 Agent 工具运行测试,检查修改是否满足任务要求。
5. 子 Agent 执行
由更强的主模型负责规划,让 Mellum2.1 完成部分相对明确的开发任务。
需要注意,Mellum2.1 本身仍然是模型。
完整的“读文件、执行命令、运行测试”能力,需要结合支持工具调用的 Agent 框架与适当的执行环境。
不能认为单纯下载模型权重,就自动拥有了完整的 Coding Agent 产品。
六、Mellum2.1 和 Mellum2 有什么区别?
JetBrains 表示,新版本架构基本保持不变。
因此主要变化不是:
“12B 变成了 30B”。
而是模型在实际任务中的执行能力显著增强。
| 方向 | Mellum2 | Mellum2.1 |
|---|---|---|
| 模型架构 | MoE | MoE |
| 总参数 | 12B | 12B |
| 激活参数 | 约 2.5B | 约 2.5B |
| 核心训练特点 | 原有训练方案 | 更大规模强化学习 |
| 仓库级任务 | 能力较有限 | 明显增强 |
| Agent 定位 | 高速基础模型 | 实际开发任务与子 Agent |
这种升级路线说明:
未来开源 Coding 模型的竞争,不仅取决于模型大小,也取决于训练环境是否足够接近真实工程。
七、Mellum2.1 和 Qwen3.5-9B 谁更值得用?
JetBrains 官方使用统一评测配置,对 Mellum2.1、Mellum2、Qwen3.5-9B 与 Gemma 4 E4B 进行了对比。
官方表示,Mellum2.1 在 Agentic Coding 上取得了相对上一代最明显的进步。
在重负载吞吐评测中,其服务吞吐接近 Qwen3.5-9B 的两倍。
另外,在其 Multi-token Prediction 相关测试下,单请求速度约有 1.6 倍提升。
这些结论应理解为:
JetBrains 在指定硬件、配置与工作负载下得到的测试结果。
不能直接推断 Mellum2.1 在任何电脑、所有编程语言或所有项目中都比 Qwen 更快、更强。
对于个人开发者,更建议实测以下指标:
- 真实 Bug 修复成功率;
- 平均任务完成时间;
- 推理显存占用;
- 工具调用稳定性;
- 平均 Token 消耗;
- 多轮 Agent 任务成功率。
八、Mellum2.1 怎么下载?
官方提供 Hugging Face 模型集合:
https://huggingface.co/collections/JetBrains/mellum21
进入后可以查看当前公开的 Mellum2.1 权重和对应模型卡片。
建议优先阅读所选模型仓库中的 README,确认:
- 模型精确 ID;
- 推理推荐方式;
- Transformers 版本;
- 量化支持;
- Chat Template;
- Tool Calling 格式;
- 硬件需求。
不同权重变体的运行要求可能有所区别,不建议直接套用旧版 Mellum2 的全部推理参数。
安装基础依赖
可以先准备 Python 环境:
python -m venv .venvLinux/macOS:
source .venv/bin/activateWindows PowerShell:
.venv\Scripts\Activate.ps1然后安装:
pip install -U transformers accelerate torch safetensors huggingface_hubGPU 版本的 PyTorch 应根据操作系统、CUDA 驱动和显卡环境选择对应安装方式。
九、使用 Transformers 运行 Mellum2.1
以下是 Hugging Face 模型加载的通用示例。
需要强调,实际运行必须先确认所选权重支持的模型类与 Transformers 版本。
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

MODEL_ID = "替换为官方Mellum2.1模型仓库ID"

tokenizer = AutoTokenizer.from_pretrained(
    MODEL_ID,
    trust_remote_code=True
)

model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID,
    torch_dtype="auto",
    device_map="auto",
    trust_remote_code=True
)

messages = [
    {
        "role": "user",
        "content": (
            "Review this Python function and identify "
            "possible bugs:\n\n"
            "def divide(a, b):\n"
            "    return a / b"
        )
    }
]

inputs = tokenizer.apply_chat_template(
    messages,
    tokenize=True,
    add_generation_prompt=True,
    return_tensors="pt"
).to(model.device)

with torch.no_grad():
    output = model.generate(
        inputs,
        max_new_tokens=512
    )

print(
    tokenizer.decode(
        output[0][inputs.shape[-1]:],
        skip_special_tokens=True
    )
)
这是一个用于说明调用流程的通用示例,并非已针对特定 Mellum2.1 权重完成运行测试的脚本。
在实际部署时,还可能需要根据官方模型卡片调整模型加载类、精度设置、Chat Template 和信任远程代码配置。
对于不熟悉模型仓库实现的用户,不应在未经审查的情况下对任意第三方仓库启用 trust_remote_code=True。
十、Mellum2.1 支持 Ollama 吗?
截至本次 JetBrains 官方发布,GGUF 版本以及针对 llama.cpp、Ollama、LM Studio 的构建仍在准备中。
官方还计划提供用于 vLLM Speculative Decoding 的 Multi-token Prediction Head。
因此,不能把 Ollama 一键部署作为已经由官方保证支持的正式安装方式。
如果后续相关权重发布,开发者可以考虑使用量化模型降低部署门槛。
在当前阶段,更建议优先查看 Hugging Face 官方集合里的实际可用文件。
十一、本地部署需要多大显存?
由于 Mellum2.1 拥有 12B 总参数,显存计算不能只看 2.5B 激活参数。
单纯从权重体积估算:
| 权重格式 | 理论权重容量 |
|---|---|
| FP16/BF16 | 约 24GB |
| INT8 | 约 12GB |
| 4-bit | 约 6GB |
以上只是将 12B 参数按对应字节数进行的粗略估算。
实际推理还需要:
- KV Cache;
- 运行框架;
- 张量与路由缓存;
- 模型元数据;
- 上下文空间;
- 量化附加开销。
因此不能直接认为拥有 6GB 显存就能稳定运行 4-bit 的全部工作负载。
如果需要长上下文和多并发运行,还需要额外计算缓存开销。
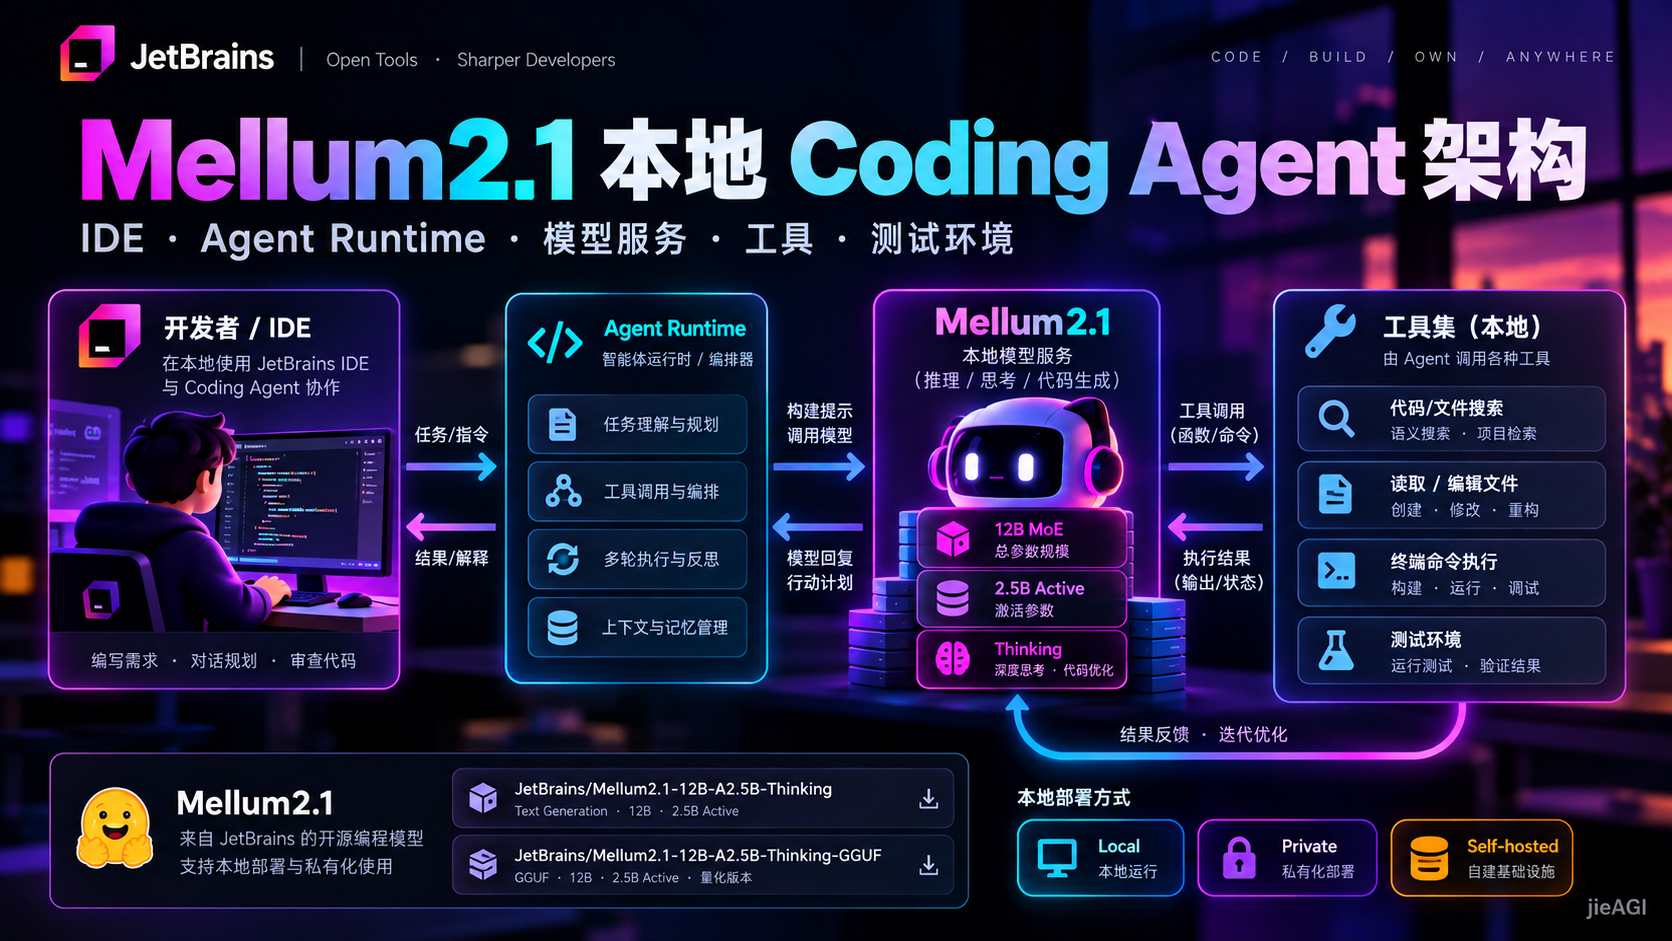
十二、如何把 Mellum2.1 接入 Coding Agent?
完整架构可以采用:
开发者输入任务 → Agent Runtime → Mellum2.1 → 文件搜索、读取、修改及终端工具 → 测试结果 → 模型再次分析。
这里需要几个重要组件:
第一,项目文件访问工具。
允许模型按权限读取项目文件。
第二,代码修改工具。
支持生成补丁或进行受控文件修改。
第三,命令执行沙箱。
测试命令应在安全边界明确的环境中运行。
第四,任务状态管理。
记录每一步执行结果,避免无效重复。
第五,自动化测试。
不能只看模型是否生成了代码,还要检查功能是否正确。
十三、哪些场景适合 Mellum2.1?
企业内网代码分析
适合希望把模型部署在自有基础设施、控制代码数据访问范围的团队。
私有 Coding Agent
开发者可以将其作为自建 Agent 的底层模型之一。
AI Gateway 的低成本模型池
对于有大量代码说明、简单修复或辅助分析需求的平台,可以评估将其部署为专门处理 Coding 子任务的模型服务。
多 Agent 架构
主模型负责规划,Mellum2.1 负责完成较明确的局部任务。
本地 AI 编程实验
适合希望研究 MoE 架构、工具调用和本地模型性能的开发者。
十四、Mellum2.1 能取代 Claude Code 或 Codex 吗?
需要区分模型与 Agent 产品。
Mellum2.1 是底层模型。
Claude Code 和 Codex 则涉及模型、工具系统、执行环境、上下文管理、权限机制及产品交互。
因此,两者不是完全相同层级的产品。
如果想让 Mellum2.1 实现类似 Codex 的体验,通常还需要完整的 Agent Harness。
例如:
- 文件访问;
- 项目索引;
- 命令运行;
- 补丁管理;
- 测试执行;
- 错误恢复;
- 权限审批。
对于成本敏感、私有部署和特定开发任务,Mellum2.1 有一定吸引力。
对于复杂跨仓库任务,仍然应通过实际评测选择合适模型。
十五、常见问题
Mellum2.1 是完全开源的吗?
JetBrains 已依据 Apache 2.0 许可证发布模型权重。具体使用仍应遵守模型仓库列出的许可文件和相关要求。
Mellum2.1 适合普通笔记本吗?
取决于设备内存、显卡、量化方式与可用推理框架。不能仅凭激活参数量得出结论。
现在能用 Ollama 一键运行吗?
官方发布时表示 GGUF 相关构建即将推出,是否现已可用需要查看模型仓库的最新文件。
Mellum2.1 只支持编程吗?
不是。JetBrains 还报告了其通用推理、数学和知识任务能力,但主要定位仍然围绕 Coding Agent。
Mellum2.1 支持商用吗?
Apache 2.0 是允许商业使用的宽松许可证,但部署和分发仍需遵循许可证义务。
十六、总结
Mellum2.1 的意义,不在于模型参数量有多大。
而在于 JetBrains 展示了一条值得关注的模型发展路线:
在紧凑的模型架构上,通过真实环境强化学习提升 Agent 执行能力。
对于开发者来说,未来 Coding 模型的竞争可能逐渐分为两个方向:
一个方向追求更强的复杂推理与大规模软件工程能力。
另一个方向追求更低成本、更高吞吐和更容易私有化部署的任务执行能力。
Mellum2.1 显然更加接近后者。
如果你正在构建本地 Coding Agent、企业内网开发助手或者多模型 API 网关,Mellum2.1 值得进入测试清单。
但在正式生产部署前,仍需要对模型兼容性、实际任务成功率、硬件成本和代码安全性进行完整评估。
版权信息: 本文由界智通(jieagi)团队编写,图片、文本保留所有权利。未经授权,不得转载或用于商业用途。
转载请注明出处: 界智通
本文的链接地址: https://www.jieagi.com/aizixun/137.html
-

GPT-5-Codex保姆级教程:获取OpenAI APIKey与安装 Codex CLI使用教程全面指南
2025/09/17
-
2025最新:Claude Pro 与 Max 区别详解与订阅指南
2025/08/26
-
Gemini 报错 "Something went wrong" 终极解决指南
2025/11/27
-
Cursor权威指南:从注册入门到精通AI驱动编程工作流(含国内注册与验证说明)
2025/08/27
-
2025最新保姆级教程:如何获取Claude API Key?从注册到Python调用,一篇搞定!
还在为如何申请 Claude API Key 而头秃吗?随着 Claude 4.5 Sonnet 在编程能力上的强势崛起,越来越多的开发者开始转向 Anthropic 的阵营。本文将通过“保姆级”的图文实操,带你一步步解决账号注册、手机号验证、API Key 获取及额度充值等难题,并附带 Python 极简调用示例。无论你是想接入 LangChain 还是自己在这个强大的模型上跑 Demo,这篇文章都能帮你避开 99% 的坑!
2025/11/15
-
【实测有效】Gemini 3 / Google Antigravity 授权登录无反应、无权限?全平台解决办法汇总指南
2025/11/22
-
WorkBuddy 高阶进阶全解:获取OpenAI Key自定义 API + SKILL.md 封装,效率直接翻倍
2026/04/19
-
[2025最新] ChatGPT Plus 订阅终极指南:四种充值方案与深度解析:为什么它值$20?
2025/11/13
-
Google AI Pro 有什么功能?Google AI Pro 生态系统深度报告以及订阅会员权益功能全面分析
2025/11/29
-
Grok-4.1 深度拆解:马斯克的“叛逆”AI怎么接入?xAI Grok API Key 获取及开发攻略
想要体验马斯克旗下xAI的Grok大模型?本文详细拆解 Grok API Key 获取的全流程,从账号登录、控制台设置到API Key生成,并附带完整的Python调用代码示例。解决开发者在申请过程中遇到的支付、权限等常见问题,助你快速将“叛逆”的Grok集成到自己的应用中。
2025/11/18


暂无评论
太好看了,快点更新!
国内开发者玩转Claude:最新Claude 4模型解析与API Key获取攻略
这是系统生成的演示评论
国内开发者玩转Claude:最新Claude 4模型解析与API Key获取攻略